3 сентября 2026 г.
Почему нельзя обрезать логи ИИ-агенту: экономия, которая удорожает задачи
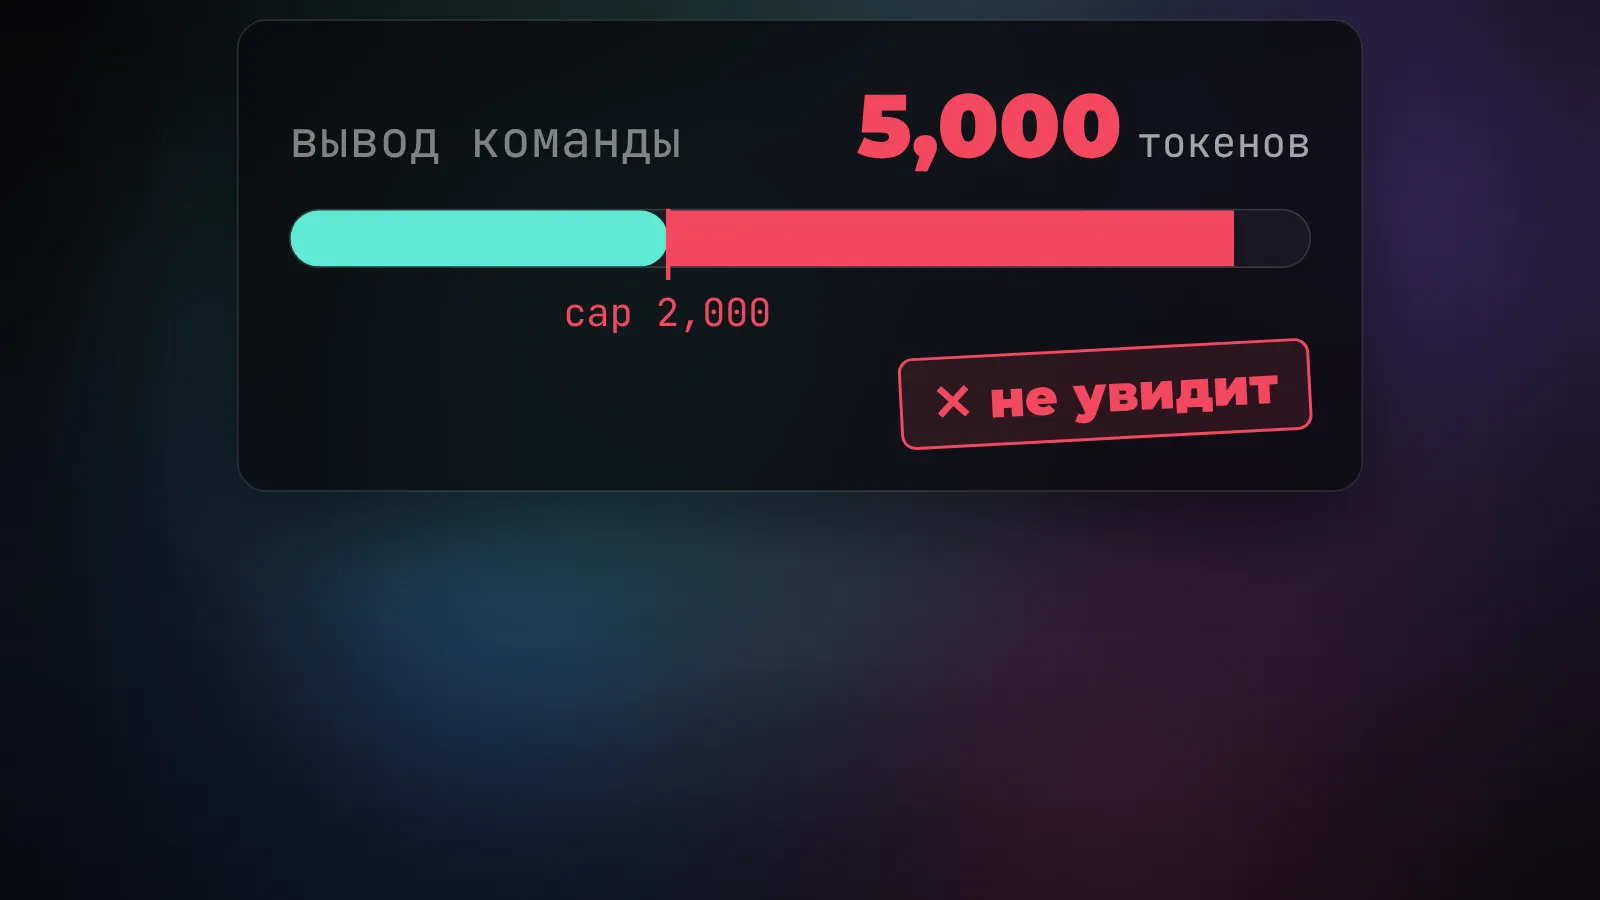

Инженеры GitHub прогнали популярный способ экономии на ИИ-агентах через контролируемый эксперимент и получили обратный результат: обрезка логов оборачивается перерасходом токенов. Агент, которому не показали полный вывод команды, идёт за информацией сам - перечитывает файл и перезапускает тест, и задача в итоге стоит дороже, чем без всякой экономии.
Разбор опубликовали 2 сентября инженеры GitHub Copilot. Они не ставили цель разоблачать чужой инструмент: сами хотели сэкономить на токенах, взяли для проверки самый популярный способ - и вытащили из эксперимента урок, который стоит проглотить каждому, у кого есть свой агент. Я прогнал их цифры и выводы - рассказываю, что там произошло и как экономить правильно.
Что проверяли: самый популярный инструмент экономии
Есть такой открытый проект - Rust Token Killer, RTK. Это CLI-прокси, который перехватывает вывод консольных команд до того, как его увидит модель, и ужимает его. Авторы заявляют экономию 60-90% токенов на обычных dev-командах, у проекта почти 78 тысяч звёзд на GitHub и целая экосистема: плагины для opencode, MCP-мосты для Claude Desktop и Cursor, производные оптимизаторы.
Идея на слуху и логичная: выводы тестов, сборки и поиска занимают в контексте агента больше места, чем весь остальной диалог. На них и режут. GitHub встроил похожее сжатие в своих агентов и прогнал через двухступенчатую проверку: офлайн-бенчмарки агентного кодинга плюс контролируемые онлайн-эксперименты на живых пользователях Copilot CLI.
Результат: агент не сдаётся, он переспрашивает
Укороченный вывод одного инструмента честно сокращает токены этого конкретного вызова. Но агент работает циклом, и на следующем шаге нехватка даёт о себе знать. Не найдя в урезанном логе нужной строчки, агент открывает исходный файл заново или перезапускает команду. Иногда несколько раз подряд.
Итог замеров GitHub: задачи в целом съедали больше токенов и решались дольше, а доля выполненных задач от обрезки не выросла. В самом разборе это сформулировано точно: токены сэкономлены локально и потрачены глобально.
Отсюда главный методический вывод, и он важнее любой конкретной цифры. Токены на вызов инструмента - неверная метрика. Мерить нужно стоимость выполненной задачи целиком, от первой команды до результата. Оптимизация, которая выглядит выигрышно в отчёте по одному вызову, спокойно может разорять тебя на уровне задачи.
Контекст гниёт - но резать живое нельзя
Здесь легко скатиться в противоположную крайность: раз обрезка вредит, тащим в контекст всё подряд. Тоже неправильно.
У длинного контекста есть своя болезнь. Anthropic в своём гайде по контекст-инжинирингу называет её context rot: чем больше токенов в окне, тем хуже модель достаёт из него детали. Причина архитектурная - трансформер строит попарные связи между всеми токенами, и с ростом контекста эти связи растягиваются. Ещё в 2023 году работа «Lost in the Middle» показала: информацию из середины длинного контекста модели вытаскивают заметно хуже, чем из начала или конца.
Но рекомендации Anthropic аккуратнее, чем «резать всё подряд». Чистить старое можно и нужно: например, убирать результаты инструментов из глубины истории там называют одним из самых безопасных видов компакции - агент, который уже отработал с этим выводом, редко возвращается к нему. А вот агрессивная компакция свежего опасна: теряется «малозаметный, но критичный контекст, важность которого выясняется только позже». Это ровно та яма, в которую угодили с RTK.
Граница проходит не между «жать» и «не жать», а между старым мусором и живой информацией.
Четыре оптимизации, которые сработали
Что же делать вместо тотальной обрезки? GitHub выпустил четыре изменения, и каждое прошло через онлайн-эксперимент.
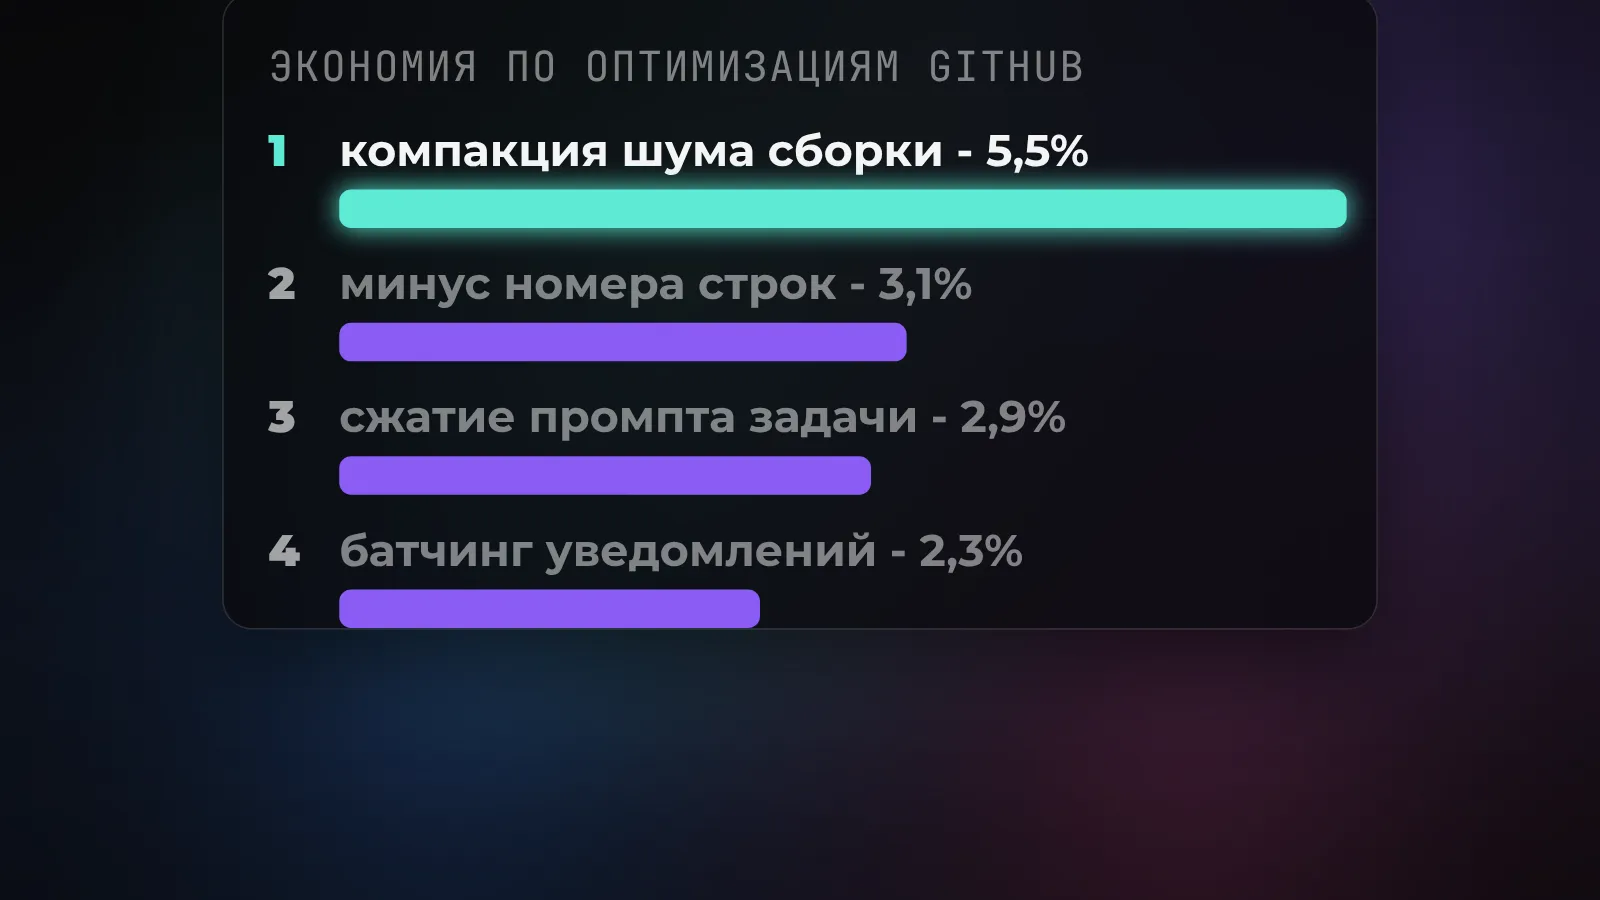
Минус номера строк из вывода инструментов чтения. Префиксы с номерами строк - легаси-форматирование, которое современным инструментам редактирования больше не нужно, а токены оно ест. Убрали: около 3,1% экономии на дневной стоимости инференса на пользователя, без регрессий в качестве. В код-ревью это ещё и минус 5% промпт-токенов на обзор.
Селективная компакция выводов. Политика из трёх частей: похожее на исходный код (cat, git diff, git show) не трогать вообще; результаты поиска переупаковывать, не теряя ни одного совпадения; жать только повторяющийся шум установки, сборки и линтеров, и только когда экономия существенна. Это дало 5,5%. Показательная деталь: ранняя версия жала ещё и git diff - агенты тут же бросились перечитывать оригиналы, фильтр откатили. Путь к полному оригиналу оставили как страховку; обращались к ней, по словам команды, крайне редко.
Сжатие промпта инструмента задач через мета-промпт. Модель переписывала собственный промпт этого инструмента и ужала его примерно вдвое: минус 1300 промпт-токенов на ход, 2,9% стоимости на активный час. В первом же онлайн-эксперименте вскрылась регрессия, которую офлайн-оценки пропустили: параллельные агенты начали выполняться по очереди. Починили, выкинув allow- и deny-списки и заменив их одной фразой: «Независимые агенты могут работать параллельно; учитывай побочные эффекты».
Батчинг уведомлений. Раньше уведомление о завершении подзадачи не несло результата, и модель тратила отдельный ход только чтобы его забрать. Обвязка научилась собирать завершения пачкой: четыре вызова модели на пару «команда плюс подагент» превратились в один. Это ещё 2,3%.
Отдельной строкой: более ранний перенос код-ревью на общие файловые инструменты с дообучением инструкций дал минус 20% стоимости ревью. Заметь, всё это не сделало модель умнее - она та же. Просто ей перестали создавать лишнюю работу.
Правило: оптимизируй задачу, а не вызов
Если сжать весь разбор GitHub до одного правила, оно звучит так: единица измерения оптимизации - выполненная задача, а не отдельный вызов инструмента.
Из этого правила вытекают остальные. Оптимизируй оркестрацию - когда что вызывается и как ходят результаты между шагами, - а не только текст, который генерирует модель. Жми по смыслу вывода: исходники и ошибки неприкосновенны, повторяющийся шум сжимаем. Переписанный промпт меняет поведение непредсказуемо, поэтому тестируй не только метрики стоимости, но и сами паттерны поведения - историю с внезапной сериализацией параллельных агентов офлайн-бенчмарки проспали. И последнее: выводы любого такого эксперимента привязаны к ворклоуду. У GitHub ужесточённые инструкции по файловому инструменту помогли код-ревью и одновременно удорожили CLI - фичу просто не выпустили. Твой пайплайн покажет свои числа.
Про то, что обвязка вокруг модели часто важнее самой модели, я уже писал - этот разбор ещё одно подтверждение: четыре выигрыша получены на уровне системы, а не модели.
Как применить к своему агенту
Конкретные шаги, если у тебя свой агент на Claude Code, opencode или самописный.
Вывод упавших тестов и стек-трейсы не урезай никогда. Если очень хочется сэкономить - режь вывод успешных прогонов, там действительно почти всё шум.
Шум установки и сборки можно жать, но всегда держи путь к оригиналу. Не «выбросил», а «свернул»: агент должен иметь возможность развернуть полный вывод, если что-то пойдёт не так.
Выноси состояние в файлы, а не в контекст. Anthropic показывает это на агенте, который тысячи шагов играл в Pokémon: прогресс он держал в собственных заметках и после сброса контекста просто перечитывал их. Заметки на диске переживают любую компакцию, строчки в контексте - нет.
Мерь стоимость задачи целиком. Логируй токены на сессию, а не на вызов, и сравнивай до и после изменения на своём реальном ворклоуде, а не на сферическом бенчмарке.
И если у тебя несколько моделей и пайплайнов - начни с маршрутизации задач на дешёвую модель там, где она справляется. Роутинг экономит на самой дорогой строке счёта, и, в отличие от обрезки логов, информацию у модели не отнимает. Как это устроено, разбирал тут, а про честное сжатие системного промпта через гист-токены - тут.
Источники
- GitHub Blog: How we make AI coding more cost-efficient without sacrificing task quality - основной разбор со всеми цифрами (02.09.2026)
- rtk-ai/rtk на GitHub - Rust Token Killer, инструмент, чью идею проверяли
- Anthropic: Effective context engineering for AI agents - context rot, компакция, заметки вместо контекста
- Liu et al.: Lost in the Middle (arXiv 2307.03172) - почему длинный контекст сам по себе вредит точности