21 августа 2026 г.
Гистинг: как сжать промпт ИИ-агента в 4 раза и не потерять качество

Гистинг - это способ сжать системный промпт ИИ-агента: длинную инструкцию на тысячи токенов заменяют горсткой специально обученных «гист-токенов». Shopify так ужала промпт своего агента с 6000 токенов до 1500 - вчетверо - и получила ответы на 38% быстрее при том же качестве. Модель ведёт себя так, будто прочитала всю инструкцию, хотя видит короткую заглушку.
Звучит как узкая инженерная деталь, но за ней прячется штука, которая касается всех, кто строит на моделях хоть что-то серьёзнее чата. Длинный системный промпт - это налог, который ты платишь на каждом запросе. Разберём, откуда он берётся, как Shopify научилась его почти обнулять и что из этого реально применимо у тебя.
Откуда берётся налог на длинный промпт
Любой агент начинается с системного промпта. Это инструкция, которую модель читает перед каждым ответом: кто она, что умеет, каким тоном отвечает, какими инструментами пользуется, чего делать нельзя. У серьёзного агента такой промпт легко разрастается до нескольких тысяч токенов - у агента Shopify по имени Sidekick он весил около 6000.
И вот подвох: эти токены модель обрабатывает заново на каждом запросе. Мало того, что за них капает плата на входе. Хуже другое - когда модель генерирует ответ, каждый новый токен ответа заставляет её ещё раз прочитать всю память по запросу из видеопамяти. Чем длиннее контекст, тем этот прогон тяжелее, и растёт он линейно вместе с длиной промпта. То есть шеститысячный промпт замедляет не только старт ответа, но и каждую его букву.
На одном запросе это незаметно. Но когда агент крутится в проде и обрабатывает сотни обращений в минуту, длинный промпт превращается в лишние секунды задержки и лишние видеокарты в стойке.
Что такое гист-токен
Идея гистинга простая на словах: раз системный промпт на каждом запросе один и тот же, зачем скармливать его модели целиком? Давай заменим всю эту простыню несколькими новыми токенами, которые несут в себе тот же смысл.
Гист-токен - это специальный токен, которого не было в словаре модели. Его добавляют искусственно, и у него есть обучаемое представление - вектор чисел, который и хранит спрессованный смысл куска инструкции. Shopify подобрала соотношение четыре к одному: один гист-токен на каждые четыре токена исходного промпта. Шесть тысяч токенов ужались до полутора - и модель отвечала ровно так же, как раньше.
Важно, что это не пересказ инструкции своими словами и не выкидывание лишнего. Гист-токены вообще не текст - их нельзя прочитать глазами. Это выученные векторы, которые для самой модели значат то же, что и полный промпт.
Как модель учится сжимать
Тут начинается самое интересное - как эти волшебные токены получают. Через дистилляцию: одну модель заставляют повторить поведение другой.
Работает это так. Берут учебный прогон и пропускают его через модель дважды. Первый прогон - учительский: модель видит полный промпт на 6000 токенов и выдаёт свой ответ. Второй прогон - ученический: тот же самый пример, но вместо длинного промпта подставлены короткие гист-токены. Дальше сравнивают, насколько разошлись предсказания в этих двух прогонах, и подкручивают векторы гист-токенов так, чтобы ученик отвечал всё ближе к учителю.
Само обучение не бесплатное, но и не космос. У Shopify нашлись способы его ускорить: если заранее посчитать ответы учителя и заготовить данные, полный прогон ужимается с тридцати часов до шести. А ещё оказалось, что стартовать гист-токены не со случайных чисел, а с усреднённых кусков исходного промпта - это одно снижает начальную ошибку в семь раз. Мелочи, из которых складывается разница между «красивой идеей» и работающим приёмом.
Когда обучение закончено, готовые векторы просто вписывают в таблицу представлений модели. Дальше она грузится и работает как обычно - никаких особых режимов, костылей в механизме внимания или отдельного пути на сервере. На запуске меняется ровно одно: вместо длинного промпта модели подсовывают строку гист-токенов.
Что получила Shopify в цифрах
Абстрактная экономия токенов - это красиво, но давай про измеримое. Shopify выкатила гистинг на свой боевой агент Sidekick и померила на нагрузке в 350 запросов в минуту.
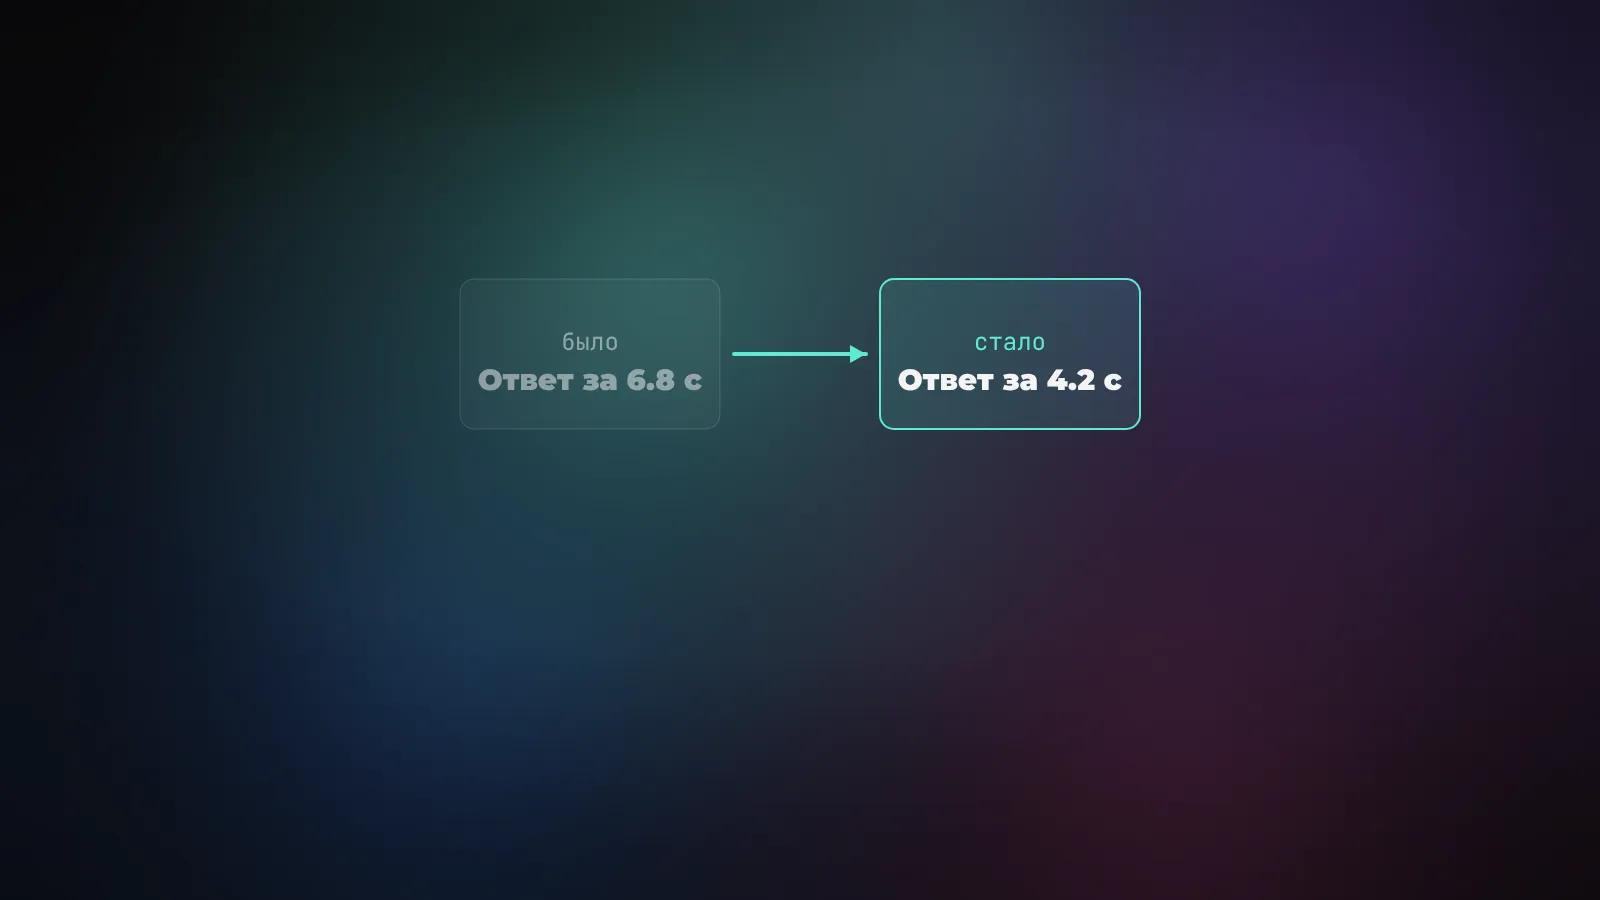
Время до первого токена упало с 438 до 354 миллисекунд. Полное время ответа - с 6.8 до 4.2 секунды, это минус 38%. Пропускная способность выросла с 20.2 до 23.4 запроса в секунду. А главная цифра для тех, кто считает деньги: та же нагрузка стала держаться на меньшем парке видеокарт.
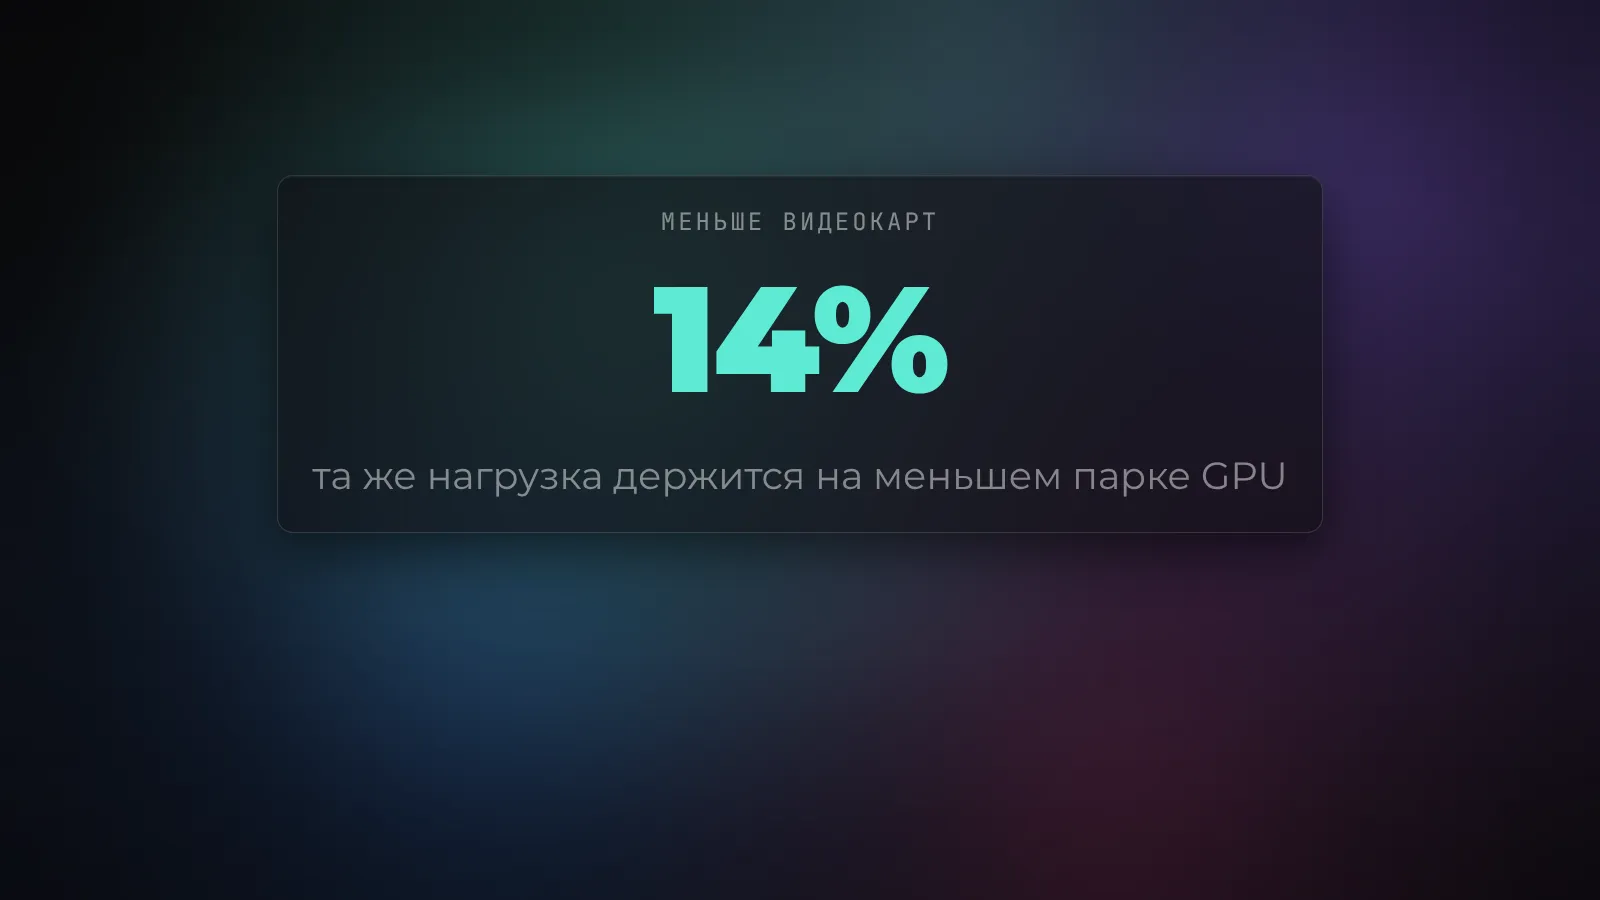
Минус 14% GPU - это прямая экономия на железе, которая идёт каждый месяц, а не разово. И всё это без просадки качества ответов: агент отвечает так же точно, как на полном промпте.
Чем гистинг не является
Легко перепутать гистинг с двумя соседними приёмами, но это разные вещи.
Первое - это не суммаризация истории диалога. Когда переписка с моделью разрастается, часто старые сообщения схлопывают в короткое резюме, чтобы влезть в окно контекста. Гистинг про другое: он жмёт статичную часть - системный промпт, который на всех запросах одинаковый. Историю он не трогает.
Второе - это не кэширование промпта. Кэш префикса помогает не пересчитывать одинаковое начало запроса заново, и это хорошая штука. Но кэш не спасает от главной боли: даже закэшированный контекст модель всё равно перечитывает из памяти на каждом сгенерированном токене, и чем он длиннее, тем дороже генерация. Гистинг же реально укорачивает контекст, а не прячет его в кэш. Одно другому не мешает - их можно и нужно сочетать.
Сам приём, кстати, не новый. Ещё в 2023-м вышла работа «Learning to Compress Prompts with Gist Tokens» от исследователей из Стэнфорда - там показали, что промпт можно сжимать в десятки раз почти без потерь. Заслуга Shopify в том, что они дотащили это до прода и померили на реальной нагрузке.
Что это значит для тебя
Честно скажу сразу: обучить гист-токены на Claude или GPT ты не сможешь - у них закрытые веса, а гистинг требует лезть внутрь модели. Так что если твой агент живёт на облачном API, прямо этот трюк тебе недоступен. Но выводы из него - вполне.
Первое и самое дешёвое - следи за длиной системного промпта. Каждая лишняя тысяча токенов инструкции замедляет каждый ответ и капает в счёт на каждом запросе. Выкинь из промпта воду, дубли и инструкции, которые давно не нужны. Тот же эффект, только руками.
Второе - включай кэширование промпта, если провайдер его поддерживает. Это не заменит гистинг, но срежет часть платы за одинаковое начало запросов, и включается оно почти в одну строчку.
Общий смысл простой. Раньше борьба за скорость и цену агента шла в основном за выбор модели подешевле. Гистинг показывает другую сторону той же медали: огромный кусок расходов сидит не в модели, а в том, сколько ты ей скармливаешь на каждом запросе. И этот кусок можно ужимать - где-то руками через короткий промпт и кэш, а где-то и по-взрослому, обучив модель понимать твою инструкцию с полуслова.