25 августа 2026 г.
Умный роутер сам выбирает нейросеть под задачу - и берёт не самую мощную

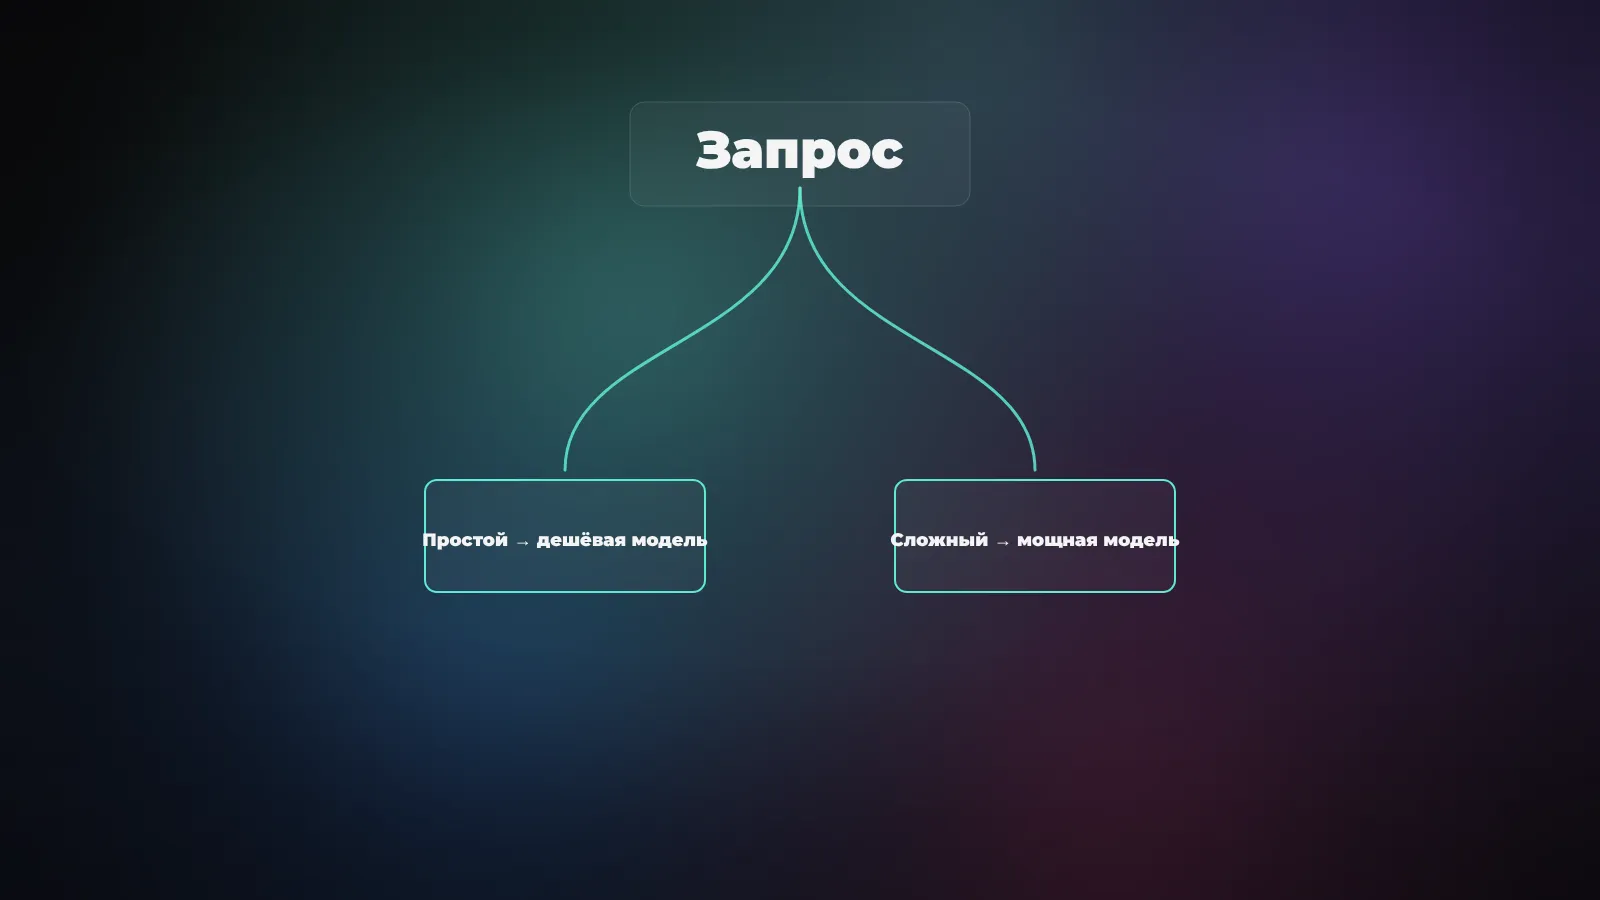
Роутер моделей - это классификатор, который смотрит на каждый твой запрос и сам решает, какой нейросети его отдать: простую задачу уводит на дешёвую и быструю модель, сложную - на самую мощную. Cursor обучил такой на 600 тысячах реальных запросов и говорит, что счёт за токены падает до 60%, а качество остаётся на уровне флагмана. Смысл простой: не всё нужно решать самой дорогой моделью.
На днях Cursor разобрал в блоге, как эта штука устроена внутри, и это тот редкий случай, когда компания показывает не маркетинговую картинку, а реальную механику принятия решения. Разберём по-человечески: что за роутер, как он отличает простую задачу от сложной, сколько на этом реально экономится и зачем эта идея тебе, даже если ты не сидишь в Cursor.
Что вообще такое роутер моделей
Обычно ты сам выбираешь модель. Открыл чат или редактор кода, ткнул в списке «хочу Opus» или «хочу Sonnet» - и все запросы до конца сессии летят в неё. Даже если ты попросил переименовать переменную или сделать git-коммит, за это отвечает та же тяжёлая модель, что и за сложный рефакторинг. Ты платишь по флагманскому тарифу за задачу, которую вытянула бы модель в десять раз дешевле.
Роутер убирает этот выбор из твоих рук. Между тобой и моделями встаёт лёгкий классификатор: он читает запрос, прикидывает, насколько тот сложный, и сам отправляет его в подходящую модель. Простое - на дешёвую и быструю, сложное - на мощную. Ты вроде как работаешь с «Авто», а под капотом каждый твой запрос может уходить в разные нейросети.
Ключевая мысль, которую Cursor выносит прямым текстом: единой лучшей модели на все случаи нет. Одна сильнее в отладке, другая в планировании, третья дёшево и быстро закрывает рутину. Роутер и нужен, чтобы под каждый тип задачи подбирать своего исполнителя, а не гонять всё через одного дорогого универсала.
Как роутер понимает, что задача простая
Внутри у Cursor это два шага. Сначала работает модуль под названием Compass - предсказатель сложности. Он ставит запросу непрерывную оценку от 0 до 1: насколько велик шанс, что задачу нормально вытянет дешёвая модель. Если задача явно простая, дальше можно не думать - её сразу отдают экономичной модели.
Если Compass видит, что задача тяжёлая, включается второй шаг - маршрутизатор по типу задачи. Он уже выбирает, какая именно из мощных моделей лучше справится с этим конкретным видом работы: отладка, планирование, работа с базой, визуальная вёрстка. Решение принимается не по одному слову в запросе, а по набору сигналов: тип задачи, свежие вызовы инструментов, общий контекст текущей работы и состояние разговора.
Насколько Compass точен - Cursor приводит цифры. Запросы, которым он поставил высший шанс на успех, в 96% случаев действительно получали положительный сигнал по качеству. У запросов с самой низкой оценкой этот показатель падал до 71%. То есть предсказатель не идеален, но разделяет «простое» и «сложное» заметно лучше монетки.
Почему не всегда берут самую мощную модель
Тут ломается интуиция. Кажется, что раз есть флагман - логично всё гнать через него, качество же выше. Но качество и стоит по-другому, и не на каждой задаче это качество вообще заметно.
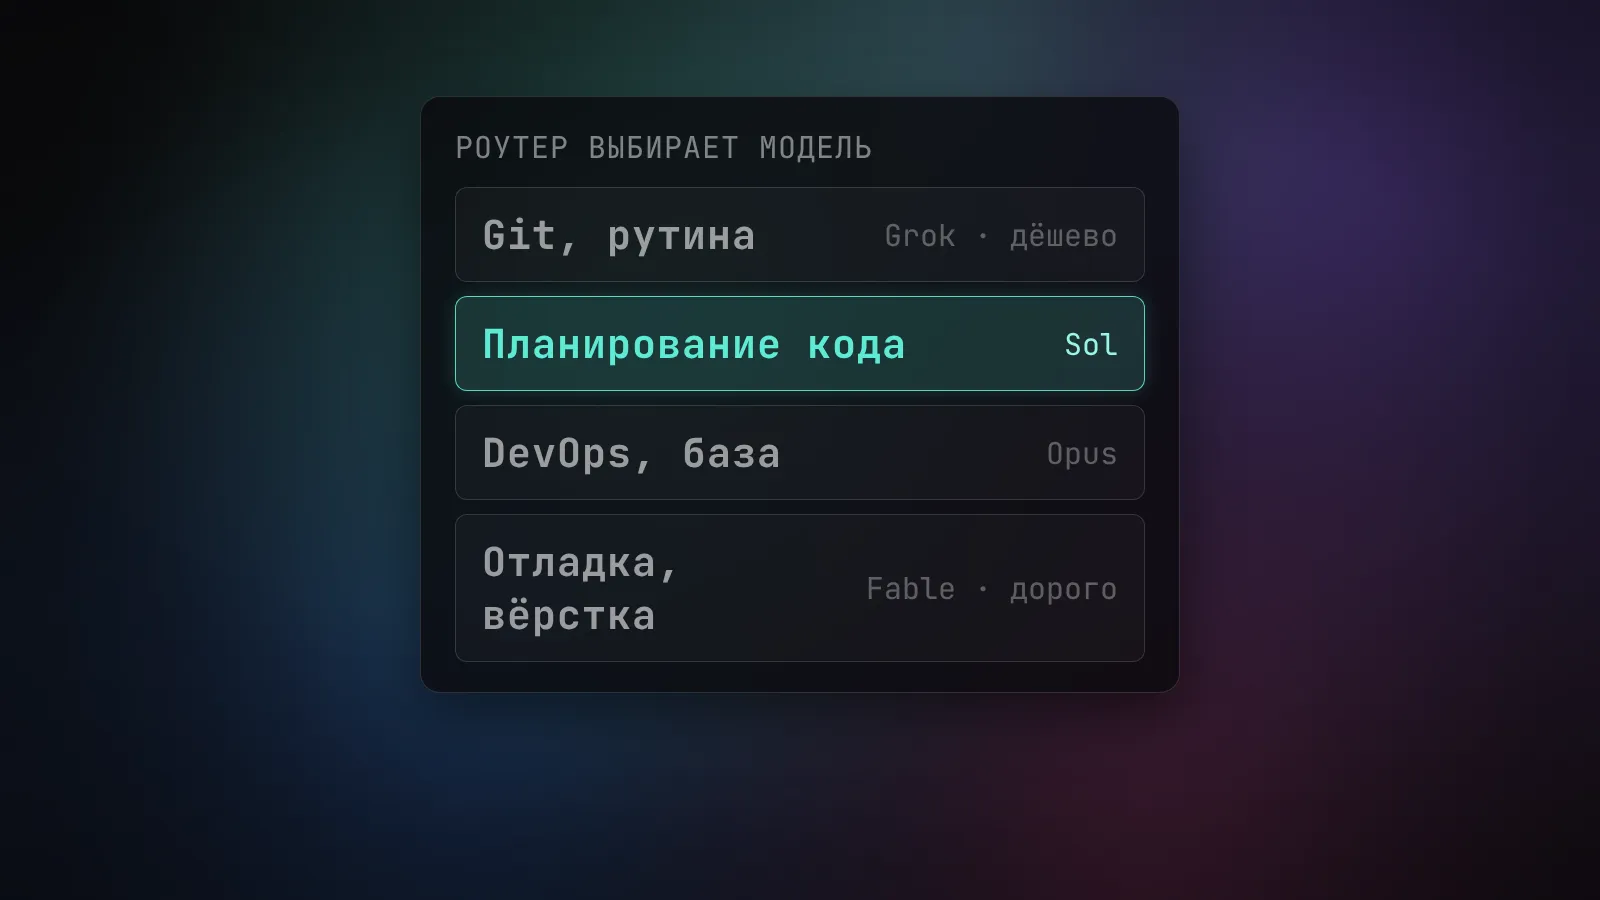
По разбору Cursor модели тянут разное. Grok - самый дешёвый, на нём рутина, git-команды, операции с базой. Sol силён в планировании, понимании кодовой базы и реализации. Opus хорош там, где много исполнения: DevOps, запросы к базе, оптимизация производительности. Fable - самый дорогой, его берут на отладку и визуальную вёрстку. В набор недавно добавили и Opus 5. Ни одна модель не выигрывает по всем фронтам, поэтому «просто включить самую мощную» - это переплата на половине задач и не всегда лучший результат на второй половине.
Смысл роутинга не в том, чтобы сэкономить любой ценой, а в том, чтобы под каждый запрос подобрать модель, где соотношение «качество на потраченный доллар» лучше всего. На переименовании переменной флагман не покажет ничего сверх того, что сделает дешёвая модель, - значит, платить за него незачем.
Сколько это экономит на самом деле
Заголовочная цифра Cursor - до 60% экономии по сравнению с тем, чтобы гнать вообще всё через Opus 4.8, при качестве на уровне флагмана. Роутер они обучили на 600 тысячах живых запросов и проверили в A/B-тесте на миллионах обращений.
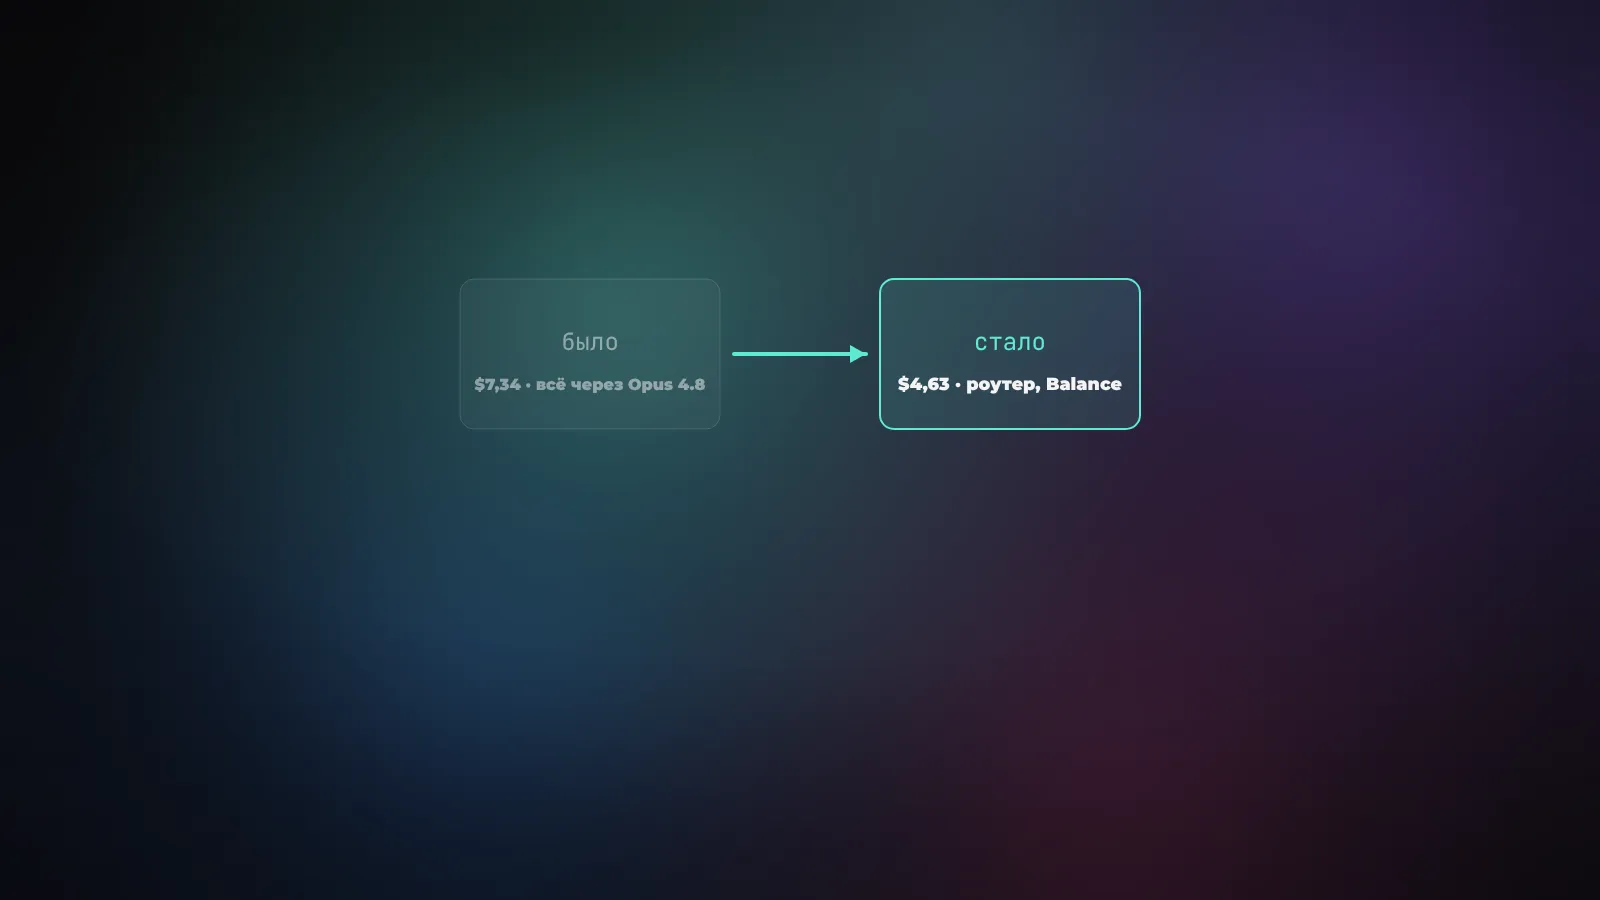
Но честнее смотреть на разброс. Сами же ранние корпоративные клиенты в раннем доступе получали скромнее - минус 30-50% к счёту. 60% - это скорее потолок при удачном раскладе, чем то, что увидит каждая команда. В пересчёте на один коммит у них выходило около 4,63 доллара на режиме Balance против примерно 7,34 доллара, если всё гонять через Opus 4.8. Это те самые 40% с копейками, а не 60.
Режимов у роутера три. Cost выжимает максимум экономии на рутине. Balance балансирует ум, скорость и цену - это разумный дефолт. Intelligence чаще тянется к мощным моделям на сложном, но всё равно дешевле, чем один флагман на всё. Важный нюанс по деньгам: счёт выставляется по прайсу той модели, в которую реально ушёл запрос, а режимы Balance и Intelligence съедают лимиты быстрее, чем Cost.
Это не только Cursor: идея старше
Роутинг моделей придумали не в Cursor. Ещё в 2024 году команда из Berkeley и Anyscale выпустила открытый фреймворк RouteLLM - ровно про то же самое: лёгкий классификатор смотрит на запрос и уводит простое на дешёвую модель, сложное на дорогую. Цифры у них были громкие: на бенчмарке MT-Bench роутер срезал стоимость на 85% при сохранении 95% качества сильной модели. По другому замеру - минус 40% обращений к мощной модели при потере меньше 5% качества.
Механика везде похожая. Обучают маленькую и быструю модель-классификатор (часто это компактный BERT или лёгкий промпт), она предсказывает сложность запроса до того, как тот дойдёт до основной модели. Ниже порога - едешь на дешёвую, выше - на флагман. RouteLLM выложили в открытый доступ, так что роутер можно поднять и у себя, а не только пользоваться готовым внутри Cursor.
Вывод из этого простой: то, что Cursor встроил роутер прямо в редактор, - это не разовый трюк одной компании, а зрелая идея, которая наконец дошла до продуктов, которыми пользуются каждый день. Дальше такие роутеры будут появляться везде, где ты платишь за токены.
Router и OpenRouter - это не одно и то же
Названия похожи, и их легко спутать, но это про разные вещи. OpenRouter, про который я уже писал отдельно, - это шлюз доступа: один API-ключ ко всем моделям сразу, единый счёт, единый формат запроса. Он решает проблему «не хочу заводить пять интеграций у пяти провайдеров». Но какую модель звать, ты по-прежнему указываешь сам.
Роутер вроде Cursor решает другую задачу - он выбирает модель за тебя, исходя из сложности конкретного запроса. Это уже не про доступ, а про интеллектуальный подбор исполнителя. По-хорошему они дополняют друг друга: шлюз даёт тебе широкий доступ ко всем моделям, а роутер поверх него решает, кому именно отдать каждый запрос.
Что это значит для тебя
Если ты просто пользуешься ИИ для кода или текста - можно ничего не настраивать, а просто включить режим «Авто» там, где он есть, и дать системе самой раскидывать задачи. На потоке однотипной работы это заметно снижает счёт без ощутимой потери в качестве, а на сложном роутер сам поднимет уровень до флагмана.
Если ты строишь свой продукт на моделях - идея роутинга стоит того, чтобы заложить её в архитектуру. Гнать вообще всё через самую дорогую модель - это сжигать деньги на задачах, которые вытянет модель в разы дешевле. Простейший роутер (хоть на готовом RouteLLM, хоть на своём классификаторе, хоть просто на явном правиле «эти запросы - на дешёвую, эти - на мощную») окупается быстро, особенно когда объём вырастает с сотен запросов до миллионов.
И главный сдвиг в голове: перестань думать в логике «одна модель на всё». Правильный вопрос теперь не «какая нейросеть самая мощная», а «какую модель звать на эту конкретную задачу». Роутер - это просто способ отвечать на этот вопрос автоматически и не переплачивать там, где мощь не нужна.