19 сентября 2026 г.
Jev: модель, которая не пишет текст, а принимает решения
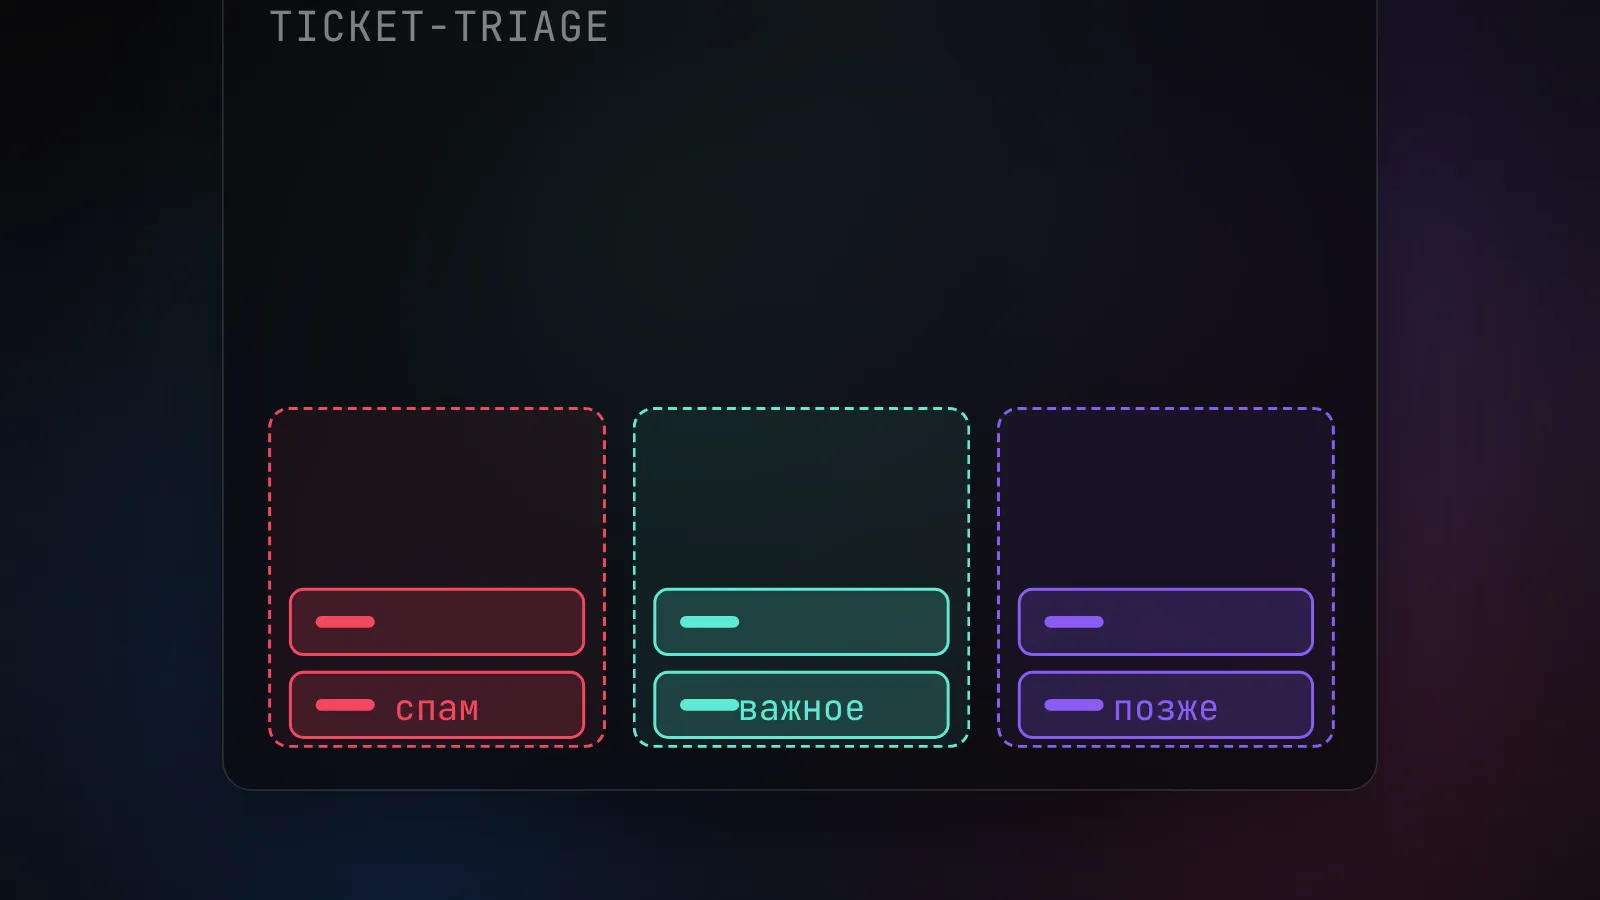

Jev - это ИИ-модель нового типа: она не пишет текст, а принимает решение. Даёшь ей кусок данных и список вариантов - получаешь готовый выбор с вероятностью, за 70-500 миллисекунд и почти бесплатно. Для классификации, модерации и маршрутизации это в десятки раз дешевле обычной LLM. Писать ей письмо или код бесполезно - она умеет ровно одно: решать.
Сделала её компания TypeSafe, а основатель - Диого Алмейда, до этого работавший в OpenAI над методами, которые научили модели следовать инструкциям (та самая механика, что стоит за ChatGPT). То есть человек не с улицы. И идея у него простая до наглости: большая часть работы, куда мы суём дорогущие чат-модели, - это вообще не разговор. Это выбор из списка. Разберём, почему это отдельный класс моделей и где он экономит реальные деньги.
System-1: почему это не очередная LLM
У психологов есть деление мышления на две системы. Система 2 - это когда ты сидишь и рассуждаешь вслух, шаг за шагом. Система 1 - это мгновенная реакция: увидел, распознал, ответил, не думая. Обычные большие модели живут в Системе 2 - они буквально проговаривают ответ токен за токеном, слово за словом. Именно поэтому они медленные и дорогие: чем длиннее ответ, тем дольше и дороже.
Jev назвали System-1 моделью потому, что она работает наоборот. Она не генерирует текст последовательно. Она смотрит на входные данные и выдаёт решение сразу, одним проходом, параллельно. На выходе не строка, а типизированное значение с честной вероятностью - модель прямо говорит, насколько она уверена. TypeSafe описывает это формулой «неструктурированное состояние на входе - типизированное вероятностное решение на выходе».
Обучали её не так, как чат-модели. Вместо того чтобы гнать модель писать красиво, её натаскивали давать откалиброванные вероятности - то есть если модель говорит «уверен на 80%», она и правда права примерно в 80% случаев. Подход авторы называют RLCD, обучение с подкреплением под калиброванные решения. Звучит академично, а на практике означает одно: цифре уверенности можно доверять и строить на ней логику.
Три типа решений: и всё
Jev умеет отвечать ровно на три вида вопросов. Не больше. И в этом её сила, а не слабость.
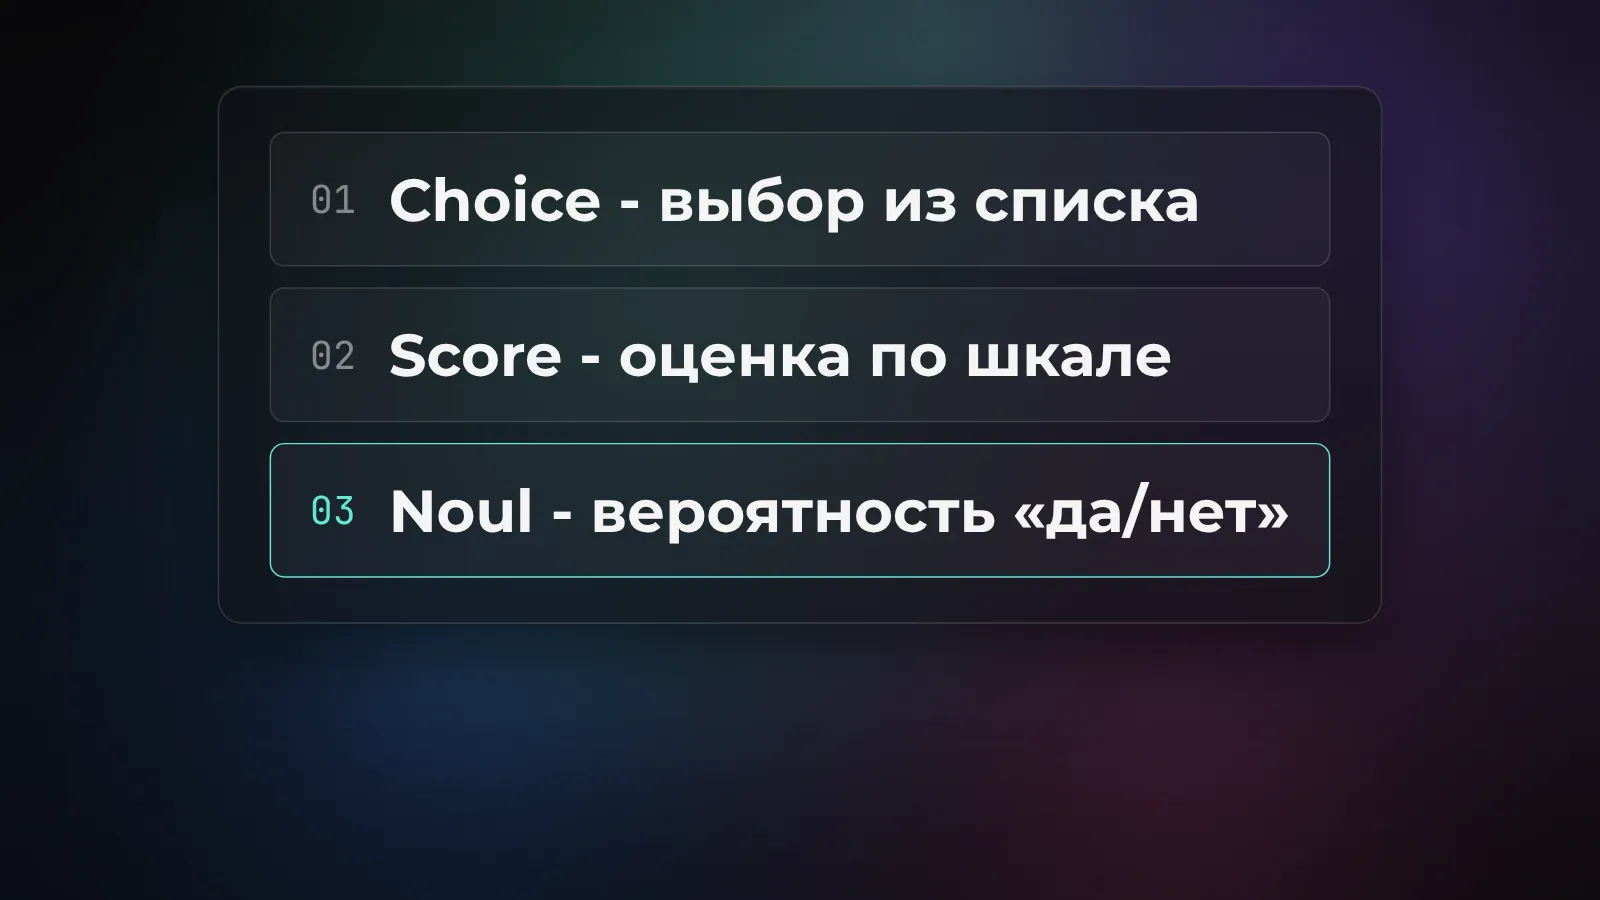
Первый - Choice, выбор. Ты даёшь список вариантов, модель выбирает один и возвращает распределение вероятностей по всем. Классический пример: пришёл тикет в поддержку - в какую категорию его кинуть, «оплата», «техника», «продажи» или «спам». Список может быть до 255 вариантов.
Второй - Score, оценка по шкале. Ты задаёшь диапазон, модель ставит число. Насколько срочный тикет, от 0 до 100. Насколько токсичный комментарий, от 1 до 5. Насколько отзыв похож на настоящий.
Третий - Noul, вероятность утверждения. Ты формулируешь высказывание, модель возвращает число от 0 до 1 - насколько это правда. «Этот текст нарушает правила». «Клиент в письме злится». «Заявка выглядит как мошенничество». По сути умное «да/нет», но с честной цифрой уверенности вместо жёсткого ответа.
Сколько это стоит и почему так дёшево
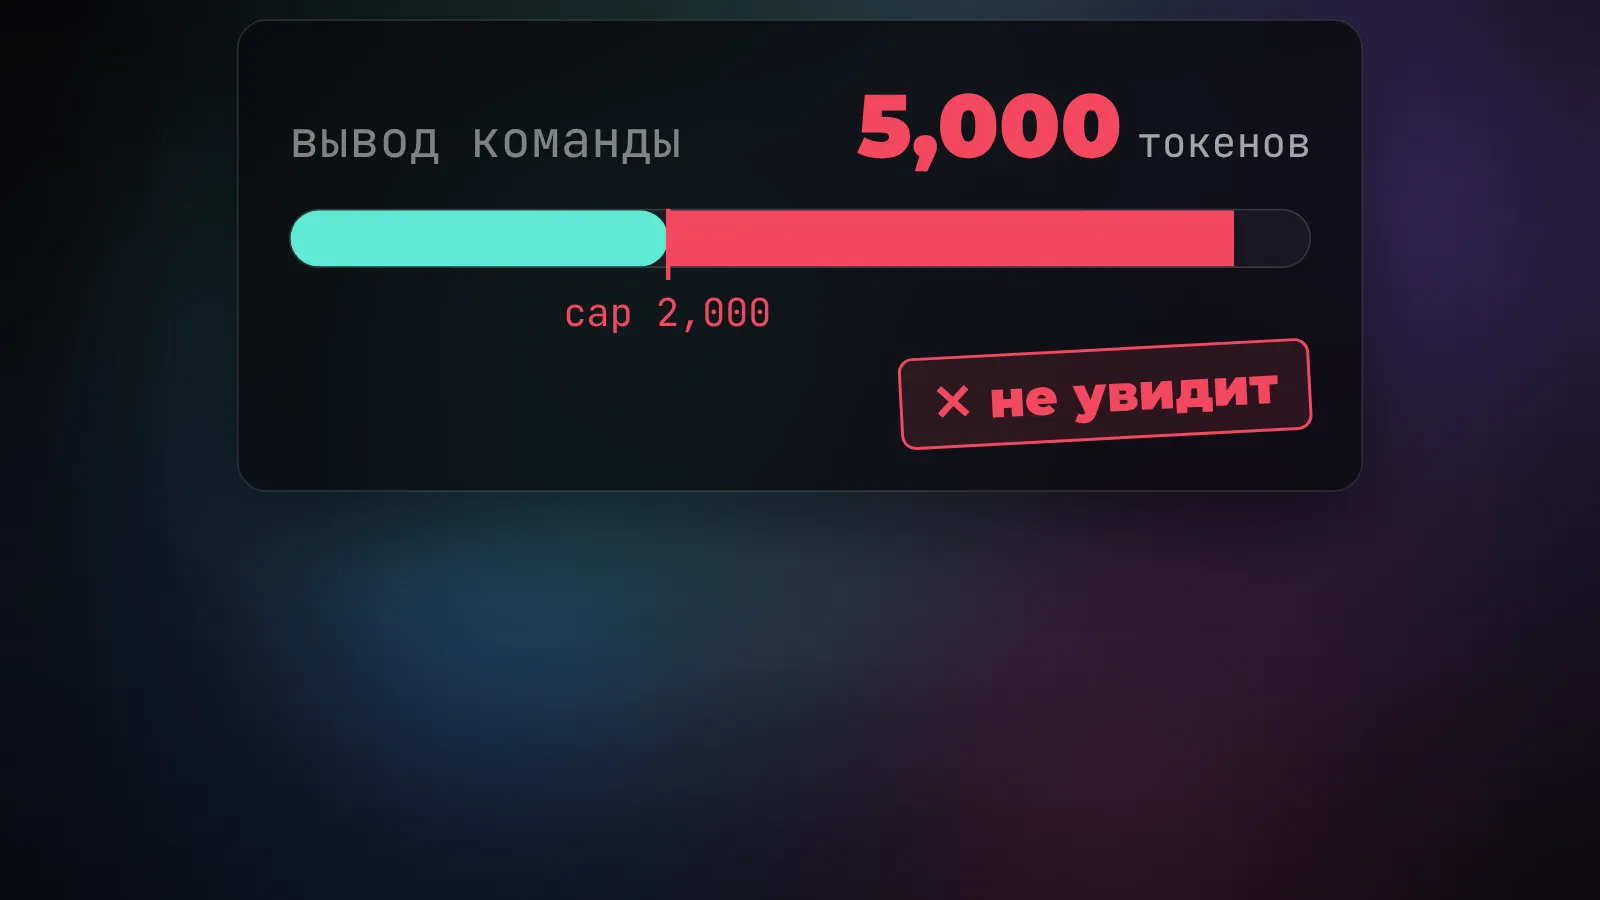
Вот тут начинается самое интересное для тех, кто считает деньги. Вход у Jev стоит 0,042 доллара за миллион токенов. Выход - бесплатно, вообще. TypeSafe пишет, что выходные токены слишком дёшево считать, потому что модель возвращает не простыню текста, а короткое структурированное решение.
Для сравнения: вход у крупной чат-модели уровня GPT-5.6 стоит около 2 долларов за тот же миллион токенов. Разница примерно в 48 раз. А теперь прикинь реальный объём: миллион запросов классификации по 500 токенов каждый - это полмиллиарда входных токенов, и по прайсу это выйдет около 21 доллара. За миллион решений. Одно решение - примерно 4 сотых цента.
Второе, за что платишь у обычных моделей и не платишь тут, - время. Jev отвечает за 70-500 миллисекунд. Большие модели на сопоставимых задачах думают от 3 до нескольких десятков секунд. Это 40-200 раз быстрее. На потоке в сотни тысяч решений в день разница между «доли секунды» и «десятки секунд» - это разница между живым сервисом и очередью.
Где это реально применить
Правило простое: Jev хорош там, где решение повторяется тысячи раз и варианты ответа известны заранее. Не «напиши ответ клиенту», а «реши, что с этим делать».
Разбор входящего потока - почта, тикеты, заявки, комментарии. Куда направить, насколько срочно, кому передать. Модерация и фильтры безопасности - на входе и выходе других моделей: «этот запрос токсичный», «этот ответ агента выходит за рамки». Причём дёшево настолько, что можно проверять каждое сообщение, а не выборочно.
Отдельная история - агенты. У любого агента внутри куча мелких развилок: продолжать или остановиться, этот инструмент вызвать или тот, задача выполнена или нет. Сегодня это часто гоняют через дорогую большую модель, и каждый шаг стоит и денег, и секунд. Jev закрывает ровно эти развилки за копейки и мгновенно, оставляя тяжёлую модель только на то, где реально нужен текст или рассуждение.
Насколько ей можно доверять
Тут важно не обмануться. У Jev есть гарантия «ноль ошибок типа». Это не значит «никогда не ошибается по сути». Это значит другое: она физически не может вернуть вариант не из твоего списка, число вне заданной шкалы или сломанный формат. Обычная модель иногда придумывает категорию, которую ты не просил, или отвечает не по схеме - с Jev это исключено математически. Для кода это большое облегчение: ответ всегда валиден, разбирать и защищаться от мусора не нужно.
По самой же точности выбора картина трезвая. На тесте из нескольких рабочих сценариев Jev показала около 67,8% совпадений с эталонными ответами. Для ориентира: сопоставимая по цене чат-модель дала почти столько же, а более тяжёлые модели - около 73-74%. То есть Jev не выигрывает у топовых моделей по качеству решения. Она примерно на уровне середняка, но при этом в десятки раз дешевле и быстрее. Вывод честный: берёшь её туда, где важны скорость и объём, а не выжимание последних процентов точности.
Как попробовать
На середину сентября 2026 Jev в раннем доступе. Есть песочница на сайте TypeSafe, где можно потыкать вопросы руками без единой строчки кода, и есть API. Запрос летит на POST https://api.typesafe.ai/v1/systemone, модель указывается как jev-latest. Под руки разработчику дают SDK на Python и JavaScript. Полноценный доступ пока по листу ожидания, так что записывайся заранее.
Контекст на запрос - 64 тысячи токенов, при этом состояние плюс самый длинный вопрос не должны превышать 32 тысяч. Для классификации письма или тикета этого хватает с огромным запасом.
Что тут подвох
Главное ограничение уже прозвучало, но повторю прямо: Jev не пишет, не объясняет, не программирует, не ходит в браузер и не дёргает инструменты. Это не замена ChatGPT или Claude. Это отдельный инструмент под отдельную работу. Попытка приспособить её под генерацию текста - пустая трата времени, она так не умеет по устройству.
Дальше - пока только текст. Картинки на вход обещают позже, но сейчас модель работает со структурированным состоянием и текстом, не с изображениями. И третье: тебе нужно заранее описать схему ответа - список вариантов, шкалу, формулировку. Модель не догадается за тебя, что именно ты хочешь решить. Она хороша ровно настолько, насколько чётко ты поставил вопрос.
Если коротко: появился дешёвый и быстрый способ выносить из дорогих моделей всю рутину выбора. Не революция в том смысле, что «ИИ теперь всё», а точечный инструмент, который у людей с потоком однотипных решений режет счета в десятки раз. Ровно тот случай, когда стоит посмотреть на свой пайплайн и найти в нём места, где ты платишь за разговор там, где нужен только выбор.