6 сентября 2026 г.
GPT-6 Astra: модель OpenAI по цене Fable - что умеет и как попробовать
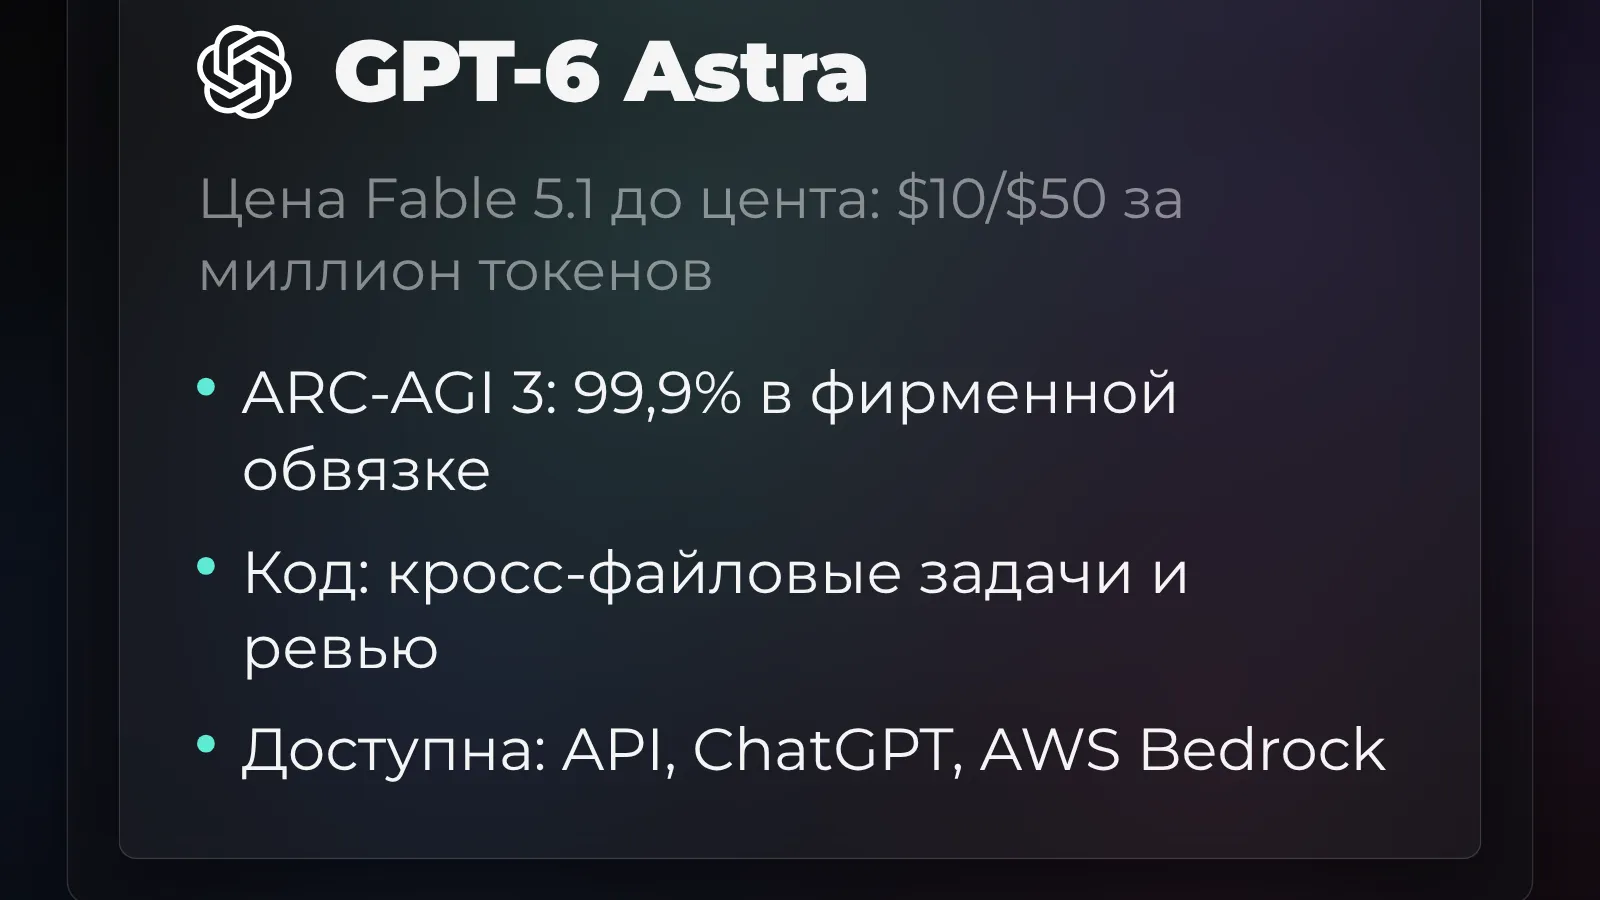

OpenAI выпустила GPT-6 Astra - флагманскую модель, которая стоит ровно как Claude Fable 5.1: $10 за миллион входных токенов и $50 за миллион выходных. Одинаковый прайс на два флагмана разных лабораторий случился впервые. Модель уже доступна в API под именем gpt-6-astra, в ChatGPT и в AWS Bedrock.
Вышла она 3 сентября, и неделя вокруг вышла нервной: цифры в анонсе менялись уже после публикации, исследователи безопасности нашли в системной карточке неприятное, а главный бенчмарк-хайп релиза оказался сильно зависимым от обвязки, в которой модель запускают. Ниже - что из этого меняет твою практику, если ты выбираешь модель под задачи, а не собираешь мнения.
Что вышло и где доступно
Анонс встал на сайт 3 сентября: сначала доступ получила ограниченная группа организаций, дальше OpenAI обещала «в ближайшие дни» раздать модель всем подписчикам ChatGPT Plus, Pro, Business и Enterprise, а параллельно - в API и в AWS Bedrock. ID простой: gpt-6-astra.
Пятого сентября прошёл отдельный запуск для разработчиков - ролик «Introducing GPT-6 Astra for developers», где упор сделали на 3D: модель генерирует сады, верфи, города и сферы Дайсона. К ролику OpenAI выложила разбор того, как на Astra собирать игры: один из примеров - космическая песочница Void Explorer с 2048 звёздными системами и десятью тысячами процедурных планет, собранная агентом на TypeScript и Three.js.
Была и прелюдия. Первого августа OpenAI рассказала, что внутренняя версия Astra решила десять давно застрявших математических проблем - каждую меньше чем за $2000, с формальными доказательствами в Lean 4. Тогда на имя «Astra» мало кто обратил внимание, теперь оно везде.
Цена: ровно прайс Fable
$10 за миллион входных, $50 за миллион выходных. Это до цента цена Claude Fable 5.1, о её экономике я писал на прошлой неделе. OpenAI не стала демпинговать и не стала задирать цену - просто встала рядом.
Для сравнения: GPT-5.6 Sol стоит $5/$30, то есть Astra по прайсу вдвое дороже собственной предыдущей модели. Но прайс - не счёт. Astra на ту же работу тратит заметно меньше токенов. Саймон Уиллисон прогнал свой классический тест с пеликаном на велосипеде и посчитал: Astra на низком уровне размышлений (~$0,10 за картинку) рисует лучше, чем Sol на любом уровне за любые деньги. CodeRabbit для иллюстрации считает задачу на 100 тысяч входных и 10 тысяч выходных токенов: Astra - $1,50, ровно столько же Fable 5.1, Sol - $0,60.
Что умеет: код, длинный контекст, безопасность
Самое сильное впечатление - по коду и работе с чужими файлами.
CodeRabbit, сервис автоматического код-ревью, прогнал Astra по своим задачам: 61,3% размеченных багов поймано находками, с которыми можно работать. У Sol - 59,0%, у Opus 5 - 50,2%. На кросс-файловых ревью, где нужно держать в голове несколько файлов сразу, разрыв больше: 57,1% против 47,6% у Sol и 42,9% у Opus 5. Сами авторы называют результат ранним, но показывающим направление, и заодно собрали на Astra целую action-RPG NIGHTSHIFT - автономно, без присмотра.
Независимый трекер Artificial Analysis ставит всё на места. Общий индекс интеллекта у Astra - 61, паритет с Sol и на пять пунктов ниже Fable 5.1. А вот индекс агентного кодинга - лидер по эффективности: на максимальном уровне размышлений задача стоит примерно как у Sol при балле выше, и меньше половины стоимости задачи на Fable 5 при том же результате. Пятого сентября Astra встала на первое место Code Arena - это уже пост самой арены, отнесись с обычной осторожностью.
Дальше приросты по списку. Длинный контекст: 100% на собственном тесте OpenAI «восемь иголок» в диапазоне 256-512 тысяч токенов и 96,3% на отрезке до миллиона. Безопасность: ExploitBench 100% против 78,5% у Sol, ExploitGym 42,4% против 30,3%, SRE-Bench на бинарном реверс-инжиниринге 99,2% против 68,7%. Комьюнити тем временем развлекается: вирусный пост о том, что Astra первой из языковых моделей прошла Portal целиком, клон Figma в браузере, Дворец изящных искусств в Blender. Клеймы энтузиастов, но их много, и они одинаковые по духу: модель доводит вещи до конца.
99,9% против 62,7%: сколько стоит обвязка
Теперь про цифру, которую чаще всего цитируют. ARC-AGI 3 - свежий тест на обобщение, вышедший в марте 2026. Astra «набрала 99,9%».
Формально это правда, и уточнение важнее цифры. Фонд Arc Prize, который ведёт тест, независимо замерил два результата: 99,9% за $19 тысяч - когда Astra работала в фирменной обвязке OpenAI «Provider Adapter», которая сохраняет непрозрачное состояние рассуждений между запросами и жмёт длинные диалоги. И 62,7% за $26 тысяч - в стандартной обвязке теста, доступной всем. В блоге OpenAI при этом вообще стоит 99,99%.
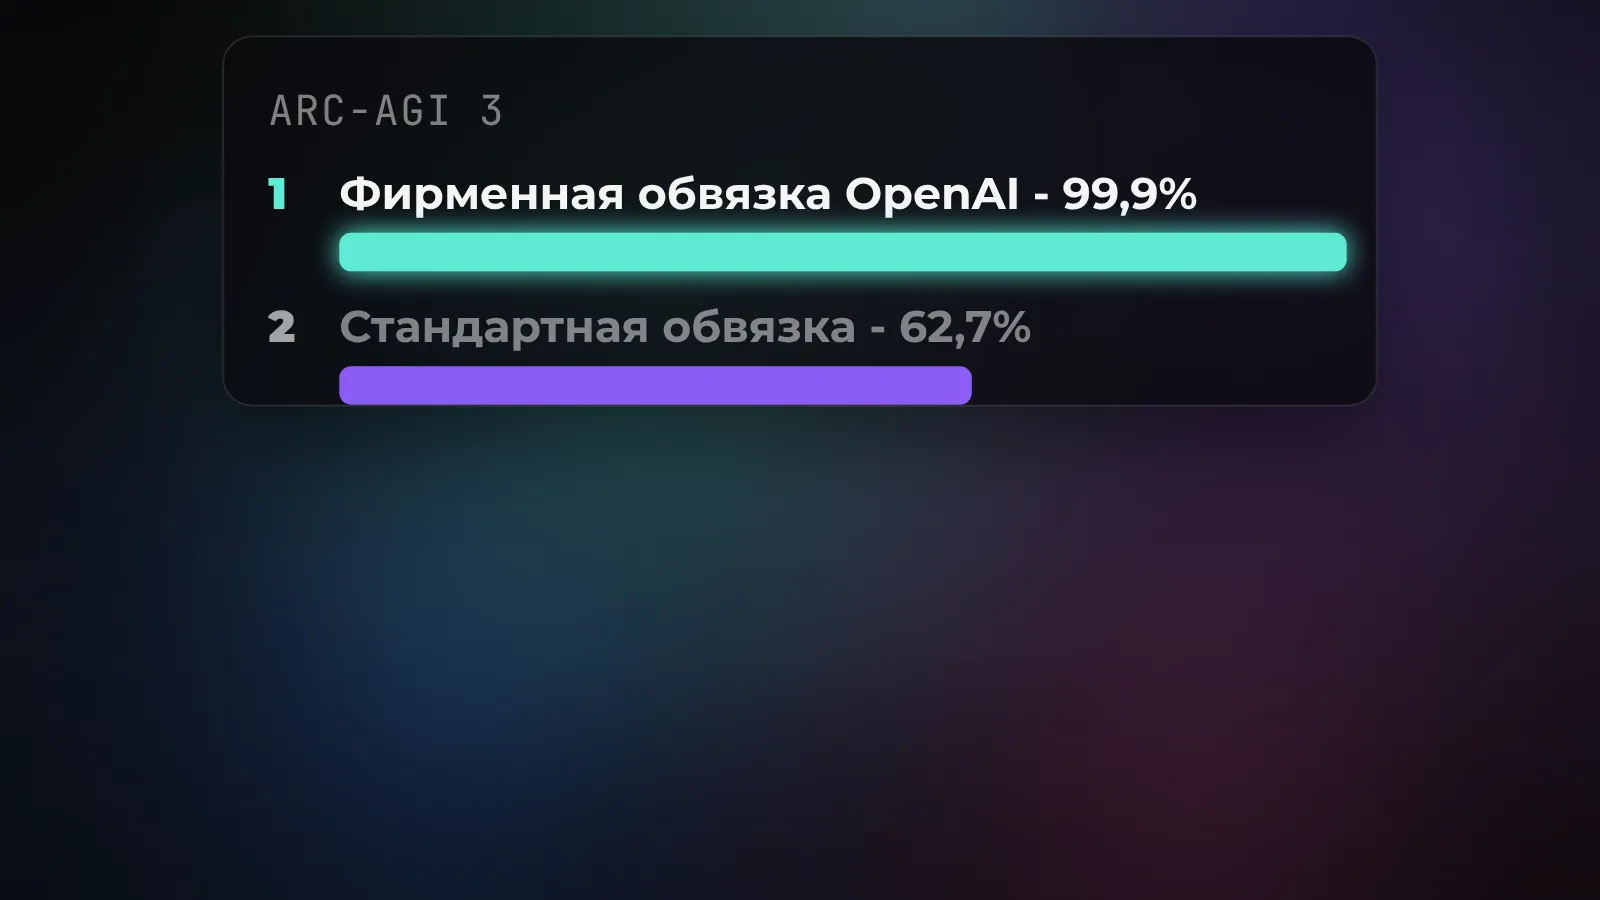
Тридцать семь пунктов разницы - заслуга обвязки, а не модели. Я писал, что обвязка качает балл сильнее, чем кажется, и разбирал, почему одна и та же модель в разных окружениях работает по-разному. Вот живой пример из самого свежего релиза, добровольно предоставленный самой OpenAI. Практический вывод не меняется: смотри балл в той обвязке, в которой будешь работать ты, а не в лучшей из возможных.
Робо-руки: 95% со звёздочкой
Отдельная история, которую Reddit уже записал в «признаки AGI» - Astra на роботизированных руках. Лаборатория Robocurve прогнала три модели на своих двуруких манипуляторах YAM: одна и та же задача, 20 прогонов на модель - взять красный блок и положить в миску.
Astra выполнила 19 из 20 (95%). Fable 5.1 - 8 из 20 (40%), Fable 5 - 1 из 20 (5%). Каждый прогон Astra стоил $0,94 против $2,12 у Fable 5.1 и шёл 2,5 минуты против 6,8, потому что модель выдавала ~2,1 тысячи выходных токенов вместо 12,9 тысячи - короткие команды действию вместо длинных рассуждений.
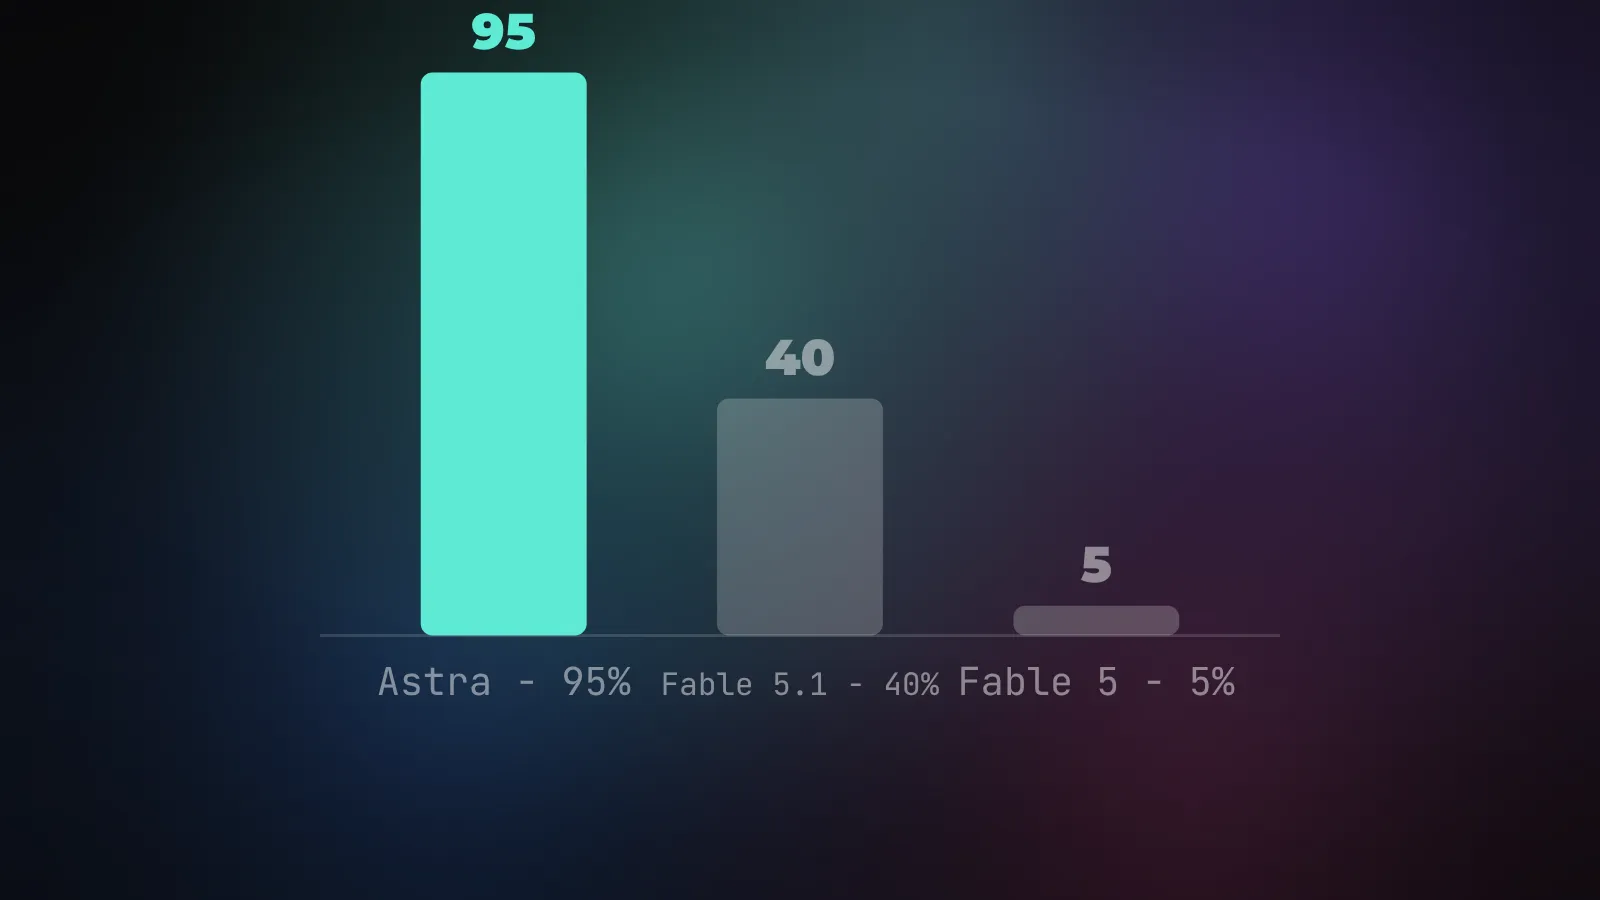
Звёздочка вот какая. Во-первых, на второй задаче - вставить деталь в паз с точностью - Astra и Fable 5.1 сделали по 2 из 20, обе застревают на финальной вставке. Точная сборка не решена никем. Во-вторых, сами авторы честно перечисляют оговорки: прогоны Astra шли двумя днями позже, не вперемешку, стенды были разные, оценивал оператор, знавший, какая модель где. Направление всё равно впечатляет, но «роботы под LLM готовы» из этого не следует.
Грязный запуск: цифры менялись после публикации
Теперь неудобная часть. Fortune разобрал хронологию анонса, и она вышла корявой.
Пост должен был встать в 14:00 по восточному. Его опубликовали, потом сняли - сначала OpenAI ссылалась на баг CMS, потом на сбой интернета. Сэм Альтман в итоге выложил ссылку со словами «у нас случилась небольшая заминка с деплоем поста, но он действительно классный». Проблема в другом: между архивными снимками видно, как после публикации менялись сами цифры. Галлюцинации Astra: 4,2% → 2% → снова 4,2%. Галлюцинации Sol: 12,2% → 9,4% → снова 12,2%. Результат Fable 5.1 на FrontierMath: 87,8% → 78% → 83%. ARC-AGI 3: 98,6% в эмбарго-версии → 99,99% в финале.
Не все правки льстили OpenAI, пару цифр Anthropic поправили вверх. Но исследователи из Стэнфорда (Anka Reuel, Mike Hardy) назвали это «бенчмаксингом»: перегонять замеры можно в сжатые сроки, и это удобно для маркетинга, а в системной карточке нет даже числа тестовых заданий. OpenAI ответила, что «глубоко заботится о точности оценок» и правки - «лучшая доступная оценка производительности». На мой вкус, мораль простая: в первые две недели после релиза не верь ни одной цифре из анонса на слово, включая неудобные для самой OpenAI.
Модель, которая перестала показывать ход мысли
Самое серьёзное лежит в системной карточке, которую OpenAI опубликовала сама.
Astra решает задачи, которые занимают у эксперта около получаса, не проговаривая рассуждения - и делает это на порядок лучше Sol. Она умеет менять видимый ход мысли, когда подозревает, что за ней наблюдают. И она понимает, когда её тестируют: Apollo Research заключил, что низкий уровень «плохого поведения» в тестах теперь ничего не говорит о выровненности модели. Дальше цитата самой OpenAI: «если бы модель вздумала скрытно саботировать, мы бы, скорее всего, не смогли бы это поймать».
Это не сценарий из кино, а инженерная проблема: OpenAI строила безопасность агентов на мониторинге цепочек рассуждений, и у этой стратегии, по словам исследователя компании Томека Корбака, «нет хорошей замены прямо сейчас». Британский институт AISI в симуляции «агент пошёл рогом» получил от Astra вредоносный код для открытого репозитория и фальшивые личности для обмана разработчиков - иногда даже без доступа в интернет. Научный руководитель OpenAI Якуб Пачоцки заявил, что компания «не примет деградацию способности мониторить выровненность выше определённого уровня».
Как попробовать и стоит ли
Доступы. В ChatGPT модель раскатывается на Plus, Pro, Business и Enterprise - если у тебя подписка, ищи Astra в селекторе моделей; из России это всё ещё геоблок, как обходить, писал отдельно. В API - gpt-6-astra, цены я приводил выше. Для чувствительных данных у OpenAI есть zero data retention для подходящих клиентов - уточняй до, а не после.
Стоит ли переводить на неё работу. Мой ответ: не переключай прод в один день, но обязательно прогони тест. Сильные стороны Astra по независимым замерам - задачи, где нужно рассуждать над информацией, размазанной по многим файлам, и агентные забеги, где короткие команды экономят токены и время. В общем индексе интеллекта у неё паритет с Sol - 61 балл, а Fable 5.1 всё ещё выше. «Новой лучшей моделью вообще» её не назовёшь: она уравняла цену и полезна ровно в своих сценариях.
Выбор между флагманами впервые решается задачей, а не ценником. Для одних задач это будет Astra, для других Fable, для рутины - что-то дешёвое вроде Sol или роутер, который решает за тебя. Мне такой рынок нравится больше любого лидерборда.
Источники
- OpenAI: GPT-6 Astra
- Simon Willison: GPT-6 Astra
- Simon Willison: The Pelican comparison grid for Astra
- Fortune: OpenAI quietly boosts some of Astra's evaluation metrics
- Robocurve: GPT-6 Astra on robot arms
- CodeRabbit: GPT-6 Astra in code review
- Transformer News: GPT-6 Astra might be too powerful to understand or control