2 сентября 2026 г.
Claude Fable 5.1: та же цена, но агентные сессии до 45% дешевле

Anthropic выпустила Claude Fable 5.1 и закрытого близнеца Mythos 5.1. Прайс не изменился ни на цент, а кэш-чтения подешевели в четыре раза: с $1 до $0,25 за миллион токенов. Для чата это почти ничего, для агентных пайплайнов, где префикс перечитывается десятки раз, Anthropic обещает до 45% экономии. Обновляй ID модели - и проверь три ломающих изменения.
Вышло всё это 1 сентября вечером, и за ночь анонс собрал на Hacker News 1262 балла и больше тысячи комментариев. Обсуждают там в основном не бенчмарки, хотя и есть о чём. Обсуждают цену кэша - и это правильный фокус, объясню почему.
Что вышло: одна модель с двумя лицами
Fable 5.1 - прямое продолжение Fable 5: то же окно контекста в миллион токенов, тот же лимит вывода в 128 тысяч, те же $10 за миллион входных и $50 за миллион выходных токенов. Модель доступна везде сразу: Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry. ID простой - claude-fable-5-1.
Mythos 5.1 - та же самая модель, но с другими настройками безопасности. Её отдают только избранным: верифицированным киберзащитникам и биологам через программу Project Glasswing, и пока только организациям из США. Для обычной разработки она не существует, так что дальше в тексте речь про Fable 5.1.
Из тихих, но важных деталей: все тексты Fable 5.1 несут статистический водяной знак Anthropic - на всех платформах, без исключений. Про то, как эти невидимые метки устроены и чем они грозят, я уже писал - тут ничего не поменялось, просто маркер теперь и на этой модели.
Почему все обсуждают цену кэша
Короткий ликбез, без него экономика обновления не считается.
Агент - это цикл. Модель читает задачу, вызывает инструмент, читает результат, вызывает следующий. На каждом шаге API-запрос заново отправляет весь контекст: определения инструментов, системный промпт, историю диалога. Промпт-кэш решает именно это - стабильный префикс обрабатывается один раз, а дальше не пересчитывается, а читается из кэша. Запись в кэш стоит дороже обычного входа ($12,50 против $10 за миллион токенов), зато чтение у моделей Claude всегда стоило десятую часть - $1.
У Fable 5.1 чтение стоит $0,25. Не «на 75% меньше» абстрактно, а конкретно: множитель 0,025 от базовой цены вместо привычных 0,1. Четыре доллара за каждые четыре мегатокена перечитанного префикса превращаются в один.
Почему это бьёт именно по агентам: у человека в чате префикс перечитывается раз в сообщение, а большая часть счёта - генерация ответа. У агента в длинной сессии наоборот: 30-60 шагов, каждый тащит за собой нарастающий хвост из инструментов, результатов и размышлений, и кэш-чтения съедают основную строчку счёта. Чем дольше сессия, тем большую долю счёта занимает перечитывание того, что модель уже видела.
Считаем на пальцах. Агент с префиксом в 150 тысяч токенов, который за смену делает 40 шагов: это около 6 миллионов токенов одних кэш-чтений. На Fable 5 - $6, на Fable 5.1 - $1,50. Одна сессия, четыре доллара разницы, и это без учёта того, что префикс обычно растёт. Anthropic оценивает итоговую экономию примерно в 25% для типовых нагрузок и до 45% на сильно агентных. Это оценка самой компании, у тебя цифра будет зависеть от доли чтений в счёте, но направление такое.
Кстати, это стоит отличать от гистинга: там промпт сжимают, чтобы меньше токенов возить вообще, а тут возят столько же, но каждое повторное чтение стоит четверть цены. Приёмы складываются, а не конкурируют.
Что с умом: один скачок и много аккуратных приростов
Теперь про capability, честно.
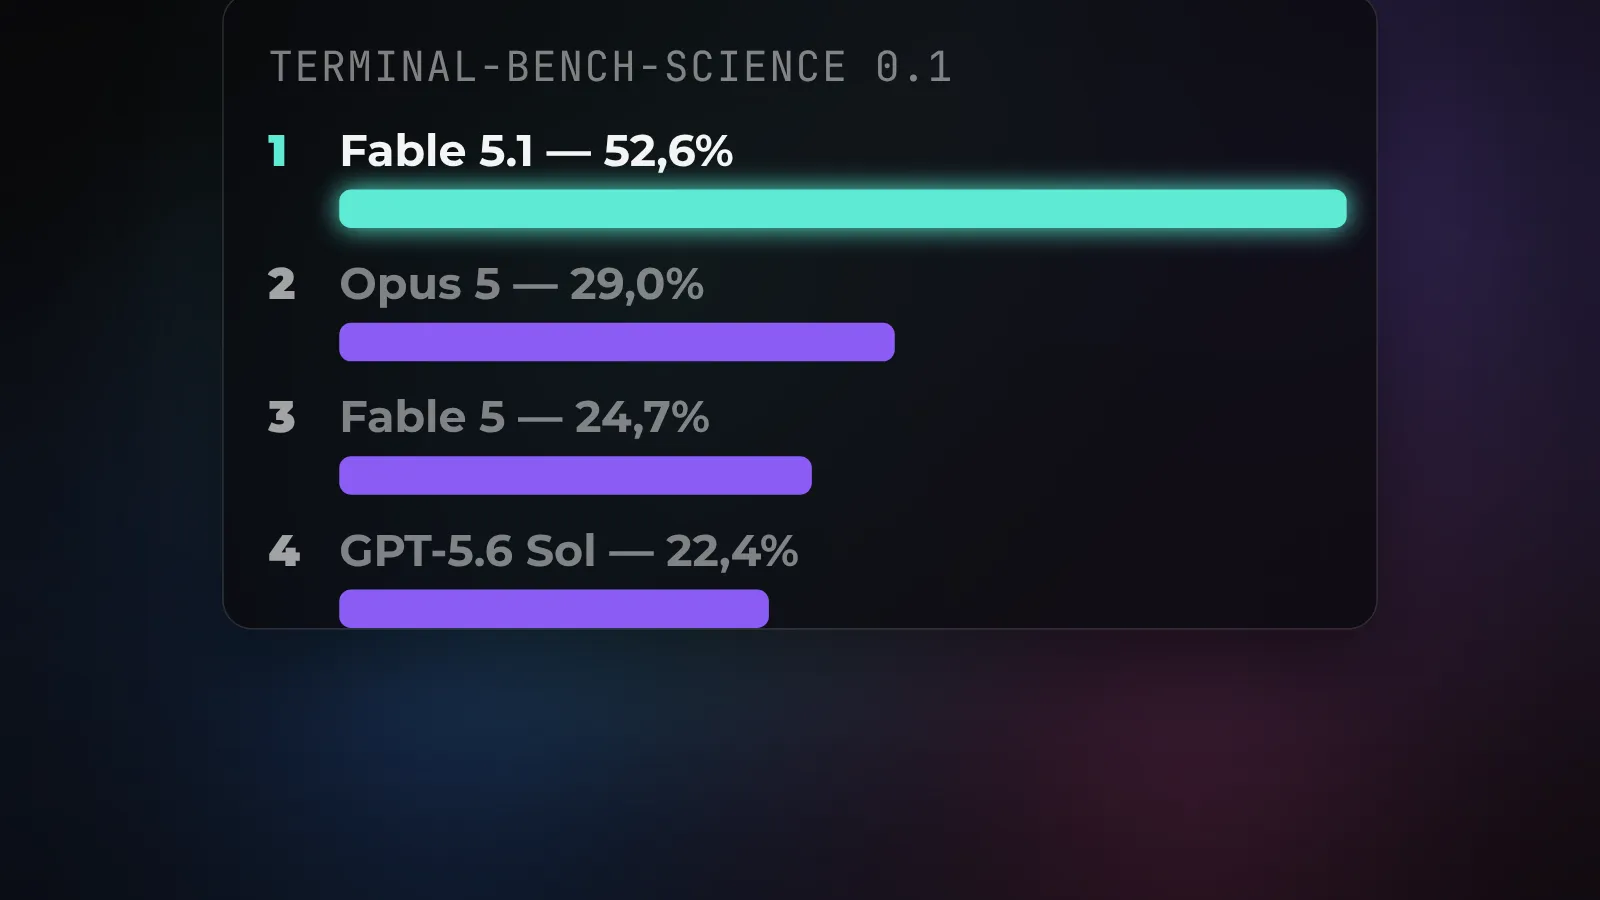
Один бенчмарк прыгнул сильно: Terminal-Bench-Science 0.1, задачи научной работы в терминале - 52,6% против 24,7% у Fable 5, 29,0% у Opus 5 и 22,4% у GPT-5.6 Sol. Звучит как «вдвое умнее», и Anthropic сама это подчёркивает. Но у того же замера заявленная погрешность плюс-минус 3,5-4,5 пункта, а на публичном лидерборде цифры не совпадают с сетапом Anthropic - компания объясняет это воспроизводимостью своего окружения. Я писал, почему к пунктам на лидербордах вообще стоит подходить с недоверием, и тут это правило работает как обычно.
По остальным замерам прирост ровнее: Terminal-Bench 4.0 - с 42,0% до 55,8%, AutomationBench - с 17,1% до 31,4%, а Humanity's Last Exam, OSWorld и CursorBench прибавили по несколько пунктов. Саймон Уиллисон, который в ночь релиза прогнал модель через свой тест с пеликаном на велосипеде, резюмировал так: скачок в науке большой, в остальном - слегка лучше.
Живее любых бенчмарков выглядит история от независимой лаборатории vals.ai: Fable 5.1 вскрыл криптограмму Cyphral Distich, которая стояла нерешённой 370 лет - две строки чисел из книги 1653 года, на которую историки ломали зубы с XIX века. Модель справилась за 44 минуты и 176 тысяч токенов, без подсказок человека. Создатель проверки подчёркивает: шифр оказался прост, когда нашёлся ключ, никакого гениального криптоанализа - модель просто продолжала искать, когда другие флагманы останавливались. Это, пожалуй, самое честное описание силы длинных агентных сессий, под которые Fable 5.1 и затачивался: не решать мгновенно, а добивать.
Ловушки миграции: три ломающих изменения
Если вызываешь Fable 5 по API и меняешь ID на claude-fable-5-1, код может упасть. Вот что ломается.
Первое: принудительный вызов инструментов больше не поддерживается. tool_choice типа any или tool вернёт ошибку 400. Причина любопытна: у модели thinking всегда включён, а форсированный вызов инструмента перепрыгивал бы размышление, и модель начала бы прятать ход мысли в аргументы вызова. Решение: оставить auto, для строгого JSON использовать strict tool use или structured outputs.
Второе: thinking-блоки привязаны к модели. Fable 5.1 читает размышления старых моделей, но ни одна старая модель не читает его собственные. Если твой роутер переключает модели посреди разговора - при откате с Fable 5.1 на что-то ещё размышления молча выбросятся.
Третье, самое коварное: редактирование ранних ходов инвалидирует thinking-блоки. Правило простое - история должна быть append-only. Классические грехи самописных обвязок: вкинуть в старый ход напоминание и убрать его следующим запросом, пересобрать системный промпт или список инструментов между запросами одной сессии. Всё это раньше проходило бесследно, теперь ломает связность. Проверка включена для аккаунтов, созданных 31 августа 2026 или позже; на старых аккаунтах расхождение пока только фиксируется в лог, но полагаться на это не стоит.
Из приятного в той же теме: effort теперь можно менять посреди разговора без потери кэша - поднять на сложном шаге, опустить на рутинном (пока бета). Для длинных сессий это второй по значимости экономический рычаг после дешёвых чтений.
Мелочи поведения, которые заметишь
Anthropic честно задокументировала изменения, которые проявятся без всяких правок кода.
Модель реже собирает вызовы инструментов в пачки: там, где Fable 5 делал несколько параллельных чтений за ход, Fable 5.1 может сделать одно и то же за два-три хода. Качество ответа не страдает, а токены и время - да. Лечится одной строкой в промпте с просьбой батчить независимые вызовы.
Прогресс-обновлений между вызовами стало меньше, особенно на высоком effort - длинный агентный ход может выглядеть молчащим. Если интерфейс живёт от наррации, теперь есть режим display: "updates", который возвращает статусные строки, не раскрывая размышления.
На низком effort модель чаще отвечает из памяти, не дёргая поиск. И при правке файлов склонна переписывать файл целиком вместо точечной правки - результат тот же, токенов больше. Для текстовых задач это лечится просьбой делать точечные правки.
Кому обновляться, кому нет
Fable 5.1 - модель для долгих агентных забегов: многочасовой рефакторинг, ресёрч со множеством проверок, доведение анализа до готового документа. Клиенты Anthropic приводят истории уровня «38-часовой автономный прогон без присмотра» и «проследила до бага в чужой библиотеке краш, случавшийся раз на миллион запусков и четыре года ускользавший от команды». Если твои сценарии такие - обновляйся: та же цена, кэш в четыре раза дешевле, устойчивость к длинным сессиям лучше.
Если задачи короткие и рутинные - экономика другая. Opus 5 стоит $5/$25 за миллион токенов, вдвое дешевле Fable, и Anthropic сама советует начинать с него. Разумная схема для агентной системы: рутина на Opus 5, эскалация на Fable 5.1, когда задача того стоит - тем более что thinking-блоки переносятся в сторону Fable без потерь, а дешёвые кэш-чтения делают переключение безболезненным.
Мне в этом релизе нравится сам сдвиг приоритетов. Гонка «наш бенчмарк выше» упёрлась в погрешности измерений, и следующие деньги зарабатывают не на баллах, а на цене владения: час агентной работы стоит меньше при том же качестве. Для тех, кто строит на агентах процессы, а не играет с чатом, это важнее любого лидерборда.