17 августа 2026 г.
Высокий балл в бенчмарке не значит, что ИИ лучше пишет код

Высокий балл на SWE-bench не значит, что модель лучше пишет код - часто это значит только то, что её хорошо натаскали именно на этот бенчмарк. Разрыв между баллом в табличке и поведением на твоих реальных задачах - обычное дело, и OpenAI сама ушла из этого теста. Дальше - как выбирать модель, чтобы не купиться на цифру.
Каждый раз, когда выходит новая модель, первым делом показывают табличку с баллами - и рука тянется переключить агента. А потом на реальных задачах модель ведёт себя не так, как обещала табличка. Разбираю, откуда берётся этот разрыв.
Что вообще такое SWE-bench
Это стал главный тест на «умеет ли ИИ писать код». Устроен честно на первый взгляд: берут 500 реальных задач из открытых Python-проектов на GitHub - настоящие баг-репорты и фичи из репозиториев вроде Django. Модели дают описание проблемы и весь код проекта, она должна выдать патч. Патч прогоняют через тесты этого проекта: прошли - задача решена, нет - провал.
Звучит как идеальная проверка: живые задачи, объективные тесты, никакой вкусовщины. Именно поэтому на SWE-bench молились - его балл кочевал из пресс-релиза в пресс-релиз как доказательство, что вот эта модель по-настоящему хороша в коде. Проблема в том, что как только на метрику начинают давить всей индустрией, она перестаёт мерить то, ради чего задумывалась.
Как балл отрывается от реальности
Первое - обвязка. Голая модель патч не пишет, вокруг неё строят «леса»: как подать код, сколько попыток дать, как искать нужный файл, как прогонять тесты. Так вот один и тот же движок с разной обвязкой набирает баллы, которые различаются на 25 пунктов. Двадцать пять. Ты видишь в табличке «82%», а это в равной степени заслуга модели и заслуга инженеров, которые полгода допиливали строительные леса конкретно под этот тест.
Второе, и это серьёзнее - утечка. Задачи SWE-bench лежат в открытых репозиториях, а модели обучают на всём открытом коде, до которого дотянулись. Значит, решения многих задач модель могла видеть на обучении. Проверили прямо: на этом бенчмарке модели находят место бага в 3-6 раз точнее, чем на очищенных задачах, которых они гарантированно не видели. Это не навык. Это память. Модель не решает задачу, а вспоминает ответ, который уже проезжал мимо неё в обучающем наборе.
Свежий эксперимент: натаскали на тест - навык не вырос
Та самая августовская работа называется прямо, почти как манифест: «Не заявляйте, что оптимизация под бенчмарк улучшает общий навык кодинга». Исследователи взяли модели, дообучили их на траекториях решения SWE-bench - то есть натаскали ровно под этот тест - и проверили, стало ли им лучше на других задачах.
Не стало. Прирост оставался внутри самого бенчмарка и почти не переносился ни на их собственный набор задач, ни даже на соседний тест LiveCodeBench. Модель становилась лучше в SWE-bench и ровно в SWE-bench. Вывод авторов сухой: одного-двух бенчмарков недостаточно, чтобы судить о реальной способности модели, когда под эти бенчмарки идёт оптимизация. Нужна разнородная проверка, а не одна заветная цифра.
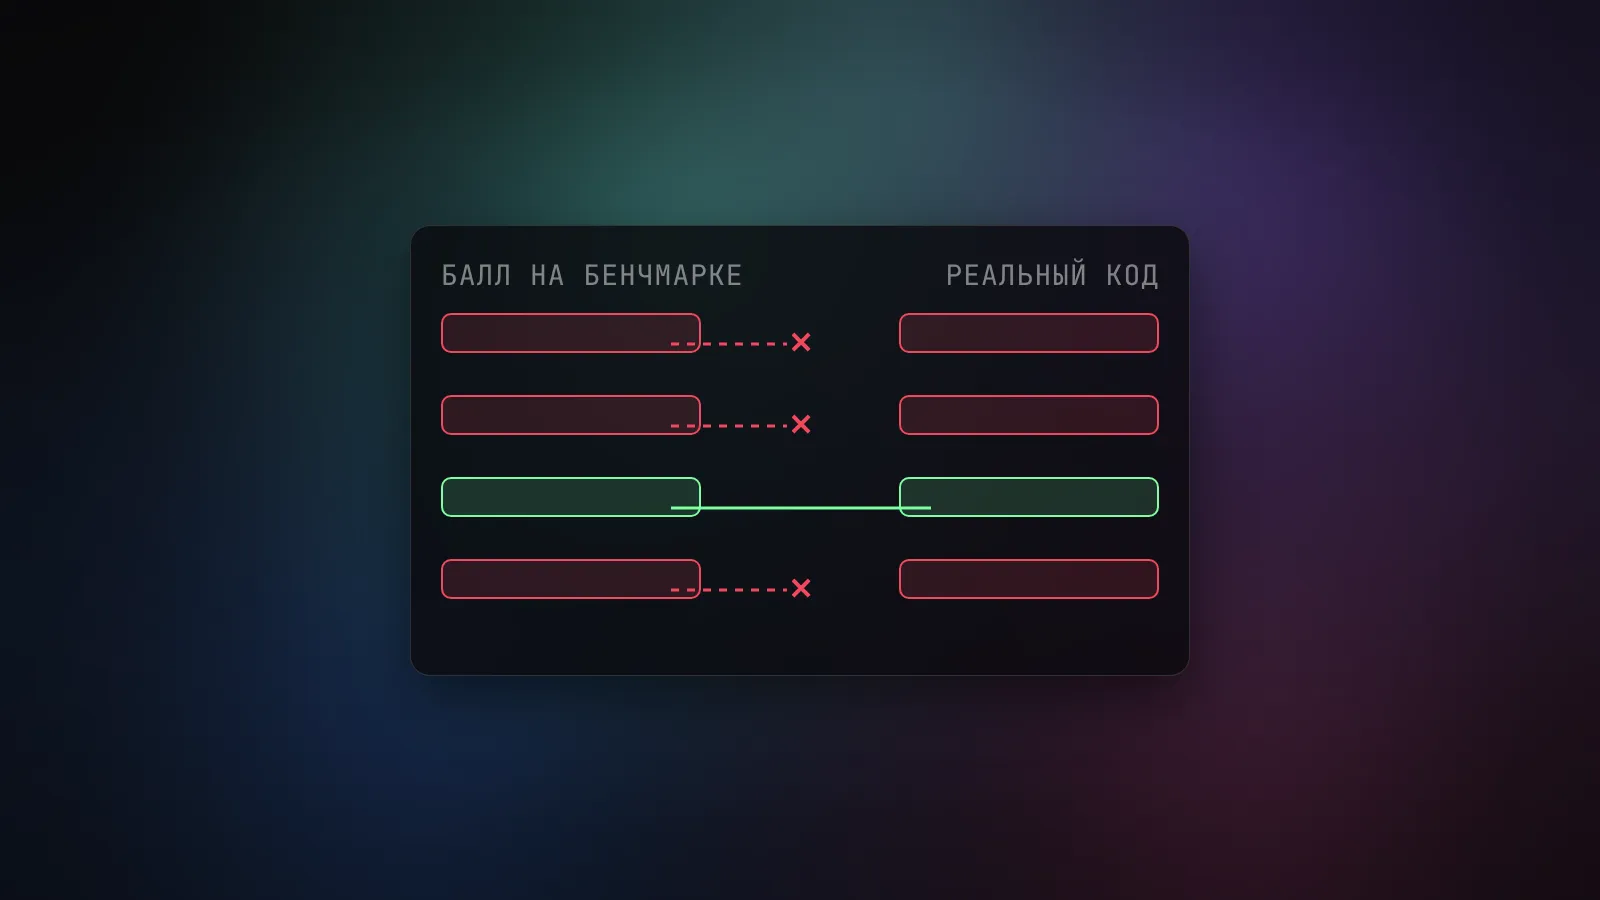
Для меня это ключевая мысль всей статьи. «Оптимизировали под бенчмарк» и «модель стала лучше писать код» - это два разных события, и первое не влечёт второе. А индустрия годами продавала нам первое под видом второго.
OpenAI сама вышла из игры
Самое показательное - что по этому же поводу сделала OpenAI. Компания, которая годами хвасталась баллами на SWE-bench Verified (это вычищенная версия теста из 500 задач), в начале 2026-го объявила, что больше не отчитывается по нему. Причём объяснила честно и с цифрами.
Они взяли те трудные задачи, которые их модели упорно не могли решить раз за разом, и вручную разобрали около 140 из 500. Оказалось, что почти в 60% из них сломаны сами тесты - модель писала верный патч, а кривой тест его заворачивал. Плюс нашлись признаки, что топовые модели видели решения бенчмарка на обучении. Балл, по их же словам, перестал что-либо значить.
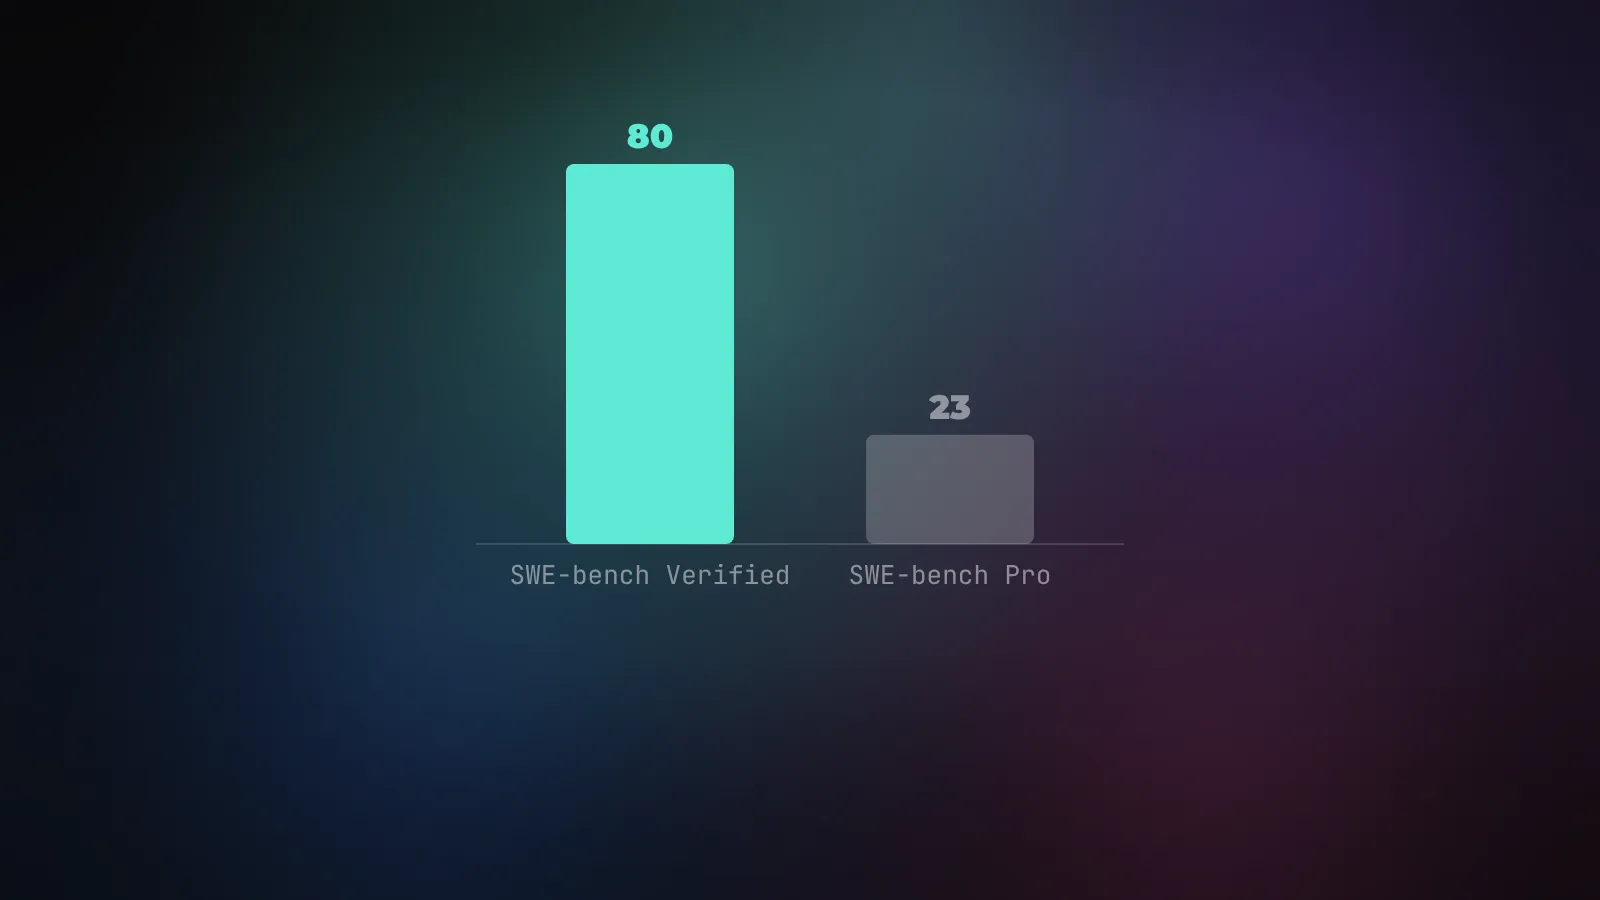
Есть более честный тест на замену - SWE-bench Pro, его специально собрали так, чтобы модели не могли выучить ответы заранее. И картина там отрезвляющая: модели, которые на старом Verified показывали 70-80%, на Pro проваливаются примерно до 23%. Те же модели. Разница только в том, видели они ответы заранее или нет.
Что это значит лично для тебя
Ты не пишешь научные статьи и не гоняешь бенчмарки. Ты выбираешь, на какой модели крутить своего агента, писать код, автоматизировать рутину. И вот тут прикладной вывод.
Балл в табличке - это не обещание, что модель справится с твоей задачей. Это в лучшем случае повод её попробовать. Реальную пригодность модели показывает только одно: как она ведёт себя на твоих собственных задачах, в твоём коде, в твоей обвязке. Не на 500 отобранных проблемах из Django, а на том, что нужно тебе.
Звучит банально, но именно этот шаг все пропускают. Проще посмотреть на цифру и переключиться, чем собрать пять своих типовых задач и честно прогнать по ним две-три модели. А ведь это единственная проверка, которая про тебя, а не про маркетинг вендора.
Как проверять модель по-человечески
Мой рабочий подход, без научных амбиций:
- Собери свой мини-набор. Пять-десять реальных задач, которые ты уже решал и знаешь правильный ответ. Твой код, твой стиль, твои грабли. Это твой личный бенчмарк, который никто не выучит заранее.
- Гоняй одну и ту же обвязку. Если сравниваешь модели - меняй только модель, а всё вокруг оставляй как есть. Иначе намеряешь разницу в лесах, а не в мозгах.
- Не верь одному числу. Смотри, где модель ошибается, а не только сколько раз. Одна дорогая ошибка в проде перевешивает три лишних процента в табличке.
- Свежий тест лучше старого. Если уж смотришь на публичные бенчмарки, ищи те, что обновляются и вычищаются от утечек, - вроде SWE-bench Pro или ротируемых наборов. Старый открытый тест меряет память.
Смысл не в том, что бенчмарки бесполезны и их надо игнорировать. Они полезны как первый грубый фильтр - отсеять совсем слабые модели. Но принимать по ним решение «переключаю весь рабочий процесс» - значит доверять цифре, которую полгода полировали под конкретный тест. Дальше решает твоя задача, а не чужая табличка.