14 октября 2026 г.
Anthropic заменила Git на Scion: зачем и что взять себе

Anthropic заменила Git собственным Scion внутри своего огромного монорепозитория: агентные правки и сборки стали слишком дорогими для прежней инфраструктуры зеркал. Это не сигнал срочно переезжать с Git. Scion недоступен как готовая замена для обычной команды; практически полезнее взять из его устройства три идеи: изолировать работу агентов, скачивать только нужные файлы и проверять изменения до деплоя.
Инженерный разбор Anthropic вышел 13 октября. В Reddit его уже пересказывают как «Claude убил Git». Я бы начал с другого вопроса: какая конкретно нагрузка сломала прежний процесс и в какой момент обычному разработчику понадобится задуматься об этом? Тут есть занятная история про инфраструктуру, а не объявление о смерти инструмента.
Что именно перестало работать
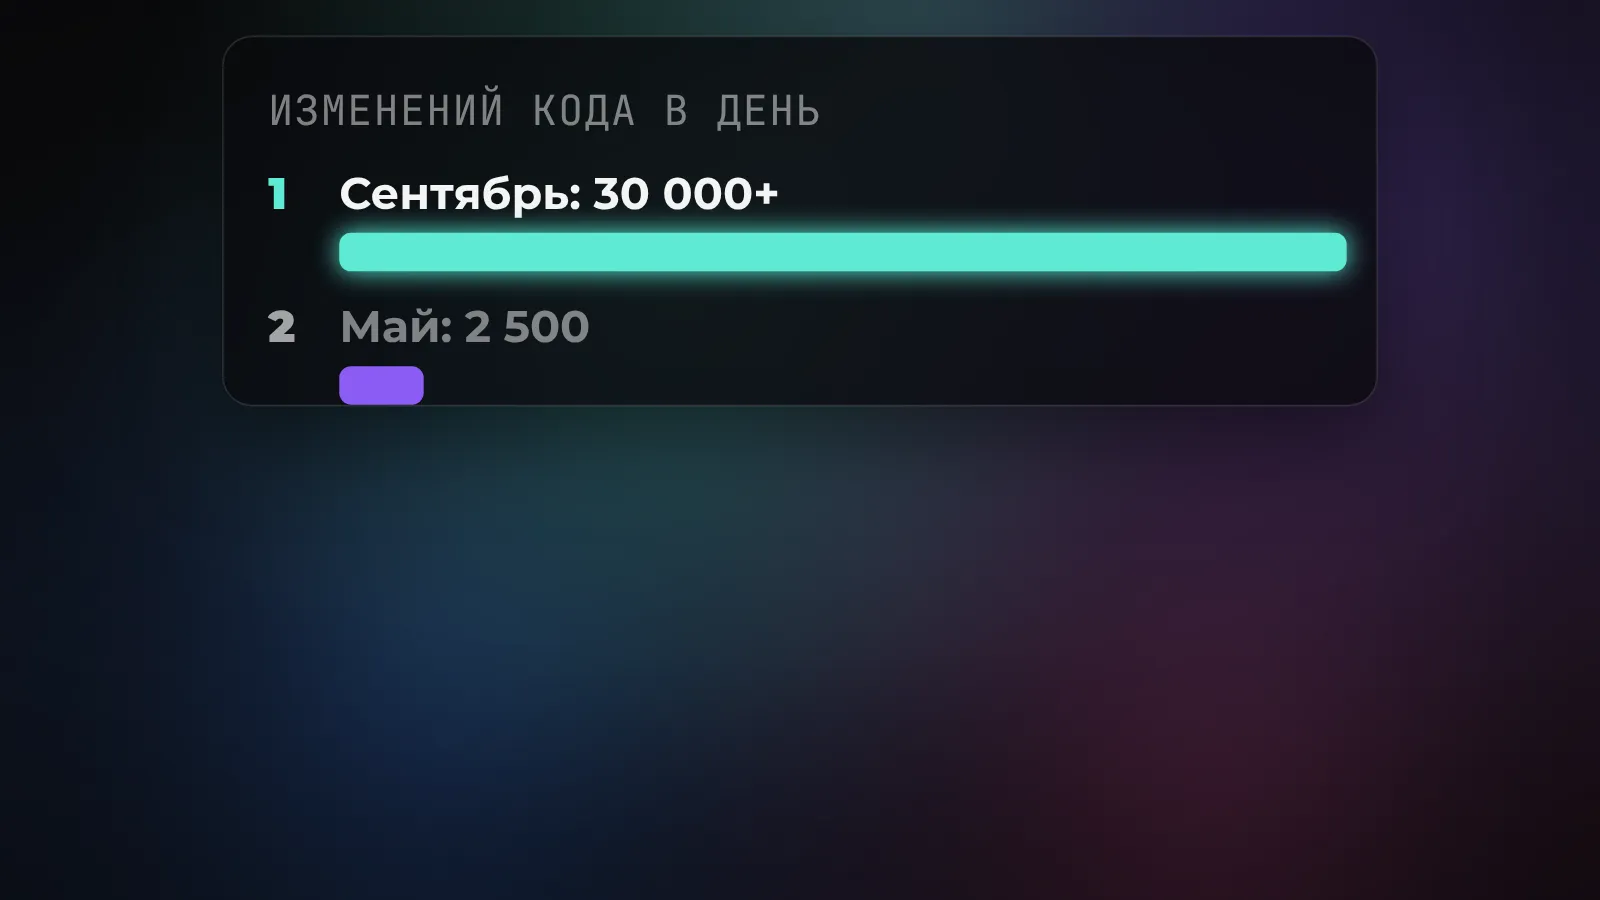
В мае, по внутренним подсчётам Anthropic, в основной репозиторий попадало около 2500 изменений кода за день. К сентябрю - больше 30 000. Компания связывает скачок с интенсивной работой Claude над собственными сервисами и исследованиями. Это число слитых изменений, а не число сотрудников или пул-реквестов, прошедших через публичный GitHub. Сравнивать его с активностью обычной команды напрямую бессмысленно.
Другой масштаб ещё нагляднее. История основной ветки занимает почти 100 ГБ, сжатая рабочая копия - больше 25 ГБ, а CI делает порядка 25 миллионов выдач кода за сутки. Если каждый раз тащить репозиторий целиком, только на эту операцию уходил бы чудовищный трафик. Авторы оценивают наивный вариант более чем в 600 петабайт в день; это расчёт сценария, от которого они как раз уходили, а не показание счётчика реальной сети.
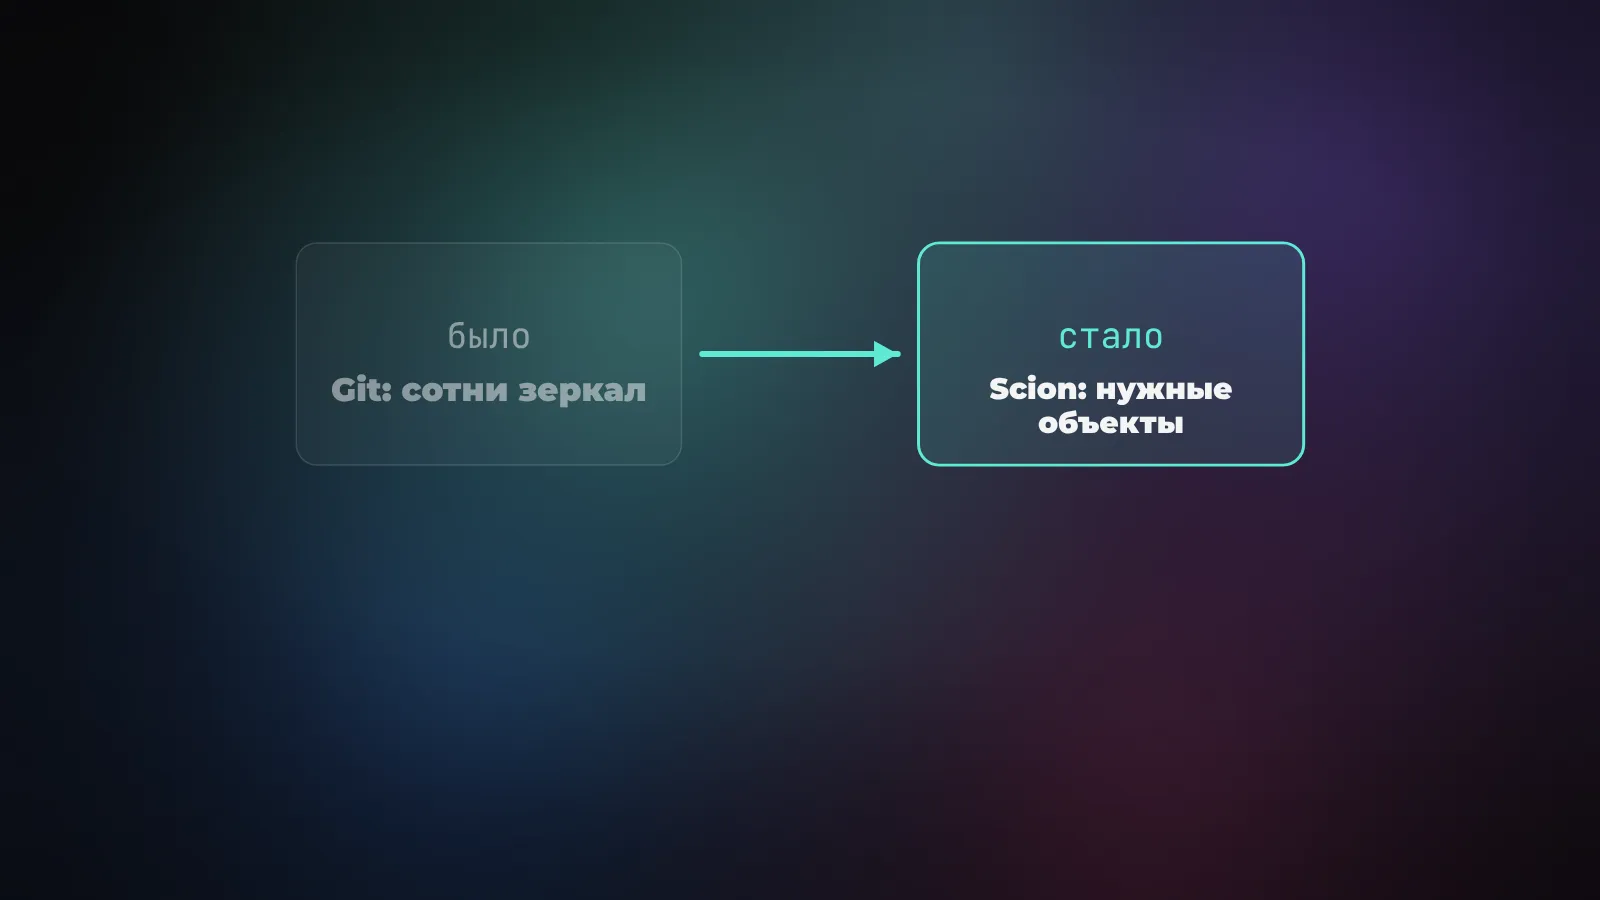
Anthropic уже применяла частичные клоны, разреженные рабочие копии, слепки репозитория и внутренние зеркала Git. В пике зеркал было несколько сотен. По мере роста частоты изменений слепки быстрее устаревали, а инструменты вроде blame и diff сложнее работали с неполной историей. То есть проблема не в том, что команда не знала про git clone --filter. Стандартные способы экономии были использованы, но сочетание огромного репозитория и очень большого числа коротких задач упёрлось в стоимость обслуживания всей цепочки.
Как Scion отличается от Git
Git даёт тебе автономную копию истории. Отключился интернет - всё равно можешь смотреть старые коммиты, делать новые, сравнивать ветки. Для личных проектов и большинства команд это огромное достоинство. Scion исходит из другого допущения: его агенты и CI почти всегда подключены к внутреннему серверу. Поэтому основная работа выполняется там, а клиент держит ограниченный кэш и только нужные файлы.
Вместо локального коммита с последующим push Scion создаёт запись об изменении на сервере. Авторы называют её changeset: список поменявшихся файлов и адреса их содержимого. Содержимое хранится отдельно по своему хешу. Данные для blame, поиска по пути и разбора родственных коммитов вычисляются в отдельных индексах. Сервис может ответить на вопрос о двух версиях кода, даже если у спрашивающего нет локальной копии монорепозитория.
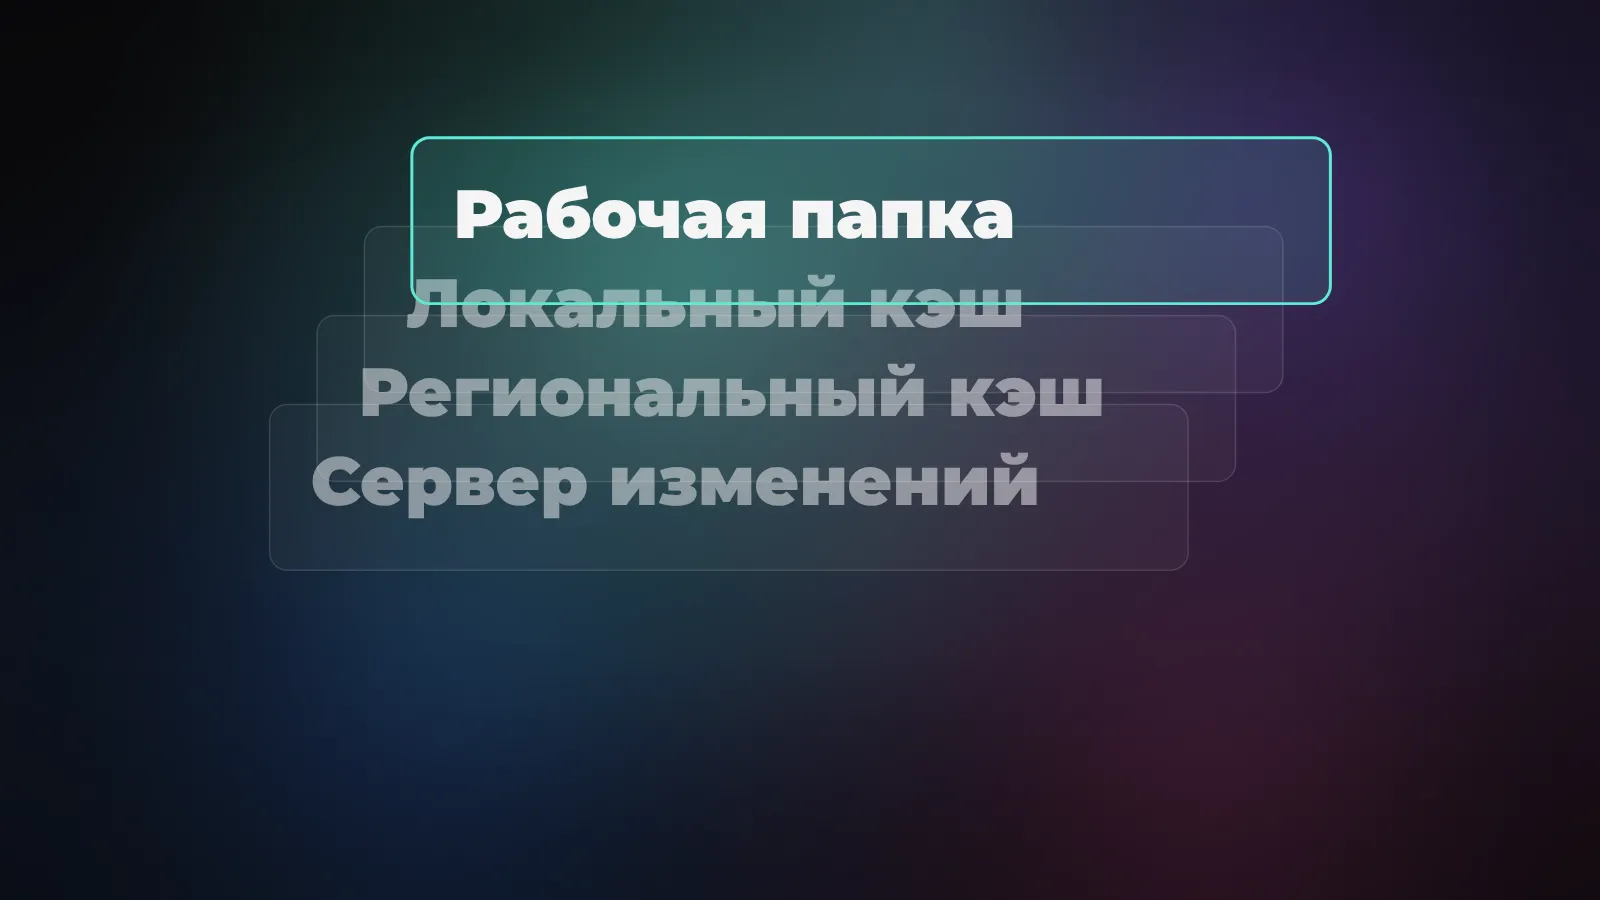
Мне нравится одно конкретное следствие: запрос на историю файла и запрос на сами файлы больше не обязаны проходить через скачивание всего репозитория. Scion отдаёт объект по запросу, а промежуточные кэши повторно используют его для соседних задач. Внутренняя система редко требует полноценной рабочей директории для проверки диффа. Когда файлы всё-таки нужны на диске, можно получить лишь выбранные папки или материализовать содержимое при обращении. Обратная сторона очевидна: зависимость от сервера и его доступности выше, чем у офлайнового Git.
Выигрыш в цифрах и важная оговорка
В публикации команды сказано: новая инфраструктура занимает в 200 раз меньше ресурсов CPU и памяти, чем прежняя система зеркал Git. Выдача кода для CI и исследовательских заданий стала быстрее примерно на два порядка, минуты сменились секундами. Только CI, по расчёту самой компании, освободил 25% вычислительной ёмкости. Это впечатляет, но это их замер для их старой архитектуры против их новой, не независимый бенчмарк «Scion быстрее Git в 200 раз».
Семь человек сделали Scion вместе с системой ревью Antique и несколькими сопутствующими сервисами за пять месяцев. Anthropic рассказывает, что в одной из переработок внутренний Claude сократил потребление памяти загрузчика истории в 20 раз, а время работы в четыре раза. Эта цифра относится к одному компоненту в их эксперименте. Из неё нельзя вывести, что любая команда агентов так же быстро напишет надёжный контроль версий.
Есть и менее рекламная деталь. Инженерам, по словам авторов, приходилось останавливать агента, когда тот выбирал алгоритм, который формально работает, но линейно читает историю там, где требовался индексированный запрос. Все изменения всё равно проходят человеческое ревью. А вместо привычной блокировки глобальной очереди слияния они сильнее полагаются на тесты после объединения изменений и перед деплоем. Это компромисс под их скорость, а не универсальный рецепт отменить тесты до слияния.
Можно ли поставить Scion у себя
Короткий ответ - нет готовой публичной инструкции, по которой ты повторишь внутренний стек Anthropic. Компания прямо пишет, что Scion существенно расходится с Git и для внешнего пользователя потребовал бы миграции ревью, поиска по коду и CI. Обещания скорого публичного релиза в статье нет. Команда делится принципами, а не бинарником для установки. Если видишь сайт с обещанием «скачай официальный Scion и замени Git за минуту», сначала проверь, кто его выпустил.
Здесь полезно сравнение с Sapling от Meta. Meta тоже создала свою систему для огромного монорепозитория, но открыла клиент, который умеет работать и с Git-репозиториями. Его серверные возможности не стоит путать с возможностями бесплатного клиента: Meta отдельно предупреждает, что часть оптимизаций требует специфического сервера. Anthropic пока пошла путём подробного рассказа об архитектуре вместо открытого клиента. Из обоих случаев следует простой вывод: эффект масштаба нельзя купить одной командой установки.
Что попробовать сегодня без замены Git
Если главная боль - два кодинг-агента правят одни файлы, дай им отдельные рабочие деревья. Официальное руководство Git подтверждает, что git worktree add создаёт ещё одну рабочую копию того же репозитория на собственной ветке. На чистом тестовом репозитории пример выглядит так:
git worktree add -b agent-search ../project-agent-search HEAD
git worktree list
После этого направь первого агента в основную папку, второго - в ../project-agent-search. У каждого своя рабочая директория, а изменения объединяются через привычный PR и ревью. В существующем проекте предварительно проверь git status и выбери папку вне рабочих данных: команда создаёт новую директорию и ветку, но не переносит туда незакоммиченные правки из основной папки. Не используй этот пример как повод чистить живой репозиторий командой git clean.
Если тормозит загрузка большого проекта, Git поддерживает частичный и разреженный клон: --filter=blob:none откладывает скачивание содержимого файлов до обращения к нему, а --sparse сначала выдаёт только корневые файлы. Папки можно открыть командой git sparse-checkout set src docs в новом клоне, если в проекте правда есть src и docs. Проверь структуру репозитория до команды: в некоторых проектах нужные исходники лежат совсем в других каталогах. Документация sparse-checkout поясняет важное различие: файлы вне выбранных папок остаются в репозитории, просто отсутствуют в рабочей копии. Фильтр и разреженность помогают экономить трафик и диск, но не превращают Git в сервер Scion с его собственными API.
Третье - считать результатом агента принятый и проверенный патч, а не число сгенерированных коммитов. Для пары агентов хватит раздельных веток, тестов на каждом PR, запрета прямой записи в основную ветку и проверки результата уже после объединения. Если очередь слияния перегружена, измерь отдельно время клонирования, установки зависимостей, прогона тестов и ожидания ревью. Лечить самый длинный участок проще, чем переписать целиком систему контроля версий.
Где здесь предел и что я бы сделал
Мне кажется, этот релиз полезнее читать как историю о цене агентного потока. Дешевле и быстрее писать код - не значит дешевле интегрировать его в продукт. Одновременно растёт количество сборок, обращений к истории и точек, где конфликтуют изменения. Это пересекается с тем, что я уже разбирал про гонки между агентами: если много исполнителей разделяют одно состояние, скорость генерации может увеличить очередь на проверку.
На одном своём проекте я бы начал с измерения, а не с нового VCS. Взял бы пару независимых задач, разнёс по веткам или worktree, поставил обязательные тесты до принятия PR и один контрольный прогон после слияния. Если станет медленно, посмотрел бы в журнале CI, где уходят минуты. Только когда окажется, что сотни или тысячи заданий многократно клонируют один гигантский репозиторий, начнётся разговор о другой архитектуре выдачи кода.
Scion сейчас решает проблему Anthropic, а Git продолжает решать мою. Но хороший вопрос после этой новости стоит задать уже сегодня: какая часть твоего процесса была рассчитана на одного человека с одним рабочим каталогом, а теперь ею пользуются одновременно несколько агентов?
Источники
- Anthropic Engineering: Redesigning source control at Anthropic - исходные замеры, архитектура, ограничения публичного выпуска.
- Meta Engineering: Sapling, source control that’s user-friendly and scalable - независимый опыт большого монорепозитория.
- Meta Engineering: Branching in a Sapling Monorepo - ограничения ветвления при масштабе.
- Git: git-worktree - синтаксис и границы рабочих деревьев.
- Git: git-clone и git-sparse-checkout - фильтр объектов и выбор папок.
- VS Code: Choose code isolation - отдельно о worktree и правах агента.