20 августа 2026 г.
Больше AI-агентов - не значит лучше: почему система ломается от количества

Больше AI-агентов в системе - не значит надёжнее: по свежей position-работе на arXiv («Мультиагентным системам пора заняться контролем конкурентного доступа»), добавление агентов часто снижает надёжность, а не повышает. Причина не в том, что модели тупые - несколько агентов начинают одновременно лезть к общему состоянию и мешать друг другу, теми же граблями, что давно известны из мира баз данных.
Интуиция подсказывает простое: если агенту тяжело, посади на задачу пятерых - будет быстрее и надёжнее. Я сам так собирал свой цифровой офис. Разбираю, откуда растёт эта проблема и что с ней делать, если ты строишь что-то на нескольких агентах.
Откуда вообще берётся проблема
Один агент - это предсказуемо. Он читает состояние, думает, пишет результат, идёт дальше. Пока он один, никто у него из-под рук данные не выдёргивает.
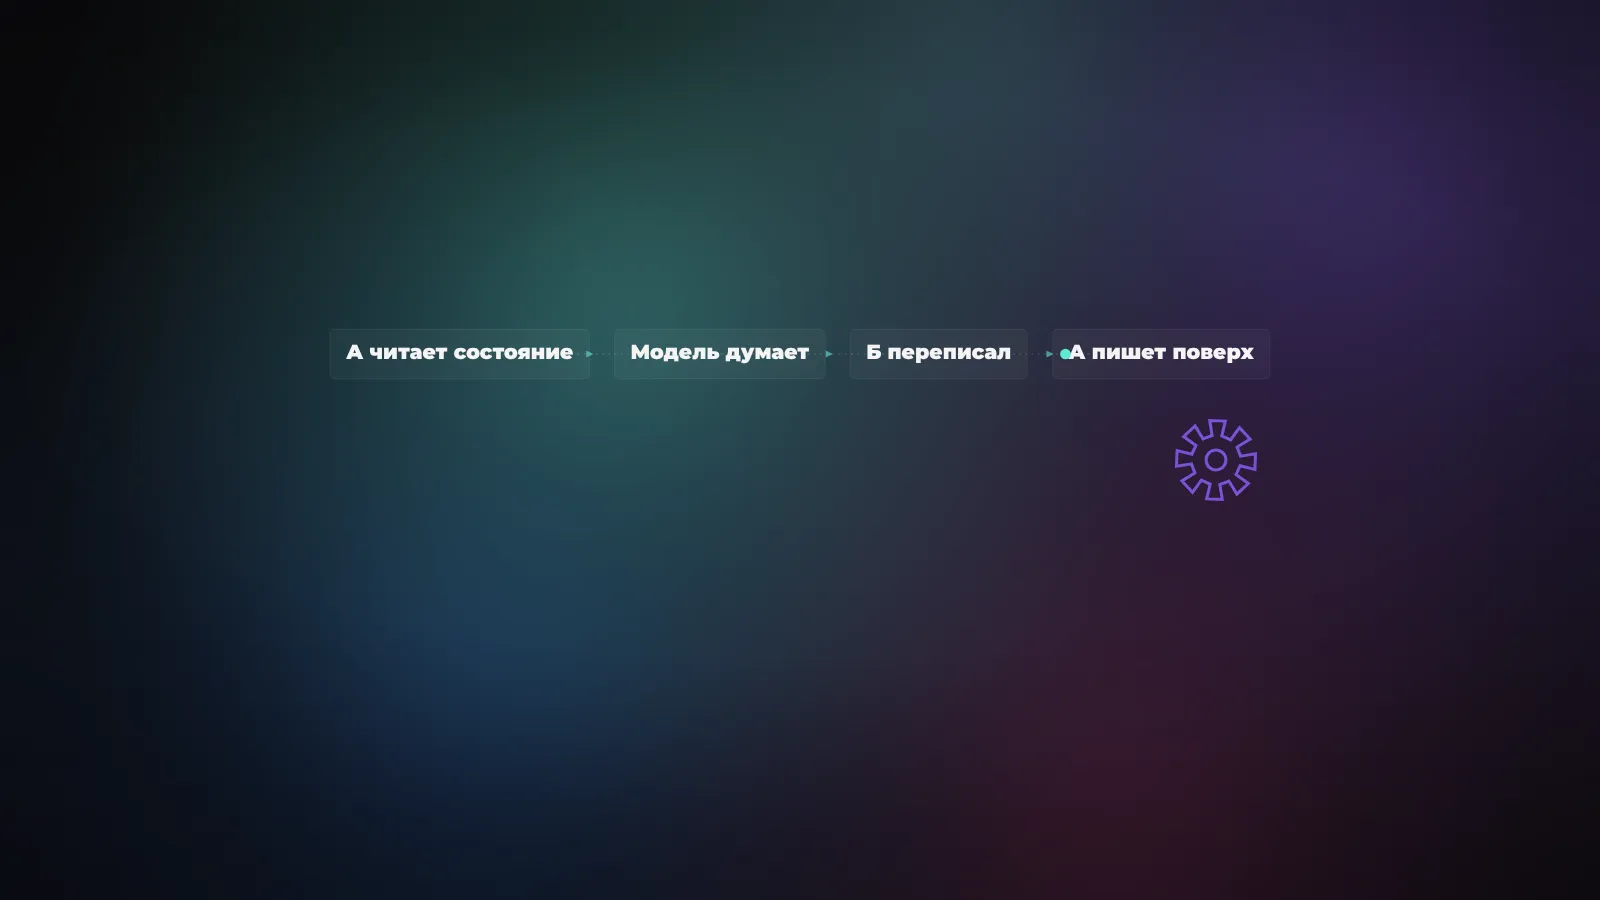
Как только агентов становится двое и больше, а работают они с общими данными - общий файл, строка в базе, документ, состояние задачи - начинается веселье. Агент А прочитал состояние. Агент Б в это же время его меняет. Агент А, ничего не подозревая, дописывает свой результат поверх и затирает то, что успел сделать Б. Оба «отработали успешно», а на выходе - каша, которую система молча приняла за правильный результат.
Ключевое слово тут - «молча». Ошибка не падает с красным стектрейсом. Всё выглядит так, будто задача решена. Ты замечаешь беду сильно позже, когда данные уже разъехались, и концов не найти.
При чём тут базы данных
Самое интересное в этой работе - авторы говорят: ничего нового мы не изобрели, это классические аномалии конкурентного доступа, которые в мире баз данных разобрали ещё десятилетия назад. У них даже названия есть.
Грязное чтение (dirty read) - агент читает данные, которые другой агент ещё не «зафиксировал», то есть может передумать и откатить. Ты построил решение на цифре, которой через секунду не станет.
Потерянное обновление (lost update) - двое одновременно правят одно и то же, и одно изменение затирает другое без следа. Классический пример из баз: на складе 10 единиц товара, один процесс резервирует 7, другой в тот же момент резервирует 5, оба видели «10 в наличии» и оба записали свой результат. Итог - минус два товара, которых нет.
Несогласованный итог - каждый агент по отдельности отработал правильно, но их изменения противоречат друг другу, и общая картина разваливается.
В базах данных с этим борются десятилетиями. Придумали изоляцию транзакций, уровни изоляции, блокировки, проверку версий. Вся буква «I» в слове ACID (isolation) - ровно про это: сделать так, чтобы параллельные операции давали такой же результат, как если бы шли по очереди. Мультиагентные системы сейчас наступают на те же грабли, только заново и без этого багажа знаний.
Почему у агентов это больнее, чем у баз
Тут есть неприятный поворот. В базе данных транзакция длится миллисекунды. Окно, в котором два процесса могут столкнуться, узкое.
У агента между «прочитал» и «записал» стоит вызов большой модели. А это не миллисекунды - это секунды, а иногда и минуты рассуждений. Агент А прочитал состояние, ушёл на шесть секунд думать, а за эти шесть секунд агент Б уже всё поменял. Когда А наконец возвращается со своим решением, он действует на данных, которых давно нет. Инженеры называют это семантической гонкой: сам конфликт такой же, как в базе, но растянут по времени в тысячи раз.
И чем больше агентов, тем хуже - причём нелинейно. Два агента - это одна пара, которая может столкнуться. Пять агентов - это уже десять пар. Число возможных столкновений растёт как число пар, то есть квадратично. Добавил в систему пару агентов «для надёжности» - и незаметно умножил количество мест, где всё может пойти вразнос.
Цифры: насколько сильно всё разъезжается
Тут помогает более ранняя большая работа исследователей из Беркли - они собрали первую подробную таксономию провалов мультиагентных систем. Разобрали больше 1600 реальных логов работы агентов на семи разных фреймворках и вытащили 14 типовых режимов отказа, сгруппированных в три категории: кривая постановка задачи, рассогласование между агентами и провал проверки результата.
Главная цифра для нашего разговора вот какая. В системах без нормальной координации ошибка одного агента усиливается по цепочке - другие подхватывают кривой промежуточный результат и множат его. По их замерам, усиление доходило до 17 раз. А в системах с централизованной проверкой, где есть узел-контролёр, тот же эффект удавалось сдержать примерно до 4,4 раза. Разница между «добавили агентов как попало» и «добавили с координатором» - вчетверо по устойчивости к ошибкам.
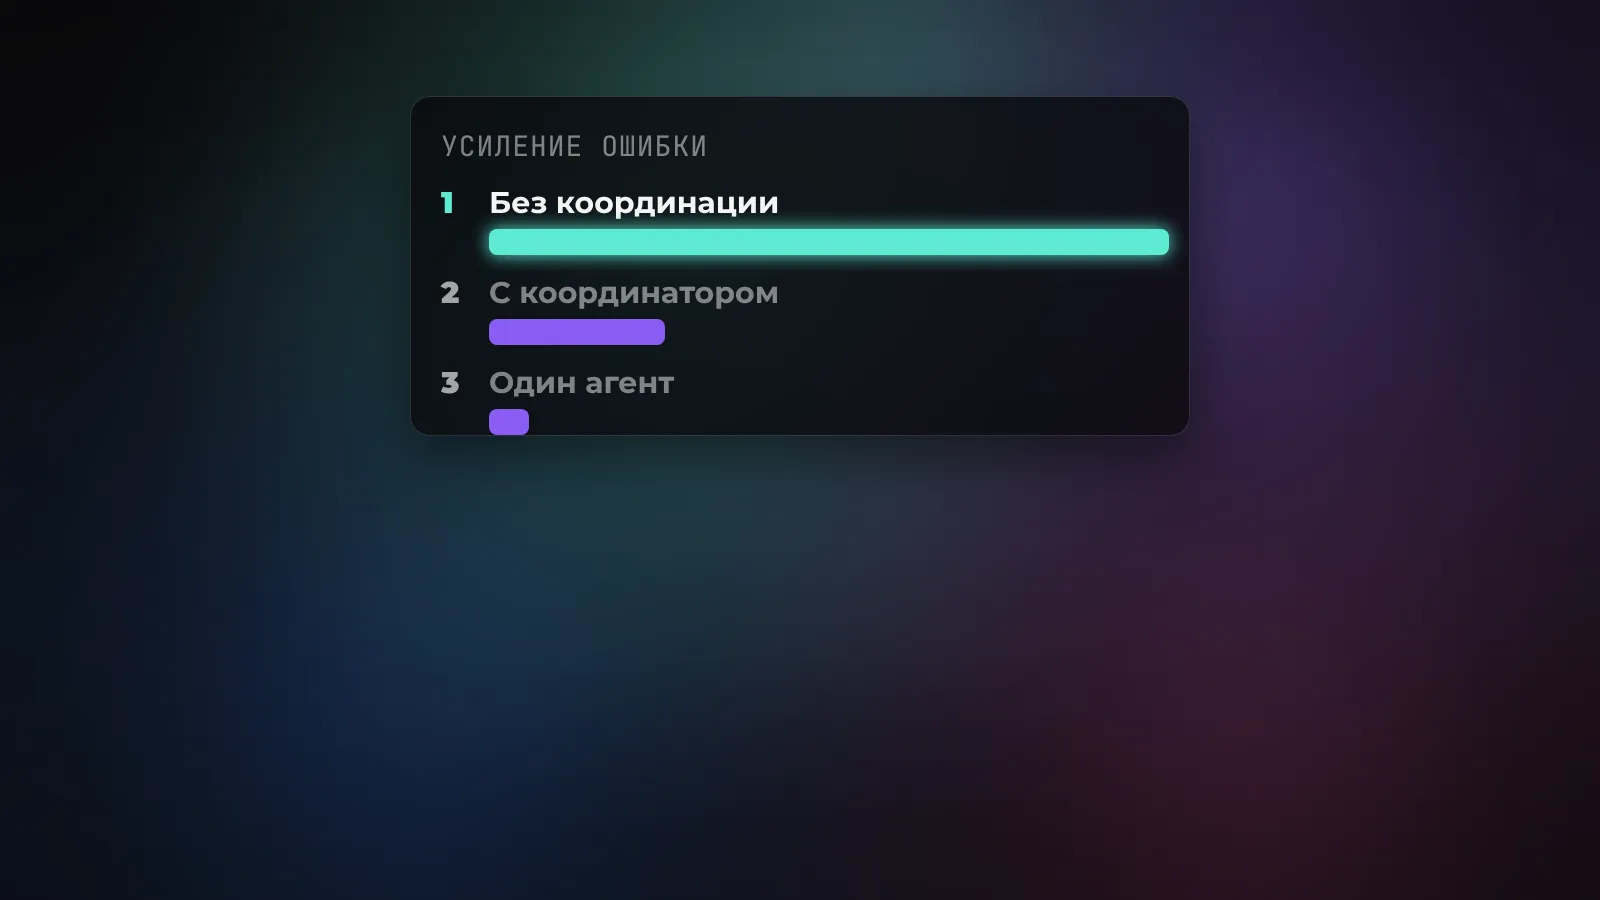
И ещё их вывод, который стоит повесить на стену: больше половины провалов - это не тупость модели, а именно кривая архитектура системы. Проблема не в том, что агент «недостаточно умный». Проблема в том, как агенты между собой устроены.
Как с этим борются
Хорошая новость - решения тоже давно известны, их просто надо перенести из мира баз данных в мир агентов. Несколько рабочих подходов.
Семантические блокировки. Пока агент А работает над задачей, он «берёт замок» на сущность - конкретный аккаунт, документ, кусок состояния. Пока замок его, другие агенты к этой сущности не лезут. Важная деталь: у замка ставят таймаут с запасом на самое долгое рассуждение модели, иначе один зависший агент застопорит всех.
Пессимистичный сценарий - очередь. Для задач, где цена ошибки высокая (деньги, платежи, критичные данные), агента Б просто ставят в очередь: подожди, пока А отпустит состояние, потом прочитаешь свежее и пойдёшь. Медленнее, зато без сюрпризов.
Оптимистичный сценарий - проверка версии. Для потока задач, где столкновения редки, поступают наоборот. Агент запоминает версию данных до того, как ушёл думать. Перед записью проверяет: версия не поменялась? Если поменялась - перечитывает свежее состояние и передумывает. Иногда впустую сожжёт токены, зато не затрёт чужое.
Песочница и слияние. Сложные операции гоняют в изолированной копии - как отдельная ветка в гите. Агент творит что хочет в своей песочнице, а изменения вливают в общее состояние отдельным аккуратным шагом, где уже всё детерминированно.
Что это значит лично для тебя
Если ты собираешь что-то на нескольких агентах - неважно, цифровой офис, контент-завод или бот под бизнес - выводы простые.
Первое: не добавляй агентов «для надёжности». Каждый новый агент, который лезет к общим данным, добавляет не столько рук, сколько новых мест для столкновений. Сначала спроси - им точно нужен общий доступ или можно развести по отдельным зонам.
Второе: развязывай состояние. Пусть агенты по возможности общаются сообщениями и не дёргают одну и ту же общую строку. Один пишет - остальные читают. Это скучно, зато работает.
Третье: если общий доступ неизбежен - ставь координатора. Один узел, который следит за очередью и проверяет результат, по замерам держит усиление ошибок вчетверо ниже, чем свалка равноправных агентов.
И четвёртое, самое отрезвляющее. Когда твоя мультиагентная система выдаёт ерунду, первым делом хочется обвинить модель - мол, поглупела, не тянет. Но чаще беда не в модели, а в том, что двое твоих агентов молча наступили друг другу на данные. Чинить надо не промпт, а архитектуру. Я это на своём офисе прочувствовал: чем больше параллельных сессий, тем чаще ловишь ровно эти тихие гонки - и лечится оно не более умной моделью, а более честными границами между агентами.