21 августа 2026 г.
Рейтинг нейросетей 2026: какая лучше под какую задачу
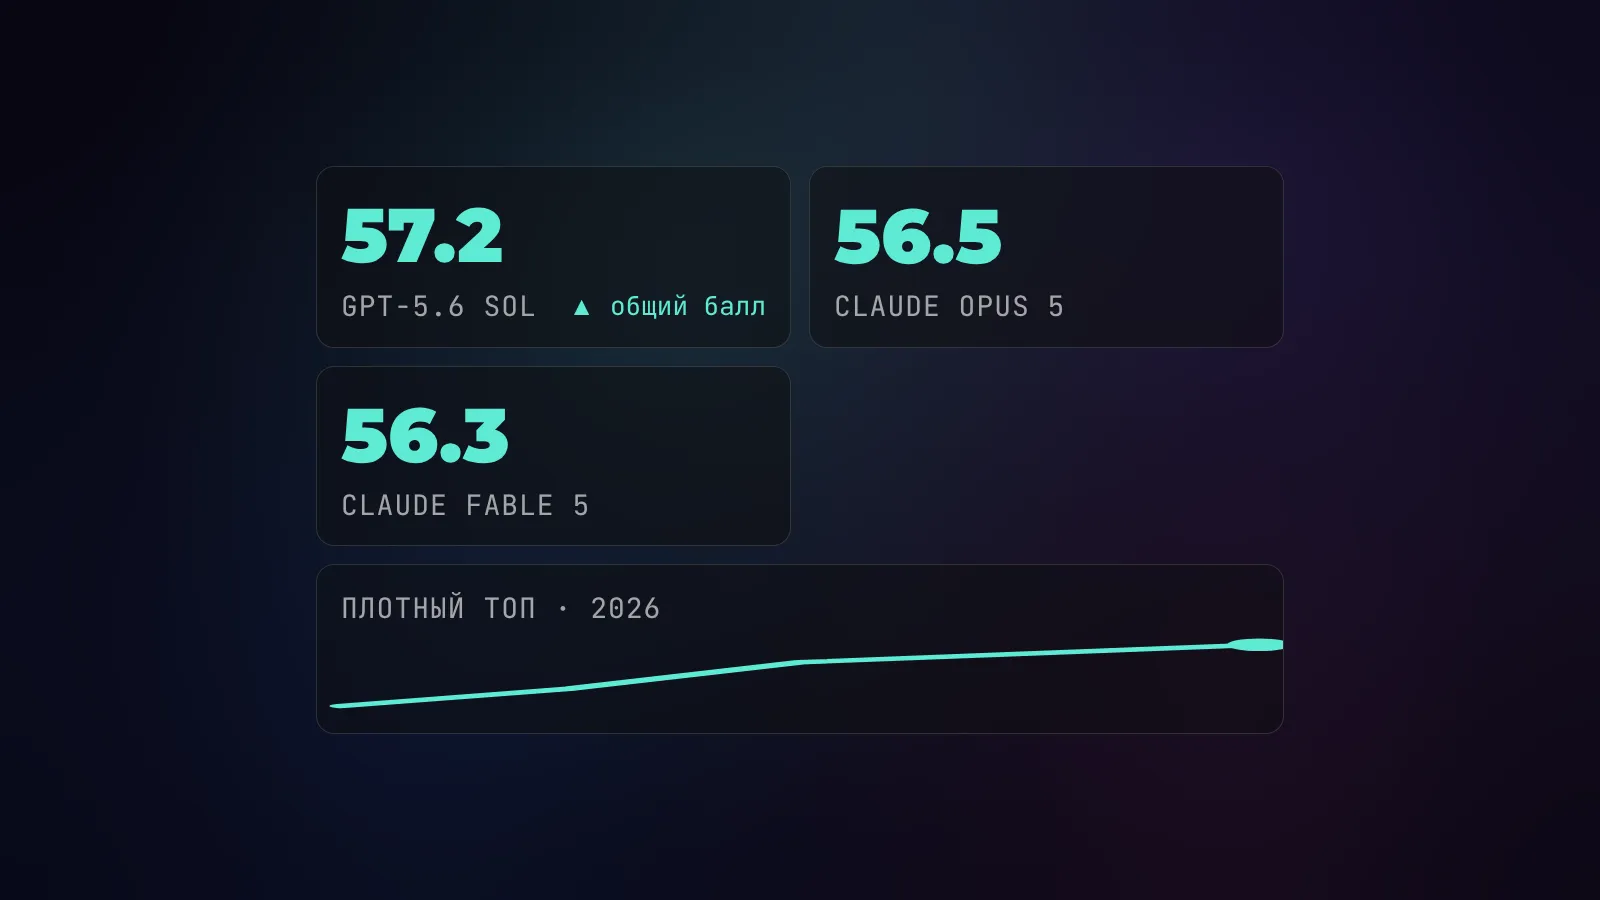

Единой лучшей нейросети в 2026 году нет, и любой рейтинг нейросетей врёт, пока не назвал задачу. По агрегированным замерам на август 2026 в коде впереди GPT-5.6 и Claude Fable 5, в чистом рассуждении - Gemini 3.1 Pro, а в дешёвом объёме - DeepSeek. Выбор модели - это выбор под конкретную работу, а не поиск одного чемпиона.
Дальше разберу сравнение нейросетей по четырём направлениям, которые реально закрывают рабочие задачи: код, текст и рассуждение, картинки и цена. Цифры беру из открытых бенчмарков и прайсов вендоров на момент написания - они двигаются каждый месяц, поэтому смотри не на второй знак после запятой, а на расклад сил.
Почему единого рейтинга нейросетей не существует
Когда спрашивают «какая нейросеть лучше», обычно ждут одно имя. Но модели давно разошлись по специализациям. Одна вылизана под код и агентные цепочки, другая - под длинный контекст и рассуждение, третья просто дешёвая и тянет объём. Топ общего зачёта в 2026 плотный: GPT-5.6 Sol, Claude Opus 5 и Claude Fable 5 идут почти вплотную, разница в доли балла. На таком разрыве общий рейтинг уже ничего не решает - решает то, что ты собираешься делать.
Поэтому дальше я не выстраиваю модели в одну колонку от лучшей к худшей. Вместо этого показываю, кто выигрывает в каждой отдельной задаче. Так рейтинг превращается из спора «кто круче» в рабочий инструмент выбора.
Рейтинг по коду: кто пишет лучший код
Для программирования картина самая понятная. На бенчмарке SWE-bench Verified, где модель чинит реальные баги в открытых репозиториях, впереди GPT-5.6 Sol и Claude Fable 5 - обе перешагнули отметку 95%. Дальше идёт кластер сильных, но чуть отстающих: Claude Opus 4.7, Claude Sonnet 5, а за ними DeepSeek V4 и Gemini 3.1 Pro в районе 80%.
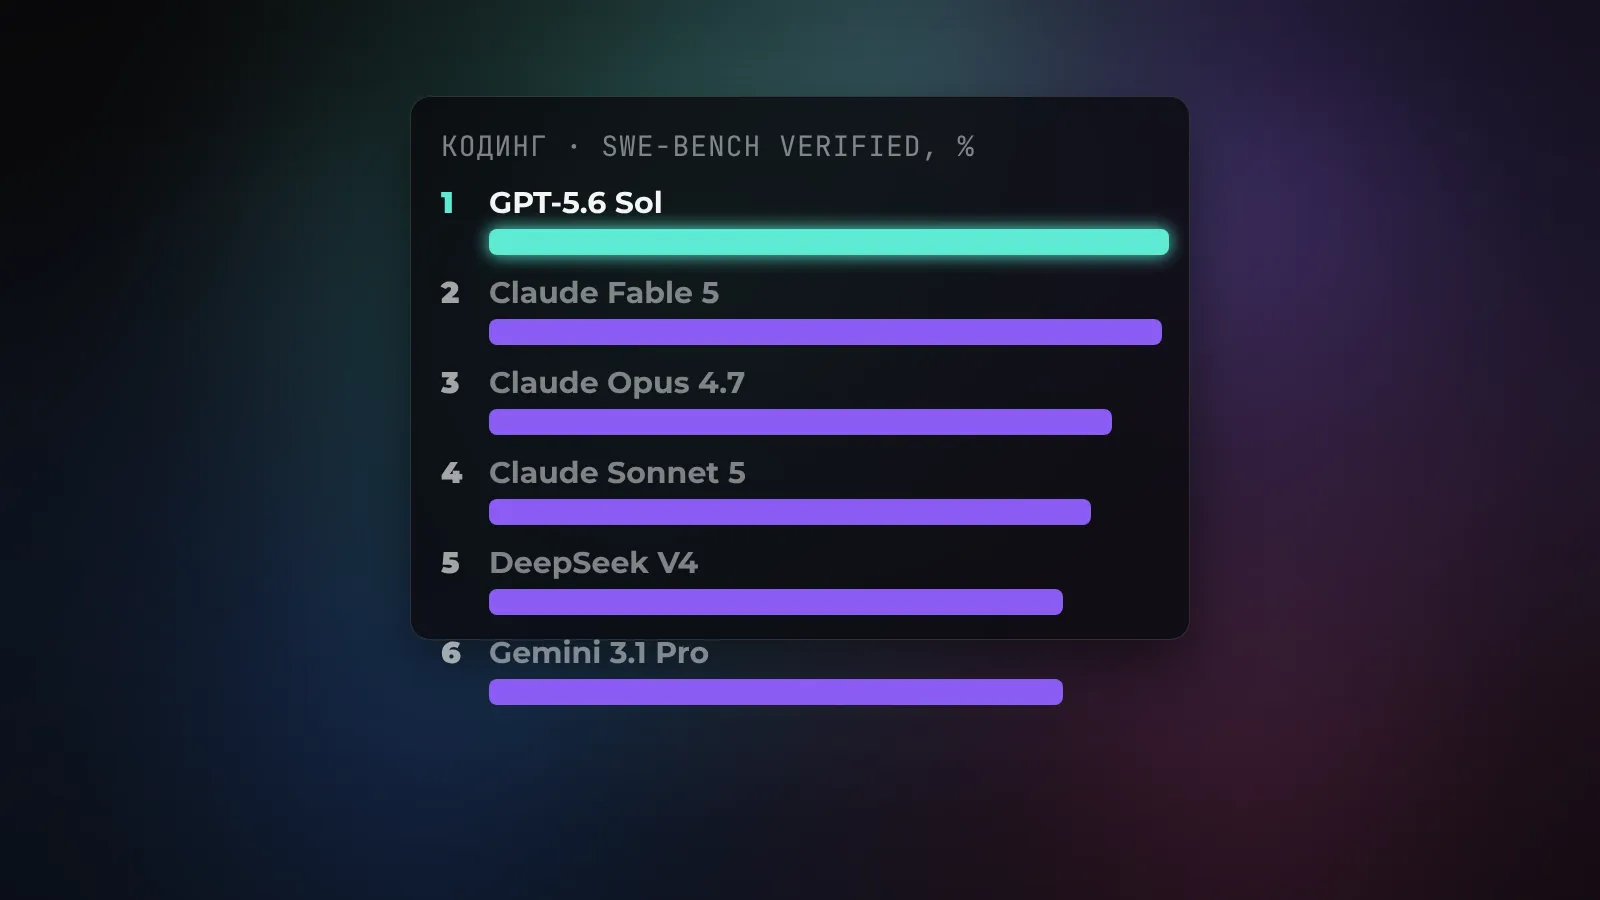
Но у голого процента есть подвох. Бенчмарк меряет решение изолированной задачи, а в реальной работе с кодом важнее, как модель ведёт себя в агентном режиме: держит контекст большого проекта, не ломает соседние файлы, доводит многошаговую правку до конца. Здесь семейство Claude заслуженно любят разработчики - не столько за пиковый балл, сколько за поведение в длинной сессии. GPT-5.6 отвечает мощным пиком и хорош в разовых сложных задачах.
Рейтинг по тексту и рассуждению
С текстом всё субъективнее, чем с кодом, но закономерности есть. Для рассуждения, разбора сложных вопросов и работы с длинными документами сильнее всего показывает себя Gemini 3.1 Pro - на бенчмарке GPQA Diamond, где нужны научные рассуждения уровня аспиранта, у него самый высокий результат среди всех. Плюс большое контекстное окно, куда влезает целая книга или пачка отчётов.
Для живого текста, редактуры и того, что читают люди, многие продолжают выбирать Claude - у него меньше воды и канцелярита из коробки. GPT-5.6 традиционно силён в креативе и свободных форматах. По сути на текстовых задачах нет одного победителя: бери две модели и сравнивай на своём стиле, разница будет заметна на глаз.
Картинки: отдельная лига
Генерация изображений живёт отдельно от текстовых моделей, и рейтинг тут свой. К 2026 году рынок ушёл от «забавных картинок» к рабочему инструменту с точным рендерингом текста и стабильными персонажами.
- Nano Banana (движок на базе Gemini) - лидер по фотореализму и по тексту внутри картинки, быстрый апскейл.
- Midjourney - индустриальный стандарт для художественной иллюстрации и переноса стиля через мудборды.
- FLUX от Black Forest Labs - безупречный рендеринг логотипов и типографики, удобен для продуктовой графики.
Если задача - фотореализм или надпись на изображении, смотри в сторону Nano Banana или FLUX. Если нужна авторская иллюстрация с настроением - Midjourney по-прежнему держит планку.
Цена и бесплатные варианты
Цена разводит модели сильнее, чем баллы. Разброс по стоимости вывода отличается в сотни раз, и для объёмных задач это решает больше, чем один процент на бенчмарке.
| Модель | Вход, $/1М | Выход, $/1М | За что берут |
|---|---|---|---|
| GPT-5.6 Sol | 5 | 30 | пик по коду и креативу |
| Claude Opus 5 | 5 | 25 | код и агентные цепочки |
| Claude Sonnet 5 | 3 | 15 | рабочая лошадка на каждый день |
| Gemini 3.1 Pro | 2 | 12 | рассуждение и цена/качество |
| DeepSeek V4 | ~0.4 | ~0.9 | дешёвый объём и фон |
| Claude Haiku 4.5 | 1 | 5 | быстрые лёгкие задачи |
Бесплатно попробовать сегодня можно почти всё: у ChatGPT, Claude и Gemini есть бесплатные тарифы с лимитами, DeepSeek дешёвый настолько, что для большинства личных задач счёт выходит копеечный. Если строишь на модели свой продукт и гоняешь миллионы токенов, дешёвая DeepSeek или Gemini на фоновых задачах экономят больше, чем даёт переход на самый топовый флагман.
Какая нейросеть под какую задачу
Если свести всё к одной шпаргалке, рейтинг превращается в короткую таблицу соответствий. Не «лучшая нейросеть», а «лучшая под эту работу».
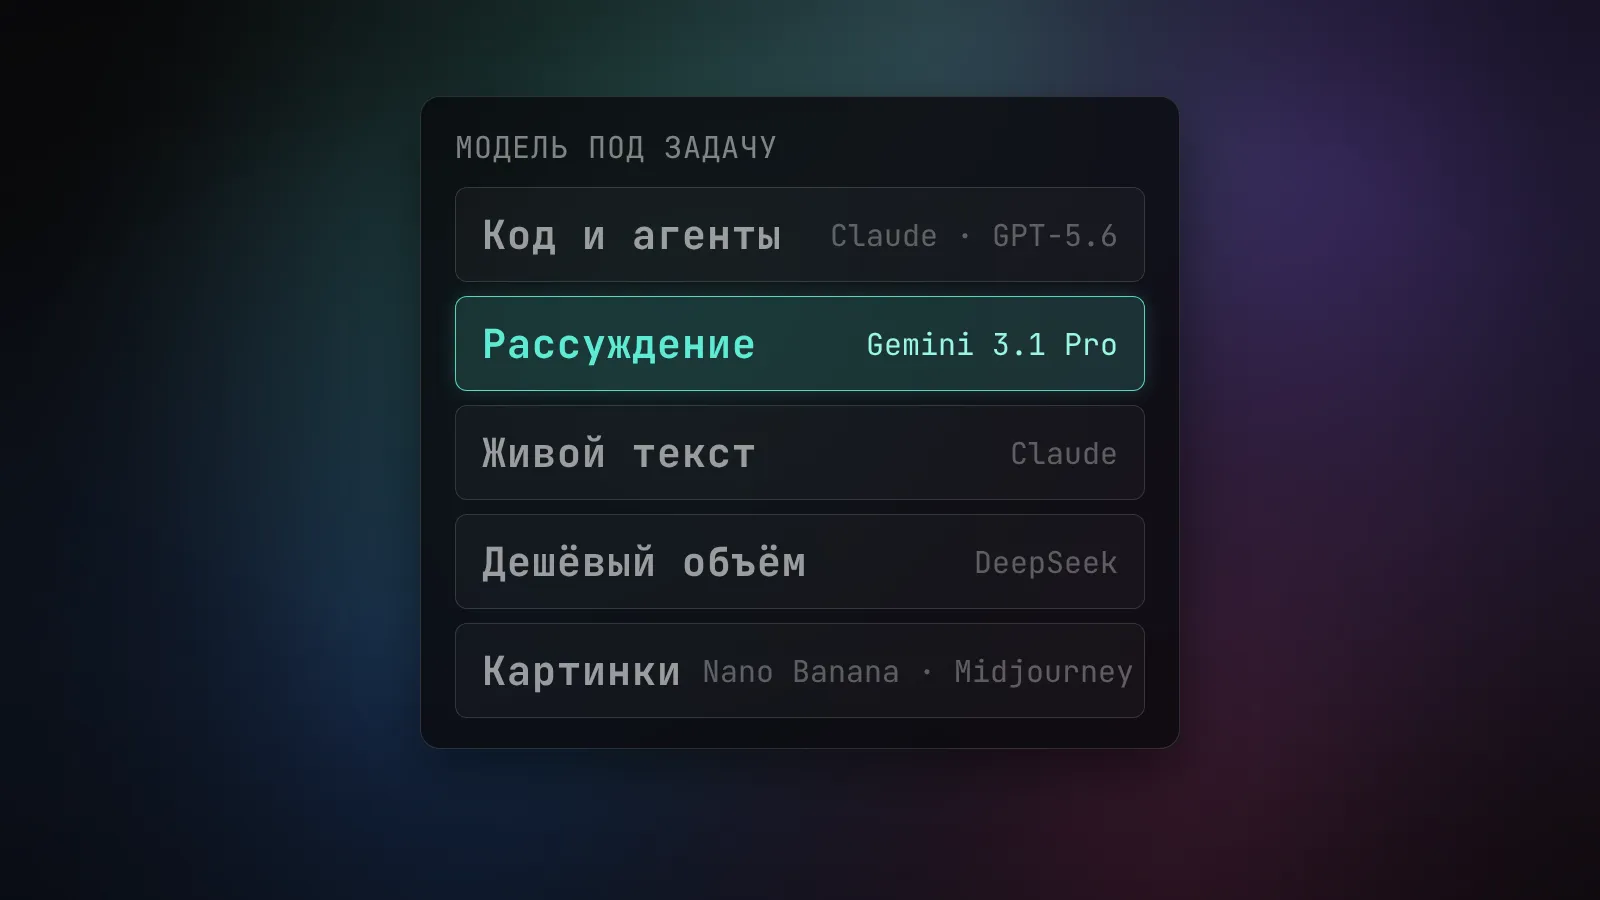
- Код и автоматизация - Claude (Opus 5, Sonnet 5) и GPT-5.6, особенно в агентном режиме.
- Рассуждение и длинные документы - Gemini 3.1 Pro, большой контекст и лучший результат в науке.
- Живой текст и редактура - Claude, меньше воды на выходе.
- Дешёвый объём и фоновые задачи - DeepSeek, цена в разы ниже.
- Картинки - Nano Banana или FLUX для фотореализма, Midjourney для иллюстрации.
Что выбрать в итоге
Если хочешь одну модель на всё и не думать - бери что-то из связки Claude или GPT-5.6, они закрывают большинство задач с запасом. Если считаешь деньги на объёме - добавь дешёвую DeepSeek или Gemini на фоновую рутину, а флагман оставь для сложного.
Но главный вывод рейтинга не в именах, а в подходе. Сильные команды в 2026 не выбирают одну нейросеть навсегда - они роутят задачи между моделями: Claude на код, Gemini на разбор, дешёвую модель на поток. Рейтинг нейросетей полезен ровно до тех пор, пока помнишь, что верхняя строчка меняется от задачи к задаче. Возьми две-три модели под свои реальные задачи, прогони неделю - и свой личный рейтинг ты соберёшь точнее любого бенчмарка.