30 октября 2026 г.
Рейтинг китайских нейросетей: Qwen, DeepSeek, Kimi и GLM по рабочим задачам

Рейтинг китайских нейросетей полезен только с указанием задачи. Qwen удобен, когда нужен выбор моделей в каталоге Alibaba; DeepSeek стоит проверить для текстового API; Kimi интересен для работы с длинными материалами; GLM - ещё один вариант для текстовых задач и агентных интеграций. Ни один из них не станет победителем без теста на ваших документах и бюджете.
Четыре имени в заголовке обозначают семейства продуктов, а не четыре неизменные модели. У каждого есть чат для человека, API для разработчика или несколько версий с разными условиями. Я не буду объявлять лидера по одному скриншоту бенчмарка: лучше покажу, какие именно вопросы задать каждому сервису до подписки или подключения к рабочему процессу.
Рейтинг китайских нейросетей: по каким критериям сравнивать
Сначала определим работу. Одно дело - задать вопрос о письме в чате, другое - провести через API длинный договор или поручить агенту читать файлы проекта. Даже внутри одного бренда для этих задач могут использоваться разные модели. Каталог Alibaba Model Studio перечисляет несколько вариантов Qwen, а прайс Z.AI - несколько вариантов GLM. Выбор только по названию бренда скрывает эту разницу.
Для проверки я бы взял одинаковый набор заданий: письмо на русском с фактурой, таблицу с пропусками, длинный документ с вопросом о конкретном фрагменте и небольшое изменение в коде. Сравниваем не впечатление от красивого ответа. Смотрим, нашёл ли агент нужный фрагмент, не придумал ли факт, привёл ли исходные строки и сколько стоил весь цикл вместе с повторными вызовами. Если работа не связана с кодом, последний пункт можно заменить на подготовку черновика письма клиенту.
| Семейство | Что проверить первым | Где смотреть версии и условия | Главный риск при сравнении |
|---|---|---|---|
| Qwen | Тексты и выбор подходящей модели под задачу | Каталог Alibaba Model Studio | Перепутать конкретную модель с именем всей линейки |
| DeepSeek | Текстовые задачи через API | Официальный прайс DeepSeek | Сравнить цену в разные часы или режимы и получить ложную экономию |
| Kimi | Длинный документ и работу с контекстом | Справка Kimi API и личный кабинет для актуальной цены | Принять цену API за тариф пользовательского чата |
| GLM | Текстовые задачи, вызовы инструментов в своём сценарии | Прайс и документация Z.AI | Считать GLM-Flash и флагман одной конфигурацией |
Это таблица выбора сценария, не таблица результатов лабораторного теста. Я не прогонял четыре сервиса на одном закрытом наборе заданий и не выдаю эту редакционную группировку за измерение. Цены и состав семейства меняются: перед закупкой откройте страницы DeepSeek и Z.AI. Справка Kimi объясняет порядок оплаты API отдельно от пользовательской подписки: тариф конкретной модели сверьте в личном кабинете до покупки.
Qwen: выбор модели важнее слова «бесплатно»
Qwen - хороший первый кандидат, если хочется выбрать модель под конкретный режим работы. В официальном каталоге Alibaba соседствуют текстовые и мультимодальные продукты, разные версии и способы их вызова. Поэтому фраза «проверил Qwen» почти ничего не говорит. Запиши точное имя модели и площадку, на которой ты её открыл. Чат и вызов через Model Studio могут иметь разные интерфейсы и условия.
Для редактора полезно начать с двух заданий: сокращение длинного русского текста без потери важных деталей и ответ на вопрос с обязательной ссылкой на исходный абзац. Если версия умеет разбирать изображение, добавь фото документа, но не сравнивай этот ответ с текстовой моделью, которая картинку вообще не получила. Каждое испытание сохраняй целиком: входной файл, запрос, ответ и список замеченных ошибок. Хороший гладкий пересказ ещё не означает, что не исчезла важная оговорка.
В блоге есть отдельный гайд по Qwen для первого знакомства. Здесь другой вопрос: как поставить Qwen рядом с конкурентами и не спутать качество конкретной версии с удобством оболочки. Это особенно легко сделать, когда один тест идёт в веб-чате, другой в приложении на телефоне, а третий через API с иными настройками. Если интерфейсы разные, так и запиши в протоколе.
DeepSeek: сверяй режим и счёт за всю задачу
Страница моделей и цен DeepSeek показывает несколько моделей и разделяет цену входных и выходных токенов. Там же есть разные условия для кэшированного ввода и часов пик. Если записать одно число из таблицы и назвать его «ценой DeepSeek», можно очень удивиться счёту. Сравни итог на своём типичном запросе: длинный вход с документом и короткий ответ ведут себя иначе, чем короткий вопрос с длинным выводом.
Практический тест: передай агенту текст отчёта и попроси найти три противоречия с указанием предложений, на которые он опирается. Потом проверь их вручную. Отметь, понадобилось ли переспрашивать и насколько изменился вывод после правки промпта. При интеграции логируй выбранную модель, режим и расход токенов. Результат «дёшево за миллион» мало значит, если отчёт приходится генерировать повторно из-за пропущенной детали.
У DeepSeek уже есть отдельная инструкция по доступу из России и разбор версии Flash. Не смешивай исторический обзор релиза с текущей стоимостью API: справка самого поставщика может обновиться позже опубликованной статьи. При покупке для команды сохраняй снимок условий и дату, чтобы потом объяснить, почему расчёт бюджета изменился.
Kimi: длинный контекст ещё не гарантирует точный ответ
Kimi удобно брать для теста на большом материале: это характерный сценарий, в котором важно не только вместить документ, но и получить точные ссылки на его части. Документация Kimi API разделяет семейства моделей и правила расчёта токенов. Подписка на потребительское приложение и оплата API в этой документации разведены. Перед началом испытания выясни, какой из продуктов у тебя открыт и какая конкретно модель отвечает.
Для проверки возьми длинный протокол совещания. Спроси, кто отвечает за задачу, где установлен срок и какие решения остались открытыми. Для каждого ответа потребуй фрагмент исходного текста. После этого измени одну деталь в середине протокола и повтори запрос. Если модель уверенно возвращает прежний ответ, большой контекст в рекламной карточке не помог твоей задаче. Такой тест можно повторить для всех четырёх семейств, чтобы сравнение не превратилось в рекламную подборку.
Есть разбор Kimi как сервиса. Он пригодится, если тебе нужен старт в интерфейсе. В сравнении важнее одинаковое испытание: приложи тот же документ, задай тот же вопрос и отметь ошибки одинаковым способом. Даже правильный ответ на одном удачном примере не даёт гарантии для клиентских документов; сначала попробуй данные без персональных сведений.
GLM: флагман и Flash - разные ставки
В официальном прайсе Z.AI отдельно перечислены GLM-5.3 и GLM-5.3-Flash, а для ввода и вывода показаны разные цены. Это достаточная причина не ставить в колонку «GLM» одну случайную цифру. Выбери конкретный вариант под задачу, сохрани его имя и проверь, нет ли отдельной цены на инструменты, которые вызываются в твоём рабочем маршруте.
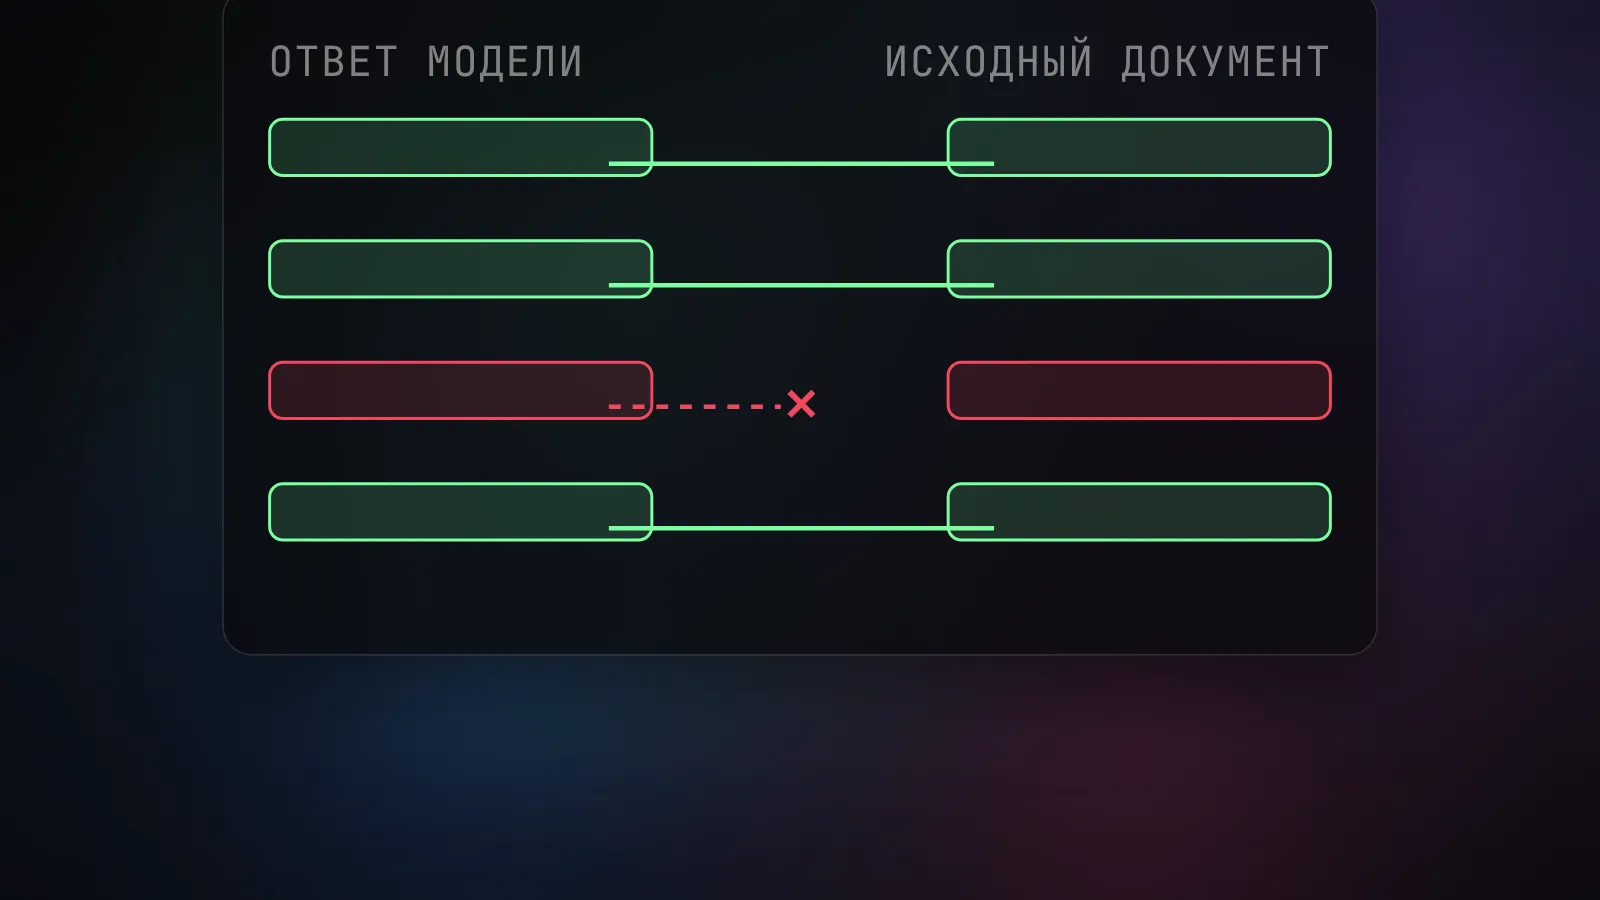
GLM стоит испытать там же, где DeepSeek: на сводке по документу и на маленькой агентной задаче с проверяемым результатом. Например, поручить составить список расхождений между двумя версиями политики компании, а затем пройтись по каждому пункту вручную. Если какой-то пункт отсутствует в источнике, это не «мелкая галлюцинация»: такой ответ нельзя отправлять коллегам без правки. Для кода имеет смысл отдельно запустить тесты проекта; демонстрационный фрагмент без тестов не доказывает надёжность.
В гайде по GLM и Z.AI разобран вход в сервис. Здесь меня интересует сравнительный выбор. Если берёшь более доступный вариант для фоновых задач и флагман для сложных, сначала проверь порог переключения на собственных документах. Не стоит придумывать универсальную формулу: качество, объём вывода и доступные инструменты зависят от конкретной версии и условий поставщика.
Как собрать честный личный рейтинг
Мой маршрут такой: выбрать одну рабочую задачу, обезличить входные данные, записать эталонные требования и только потом гонять четыре семейства. Пример эталона для отчёта: все суммы сходятся с исходным файлом, ссылки на строки ведут туда, куда обещают, отсутствующие данные явно названы отсутствующими. Одинаковый запрос отправляй через сопоставимые интерфейсы. Если доступен только чат у одного провайдера и API у другого, сравнивай отдельно удобство сервиса и отдельно качество ответа модели.
После первого прохода посчитай число существенных ошибок и сколько времени ушло на их обнаружение. Для денежных расчётов проверь полный расход по журналу вызовов, учитывая повторения и условия DeepSeek. Для остальных площадок тоже сверь цену перед оплатой: условия меняются вместе с линейкой моделей. Если не можешь воспроизвести результат из сохранённого запроса и версии модели, не делай сильный вывод из одного удачного ответа. У тебя пока впечатление, а не сравнительный тест.
Победитель получается локальным. Для одного человека решит интерфейс и ответ на русском, для команды - воспроизводимый API и условия оплаты, для разработчика - поведение на тестах собственного проекта. Я бы сохранил результаты в простой таблице с датой и конкретной моделью, а через месяц повторил два самых важных задания. Публичный рейтинг без дат и названий моделей стареет быстрее, чем успевает пригодиться. Если нужен обзор не только китайских продуктов, есть общий рейтинг нейросетей по задачам.