11 сентября 2026 г.
DeepSeek и Kimi тайно отдавали ответы Claude под видом своих моделей

Anthropic 10 сентября выпустила отчёт о злоупотреблениях и обвинила китайские лаборатории Alibaba, Moonshot (это те, кто делают Kimi) и DeepSeek в том, что они через сети фейковых аккаунтов гоняли запросы в Claude, а ответы выдавали за свои модели и собирали для обучения. Если ты пользуешься дешёвой моделью или агрегатором нейросетей - это касается тебя напрямую.
История важна не сама по себе, а тем, что она вскрывает: нельзя на глаз проверить, какая модель реально отвечает тебе внутри чужого приложения или API. Ниже разбираю, что именно нашла Anthropic, как работает дистилляция и что из этого стоит держать в голове, когда выбираешь, чему скармливать свои данные.
Что именно нашла Anthropic
Раз в несколько месяцев Anthropic публикует отчёт о том, как её модель пытались использовать во вред. Свежий разбор охватывает период с декабря 2025 по август 2026 и семь направлений - от кибератак до разработки оружия. Нас интересует последнее направление в списке: дистилляция. Всего по этой части компания насчитала около 200 миллионов обменов через несколько кампаний.
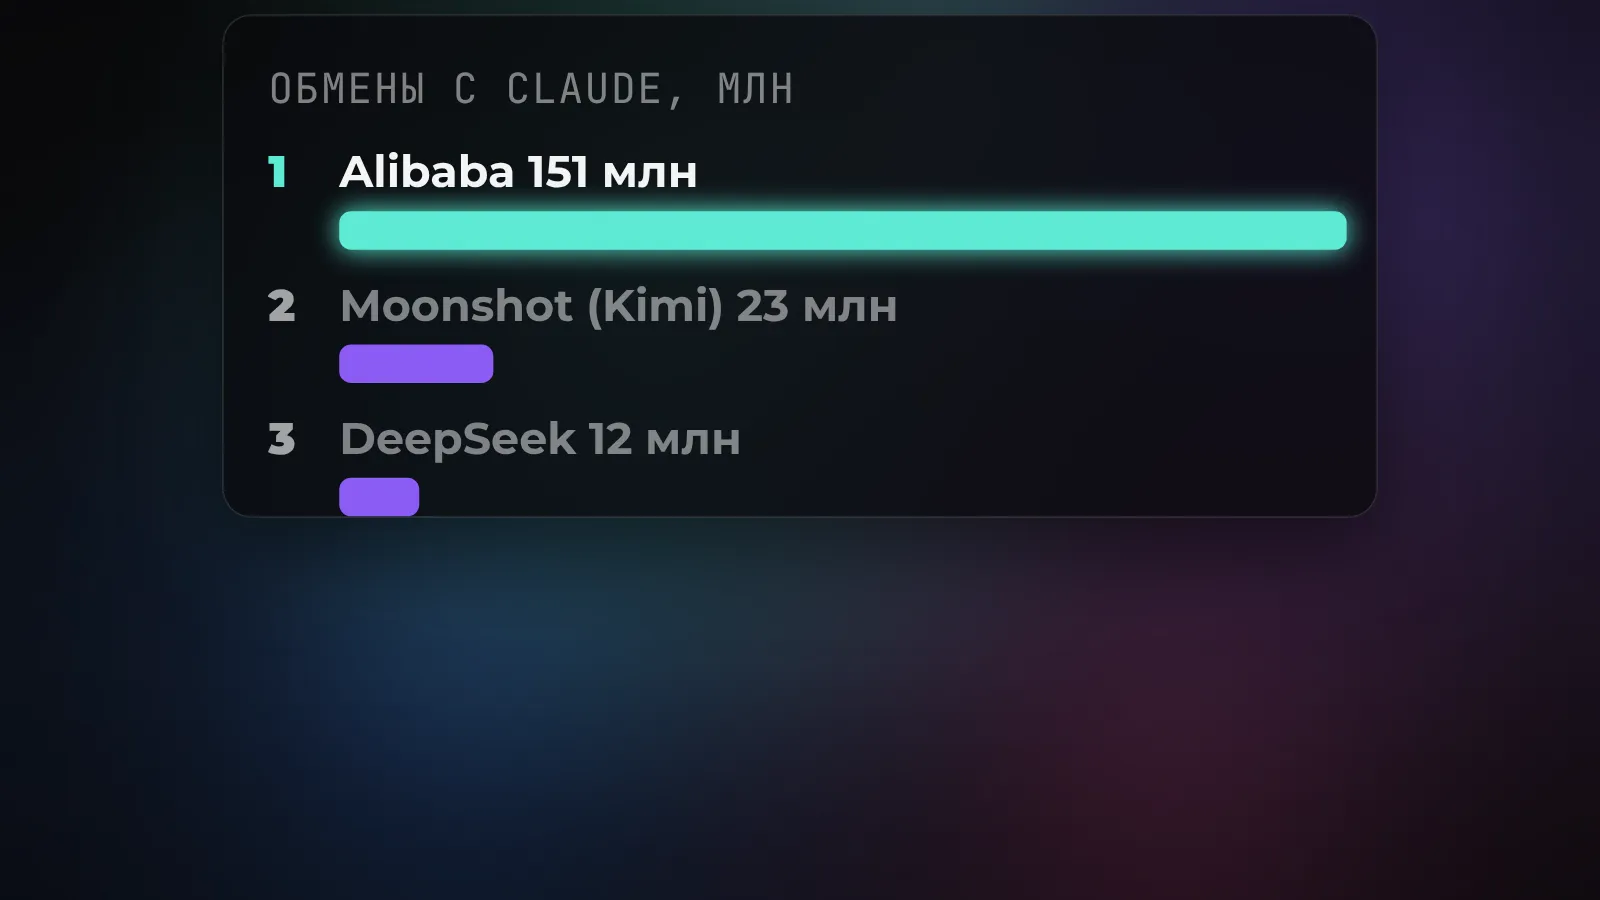
Расклад по трём лабораториям такой. Alibaba - самая крупная история: около 151 миллиона обменов с мая по июль, на пике до 3 миллионов в день, через 3500 поддельных аккаунтов с общим фиксированным промптом. Anthropic называет это «крупнейшей дистилляционной атакой, которую мы когда-либо измеряли». Moonshot за тот же период набрала больше 23 миллионов обменов, в одном десятидневном отрезке - почти 300 тысяч запросов, в основном к модели Claude Opus. DeepSeek за 14 дней июля - больше 12 миллионов обменов.
Anthropic не пускает свою технологию внутрь Китая, поэтому лаборатории заходили в обход. Moonshot, по данным отчёта, использовала около 5380 фейковых аккаунтов, зарегистрированных так, будто они из Сингапура и Японии. Именно поэтому обвинение весомое: это не пара тестовых запросов, а промышленный масштаб с обходом географических ограничений.
Что такое дистилляция и зачем она нужна
Дистилляция - это когда более слабую модель обучают на ответах более сильной. Ты берёшь мощную модель, задаёшь ей миллионы вопросов, забираешь не только ответы, но и цепочки рассуждений, а потом дообучаешь свою модель повторять этот стиль мышления. По сути младшая модель списывает у старшей - и получает часть её навыков, не потратив миллиарды на обучение с нуля.
Приём сам по себе законный и общеупотребимый, если дистиллируешь свою же модель. Проблема в слове «нелицензионная»: условия Anthropic прямо запрещают использовать выходы Claude для обучения конкурирующих моделей. Здесь же, по версии Anthropic, чужую модель доили через подставные аккаунты, а добытые рассуждения шли в обучение Qwen, Kimi и DeepSeek.
Как это технически работало
Самое интересное - механика обхода. У Claude есть защита: подпись на блоках рассуждения, чтобы их нельзя было выдернуть и переиспользовать в отрыве от сессии. Moonshot, по описанию Anthropic, сохраняла эти подписи, открывала новые сессии и просила модель восстановить ход рассуждения заново - компания называет это «атакой повторного воспроизведения между сессиями». DeepSeek действовала иначе: сканировала входящие запросы на признаки сторонних инструментов вроде Claude Code и Claude Agent SDK и точечно перенаправляла помеченные сессии в Claude Opus.
Отдельный трюк - маскировка запроса под безобидную задачу вроде «переведи это на японскую катакану», чтобы модель по дороге выложила свои внутренние рассуждения. Ловили всё это не по содержанию запросов, а по аномалиям в трафике API и поведении аккаунтов: слишком ровный поток, одинаковые промпты, подозрительная геолокация.
Два обвинения в одном
Тут важно не смешать две разные претензии, потому что вторая бьёт ближе к обычному пользователю.
Первая - про обучение: чужие рассуждения утащили, чтобы дообучить свои модели. Это спор между лабораториями, тебя как пользователя он задевает косвенно.
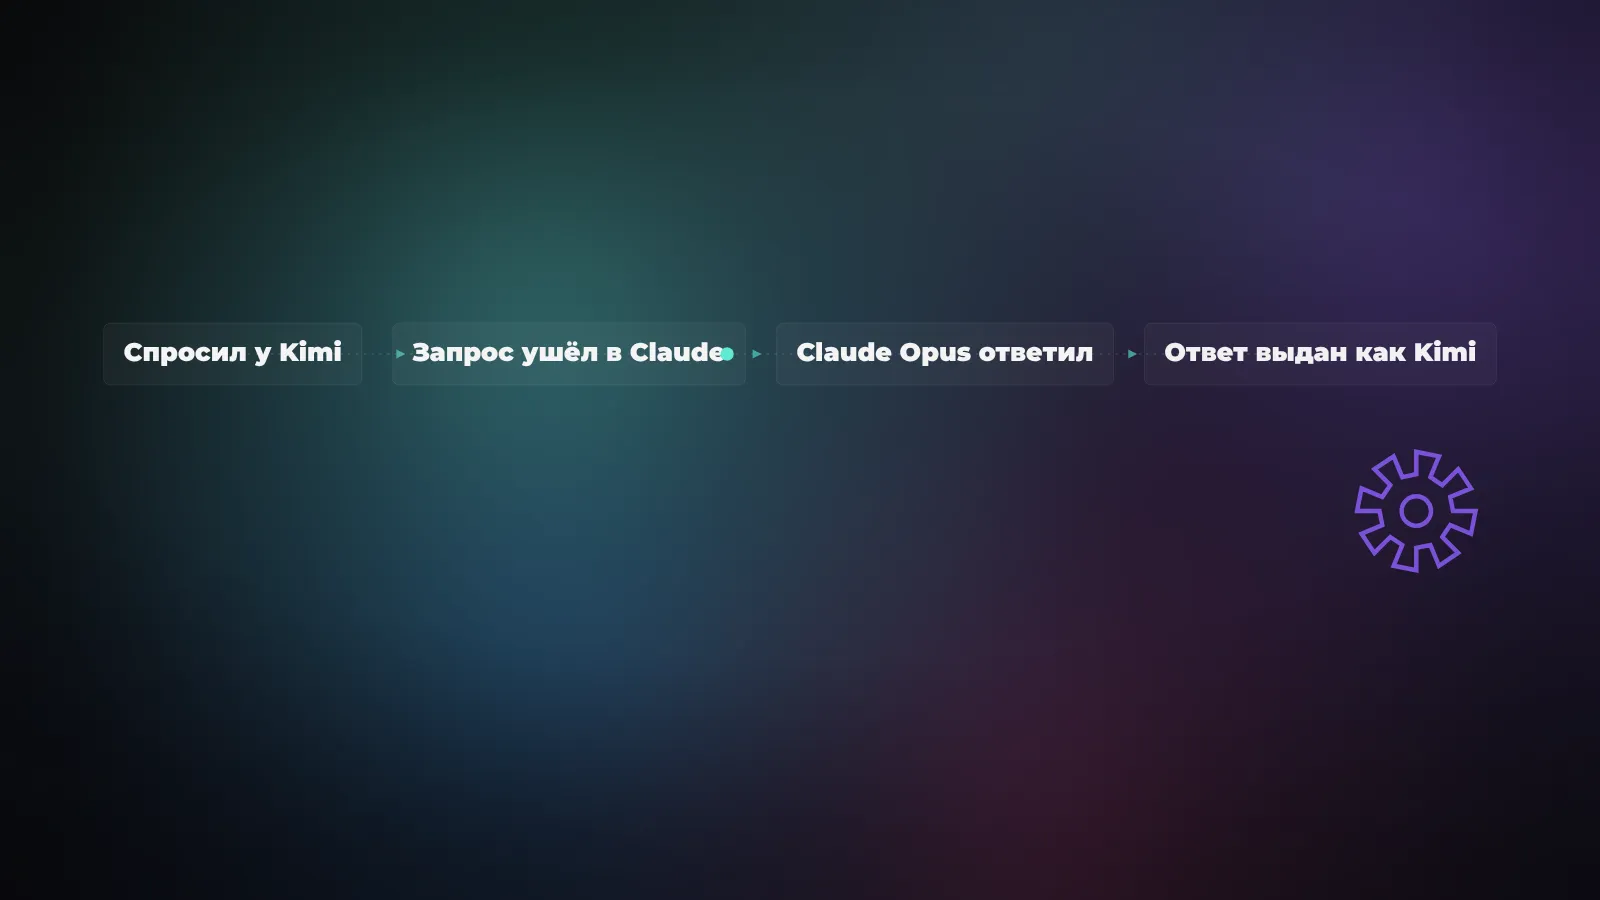
Вторая - про подмену вживую. По утверждению Anthropic, часть запросов реальных пользователей Kimi и DeepSeek в момент общения уходила в Claude, а ответ возвращался под видом ответа их собственной модели. Человек думал, что говорит с Kimi, а отвечал ему Claude - и человек об этом не знал. Это уже не внутренние разборки, а вопрос о том, кому на самом деле уходят твои сообщения.
Что это значит для тебя
Даже если отбросить часть деталей как непроверенные, остаётся неудобный вывод: ты не можешь на глаз убедиться, какая модель отвечает тебе внутри чужого сервиса. Приложение показывает своё имя и логотип, а под капотом может крутиться что угодно - от честной собственной модели до тихого прокси в чужой API.
Отсюда три практических последствия. Первое - приватность: твои промпты могут уходить не туда, где ты думаешь, и даже не в ту юрисдикцию. Anthropic прямо отмечает, что такое перенаправление раскрывало данные китайских пользователей американской компании. Второе - надёжность: сервис, который втихаря опирается на чужую модель, ляжет в ту же секунду, когда поставщик перекроет ему доступ. Третье - доверие к «уму» дешёвых моделей: часть их способностей может оказаться перенятой у старшей модели, а не собственной, и на новых, непохожих задачах это вылезает.
Кстати, обратная ловушка тоже есть. Модель, отвечающая «я - Claude» или «я сделана OpenAI», далеко не всегда прокси. Часто это просто след обучения на чужих ответах: модель нахваталась фраз о себе из обучающих данных. Так что тест «спроси, кто ты» ничего толком не доказывает.
Как снизить риск
Ничего героического тут не нужно, достаточно нескольких привычек.
Там, где происхождение модели реально важно - код с секретами, персональные данные, коммерческая тайна, - работай через официальный первоисточник: сайт и API самого разработчика модели, а не через посредника с непонятной цепочкой. Если пользуешься агрегатором, выбирай такой, который честно показывает, какой провайдер и какая модель обслуживают запрос (OpenRouter как раз из таких - там видно, куда уходит вызов).
Не суй чувствительные данные - пароли, ключи, чужие персональные данные - в модель, чьё происхождение ты не проверил. И помни, что твои чаты в бесплатных сервисах в принципе могут идти в обучение: это отдельная тема, я разбирал её в статье про то, обучается ли ИИ на твоих чатах.
Ни Qwen, ни Kimi, ни DeepSeek от этого не становятся «плохими» - это сильные модели, и я про них писал отдельно. Вывод не «не пользуйся китайскими нейросетями», а «понимай, через кого и куда идут твои данные, и не верь имени на кнопке как гарантии».
Источники
- Anthropic. Detecting and countering misuse of AI: September 2026
- CNBC. Chinese AI labs secretly used millions of Claude exchanges to train their models, Anthropic says
- TechCrunch. Anthropic details distillation campaigns from Alibaba, Moonshot AI, and DeepSeek
- South China Morning Post. Moonshot, DeepSeek secretly routed user requests to Claude, Anthropic claims
- Bloomberg. Moonshot Secretly Routed User Requests Through Claude, Anthropic Says