9 сентября 2026 г.
Обучается ли ИИ на твоих чатах и кому принадлежат твои черновики

Да, обучается, но не всегда и не на всех тарифах. Бесплатный и платный ChatGPT по умолчанию учится на твоих переписках, пока ты сам не выключишь это в настройках. Доступ через API, Business и Enterprise в обучение не идёт. У Claude с 2025 года правила такие же. А поводом снова заговорить об этом стала история с задачей Навье-Стокса.
Разбираю, почему математик заподозрил OpenAI в использовании своих черновиков, что компания реально признала и кто из провайдеров чему учится на твоих данных - с точными настройками, которые стоит поменять сегодня.
Что случилось
8 сентября OpenAI объявила, что её нераскрытая внутренняя модель получила доказательство по уравнениям Навье-Стокса. Над задачей параллельно работали около 10 тысяч агентов, счёт шёл 88 часов, а результат затем формально проверили в системе Lean с помощью GPT-6 Astra. Звучит как заявка на приз тысячелетия Института Клэя в миллион долларов.
Тут важная оговорка, которую сразу сделал Саймон Уиллисон и повторили в VentureBeat: доказали не ту самую задачу тысячелетия. Модель показала существование сингулярности во времени для уравнений Навье-Стокса с внешней силой, а миллион дают за версию без внешних сил. Это близкий и сложный результат, но не приз.
А через несколько часов после анонса появилась вторая история. Математик из Нью-Йоркского университета Тристан Бакмастер написал, что они с исследователем Anthropic Левентом Альпёге около года бились над связанной задачей и хранили все черновики внутри Codex, ИИ-инструмента самой OpenAI. За считанные дни до их публикации OpenAI выкатила близкое решение. Бакмастер прямо спросил: не залезли ли в его сессии Codex и не обучалась ли модель на его переписках.
Что именно признала OpenAI
Формально компания всё отрицает. Директор по исследованиям Марк Чен заявил: «Ни люди, ни ИИ-системы не рылись в пользовательских данных, чтобы решить эту задачу». То есть никто не открыл чат конкретного Бакмастера и не списал оттуда ответ.
Но следом в OpenAI добавили фразу, которая и есть вся суть темы: «Мы не можем исключить, что обезличенные данные из использования наших продуктов помогли улучшить наши модели». Переведу с корпоративного: твою конкретную переписку никто не читал руками, но она могла попасть в общий котёл обучающих данных обезличенной, и модель на ней чему-то научилась.
Вот здесь и прячется ловушка формулировок. «Мы не искали в твоих данных» и «твои данные никак не повлияли на модель» - это два очень разных обещания. Первое OpenAI даёт, второе - нет.
Почему «обезличенные» не значит «безопасные»? Обезличивание убирает из данных имя и явные метки, но не мешает модели запомнить сам текст. Исследователи не первый год показывают, что крупные модели способны дословно воспроизводить куски обучающих данных, если те попались достаточно часто или были достаточно уникальными. Год работы над редкой математической задачей - как раз про уникальность. Формулировка «обезличенные данные помогли улучшить модель» покрывает и такой сценарий, поэтому она никого ни в чём не убеждает, а наоборот, держит дверь приоткрытой.
Обучается ли ChatGPT на твоих переписках
Короткий ответ зависит от того, как именно ты пользуешься моделью.
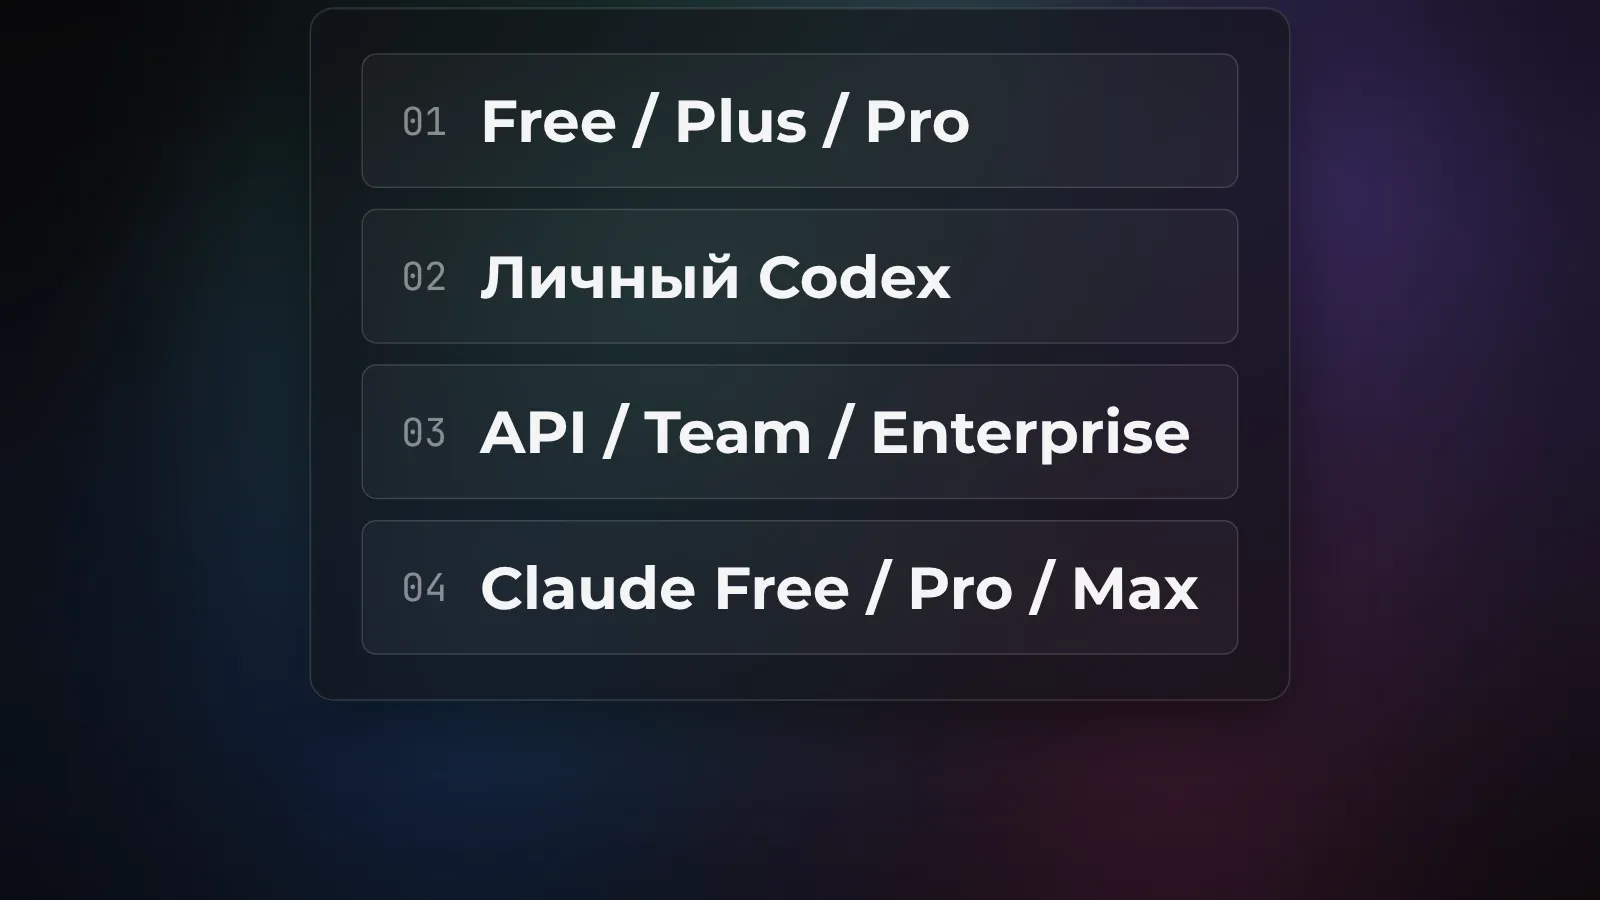
Бесплатный, Plus и Pro (обычный ChatGPT). По умолчанию OpenAI учится на твоих переписках. Отключается это в настройках: раздел Data Controls, тумблер «Improve the model for everyone», либо через портал приватности с запросом «не обучать на моём контенте». Есть ещё режим Temporary Chat - такие диалоги не попадают в историю, не создают память и не идут в обучение.
API, Team, Enterprise. Тут наоборот: по умолчанию на твоих запросах не обучаются, это прописано в договоре об обработке данных. Ничего настраивать не нужно, обучение и так выключено.
Codex. Это ровно тот случай из истории с Навье-Стокса. В потребительской версии Codex контент по умолчанию может идти в обучение, отключается вручную. В бизнес-аккаунтах данные Codex в обучение не попадают, если ты сам это явно не разрешишь. Математики хранили черновики в потребительском Codex, и это часть вопроса, который задал Бакмастер.
Claude сменил правила в 2025-м
Раньше Anthropic держалась строгой линии: на пользовательских чатах не учимся, данные удаляем примерно за 30 дней. 28 августа 2025 года политику поменяли.
Теперь чаты и сессии кодинга пользователей тарифов Free, Pro и Max идут в обучение Claude, если ты не отказался. Заодно выросло хранение: до пяти лет вместо прежних тридцати дней. Существующих пользователей попросили выбрать вариант до 28 сентября 2025 года, новым предлагают решить при регистрации, поменять решение можно в любой момент в настройках приватности.
Два важных нюанса. Первый: правило действует только на новые и возобновлённые чаты, старые молчащие переписки в обучение не тянут. Второй: коммерческих клиентов это не касается совсем - Claude for Work, Enterprise, Education и Gov на пользовательских данных не обучаются, как и было.
Где проходит настоящая граница
Если убрать все частности, картина простая и одинаковая у обоих провайдеров.
Потребительские тарифы - это витрина, которую компании используют в том числе как источник обучающих данных. Ты платишь деньгами или своими переписками, а часто и тем, и другим. Обучение включено по умолчанию, отказ - твоя работа.
Коммерческий доступ (API, Business, Enterprise) - это договор. Там обучение на твоих данных запрещено бумагой, а не галочкой в интерфейсе, и включить его можно только осознанно.
История с Навье-Стокса цепляет именно потому, что показывает третий, самый неуютный слой. Даже когда провайдер честно не роется в конкретном чате, обезличенные следы использования всё равно могут просачиваться в модель. Для обычного вопроса про рецепт это неважно. Для года работы над непубликованным результатом - критично.
Что сделать прямо сейчас
Не паникуй и не удаляй аккаунты. Достаточно навести порядок.
- Раздели задачи. Бытовые вопросы - в обычном чате, не жалко. Всё, что ты не готов увидеть в чужой модели (непубликованные идеи, клиентские данные, код под NDA), - только через API или бизнес-тариф с договором.
- Выключи обучение в обоих сервисах. В ChatGPT - Data Controls, «Improve the model for everyone» в положение «выкл». В Claude - настройки приватности, отказ от обучения. Это займёт минуту.
- Используй временный режим. Temporary Chat в ChatGPT для разовых чувствительных запросов, которые не должны оставить следа.
- Помни про лайки. Оценки под ответами способны протащить переписку в обучение мимо твоих настроек. Осторожнее с ними на важных диалогах.
- Не путай приватность и защиту от суда. Отключённое обучение не значит, что переписку нельзя запросить повесткой. Это отдельный риск, я разбирал его в статье про чаты как улики в суде.
Ответ на заголовок звучит так: ИИ обучается на твоих чатах ровно настолько, насколько ты ему это разрешил, а по умолчанию на потребительских тарифах - разрешил. История двух математиков ничего нового не открыла, она просто громко напомнила старое правило. Всё, что ты скармливаешь бесплатной модели, ты отдаёшь ей не только на один ответ. Про саму модель, которая считала Навье-Стокса, я писал в разборе GPT-6 Astra.
Источники
- Simon Willison. On Navier-Stokes (8 сент. 2026)
- VentureBeat. OpenAI solves longstanding math problem with 10,000-agent swarm
- OpenAI Help Center. How your data is used to improve model performance
- Anthropic. Updates to Consumer Terms and Privacy Policy (28 авг. 2025)
- Tom's Guide. Your Claude chats are being used to train AI - here's how to opt out
