16 октября 2026 г.
Cloudflare помогает ChatGPT находить сайты: как проверить свой

Cloudflare помогает поисковому роботу OpenAI находить страницы, которые он раньше пропускал: в пилоте на небольшой части сети обнаружены и проиндексированы сотни миллионов URL. Владельцу сайта пока не обещают отдельной кнопки «попасть в ChatGPT». Проверь, доступен ли текст роботу OAI-SearchBot, не блокирует ли его защита и видны ли важные страницы по прямым ссылкам.
Отчёт Cloudflare и OpenAI опубликован 15 октября. Меня зацепило не большое число страниц само по себе, а инженерная проблема: если хороший материал никто не нашёл, никакая «оптимизация под ИИ» не поможет. Но между «нашли URL» и «привели покупателя» ещё несколько фильтров. Разделю их, чтобы не купить красивое обещание вместо полезного действия.
Что показал пилот Cloudflare и OpenAI
Компании начали исследовательский проект в июле 2026 года, а сейчас рассказали о первых результатах. По их словам, участвовала выборка примерно из 1% сети Cloudflare. Сетевые сигналы помогли поисковому краулеру OpenAI обнаружить и добавить в поисковый индекс сотни миллионов прежде неизвестных страниц. Это оценка самих участников пилота, а не независимый замер прироста трафика для каждого сайта.
Что именно за сигналы? Публикация описывает классы: сведения о существовании страницы, изменениях, перенаправлениях, копиях и потенциально вредных URL. Внутренний формат передачи, критерии отбора конкретного сайта и долю страниц, которые потом процитировал ChatGPT, авторы не раскрывают. Не стану придумывать «алгоритм ранжирования» из этих общих слов.
Представь интернет-магазин с инструкцией к редкой детали. Ссылок на неё почти нет, хотя человеку нужен именно этот документ. Сигнал на уровне сети может помочь обнаружить URL, но потом OpenAI сама оценивает полезность и релевантность содержимого. Поэтому из фразы «сотни миллионов страниц в индексе» нельзя получить обещание, что твой магазин покажут в ответе на каждый вопрос о детали.
Где заканчивается обнаружение и начинается ответ
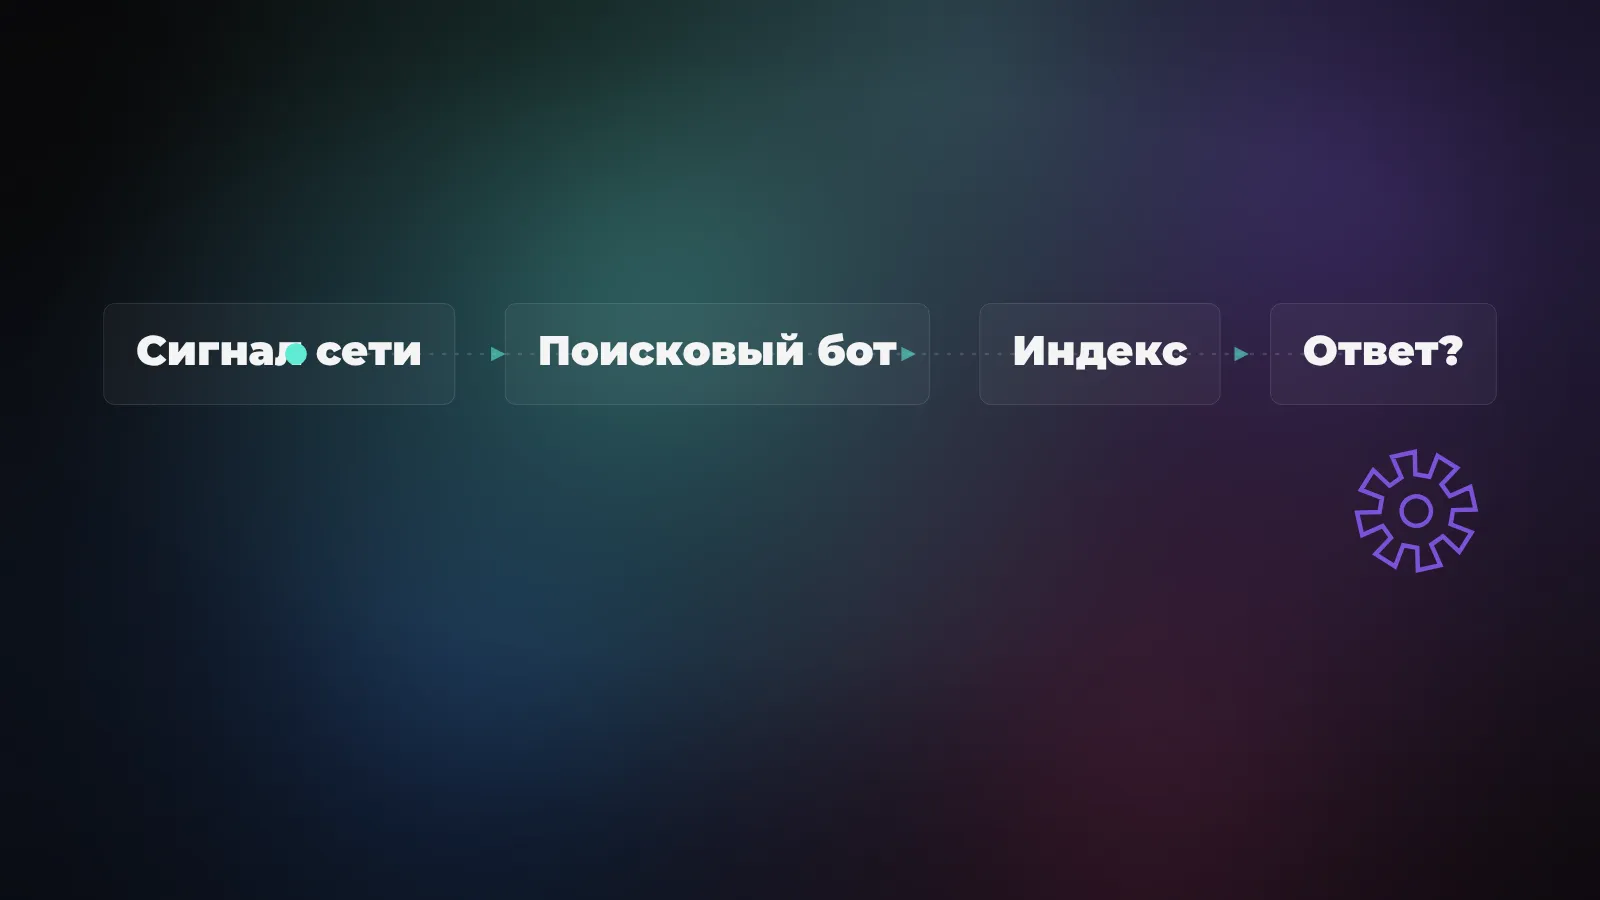
Здесь четыре разных события. Сначала система узнаёт адрес страницы. Затем робот приходит за содержимым, если владелец разрешил доступ. После этого страница может попасть в поисковый индекс. И только при подходящем запросе система может использовать её в ответе, показать ссылку или привести посетителя. Один этап не гарантирует следующий.
В отчёте прямо сказано: OpenAI независимо решает, как оценивать и ранжировать найденные страницы. Количество реальных переходов, покупок и заявок в пилоте пока не опубликовано. Авторы собираются измерять последствия обнаружения на следующем этапе. Я бы на месте владельца сайта пока не переводил обещание индексации в прогноз продаж.
Хорошая иллюстрация фильтра - страницы-призраки. Боты могут постоянно спрашивать несуществующий путь; если сайт отвечает на любой адрес главной страницей, такой путь кажется «живым». Туда же попадают копии и бесполезные редиректы. Cloudflare и OpenAI хотят отсеивать подобный мусор до повторных походов робота. Одна взломанная страница с поддельной формой входа, по замыслу участников, должна получать отдельный сигнал опасности, без автоматического наказания всего домена.
В моём разборе обвала цитат Reddit речь шла о другом: как ChatGPT выбирает источники после поиска. Здесь проблема стоит раньше - как вообще обнаружить страницу. Можно исправить первый шаг и всё ещё не попасть в ответ; можно быть в индексе и перестать цитироваться после смены механики поиска.
Каких роботов пускать, если хочешь быть в поиске
У OpenAI есть справочник собственных роботов. OAI-SearchBot работает для поиска ChatGPT. GPTBot связан с возможным использованием контента при обучении базовых моделей. Их правила независимы: разрешить поиск и запретить обучение - допустимая конфигурация по документации OpenAI. ChatGPT-User приходит при отдельных действиях человека в чате и не является автоматическим поисковым краулером; для него правила robots.txt могут работать иначе.
Если политика сайта - открывать публичные статьи для поиска, но не для обучения, пример для robots.txt выглядит так:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Проверь действующий файл, прежде чем менять его: эти строки сами по себе не отменяют блокировки WAF и не открывают закрытые личным кабинетом страницы. OpenAI рекомендует также пропускать запросы с её опубликованных IP-диапазонов для поискового бота. После изменения robots.txt системам OpenAI может потребоваться около суток, чтобы учесть новое правило. Делать вывод об индексации спустя пять минут рано.
Есть тонкость, которую пресс-релиз тоже подчёркивает: сигнал о странице сам по себе не даёт разрешения на её чтение. Пилот использует метаданные для поиска, а не передаёт содержимое страниц на обучение моделей. Снаружи это не способ обойти волю владельца, закрывшего контент. Но собственные правила доступа лучше проверить руками: некорректный WAF легко перечёркивает аккуратно составленный robots.txt.
Как проверить сайт без участия в пилоте
Начни с публичной страницы, а не с покупки инструмента «для GEO». Открой её без авторизации в приватном окне и убедись, что сервер возвращает содержание статьи. Если ты видишь только пустую оболочку приложения до запуска JavaScript, часть роботов может не получить тот же текст, что читатель. Google описывает, почему готовый HTML упрощает обход; это полезный инженерный ориентир, но не обещание конкретного поведения OpenAI.
Дальше открой /robots.txt на своём домене и проверь правила для OAI-SearchBot. Если пользуешься Cloudflare, загляни в AI Crawl Control: в списке роботов видны запросы и действие Allow/Block, в метриках можно смотреть статусы по путям и операторам. Для этого домен должен быть подключён к Cloudflare и трафик должен идти через её прокси. На бесплатном плане распознавание опирается на user-agent, а детализация метрик ограничена последними 24 часами. Это полезно для диагностики, но не доказывает, что бот настоящий: строку user-agent можно подделать.
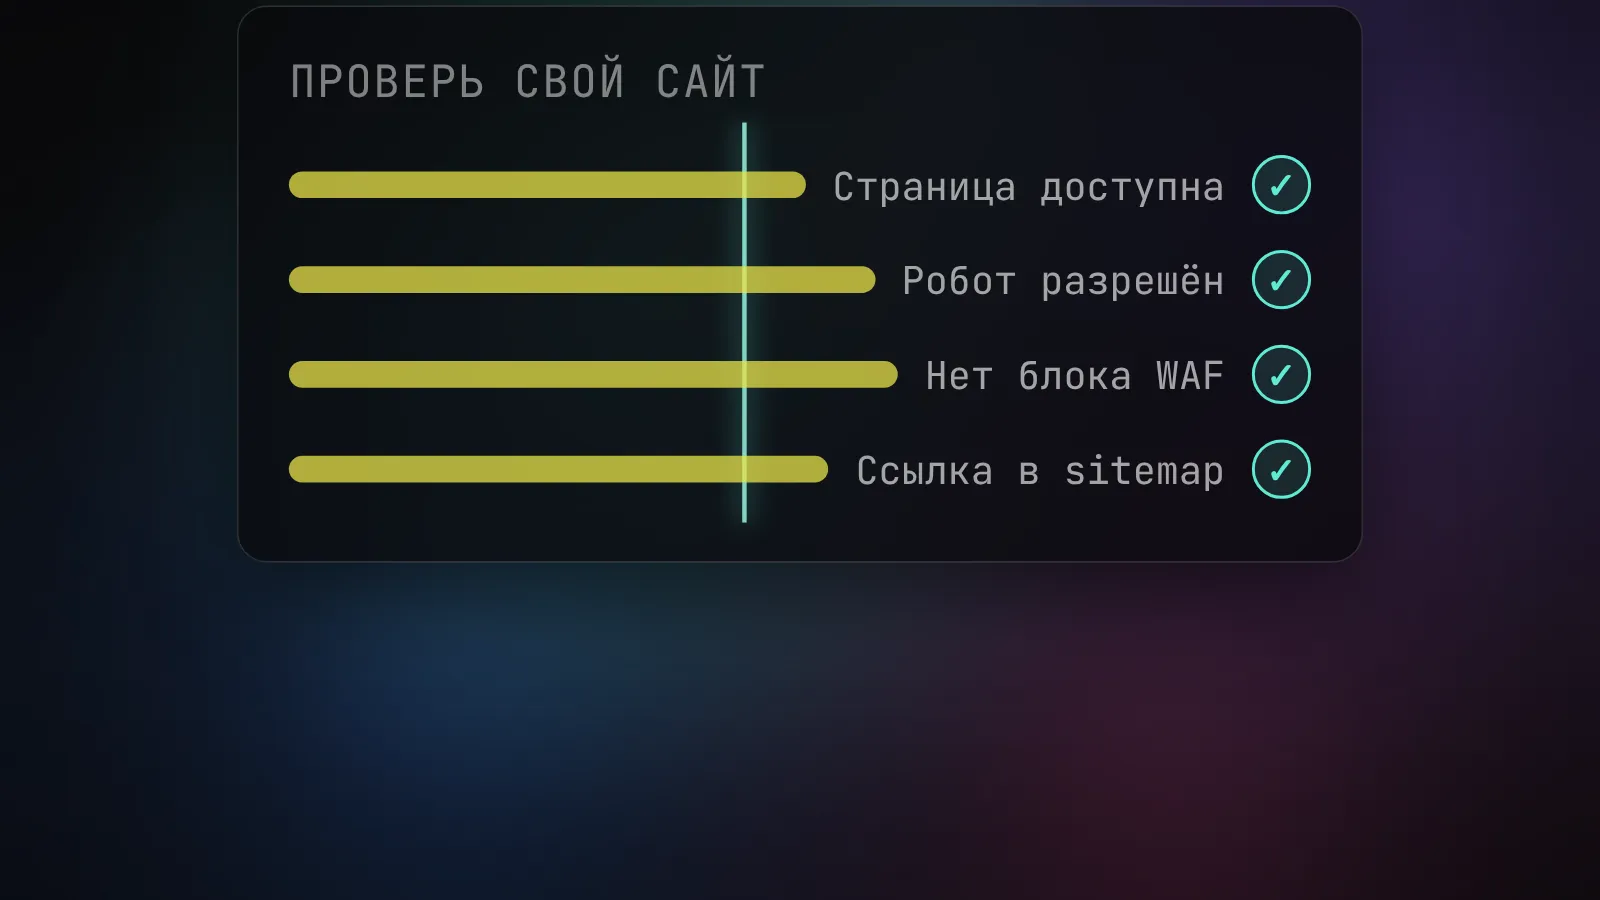
Затем проверь карту сайта. В руководстве Google по sitemap советуют включать канонические полные адреса нужных страниц и размещать ссылку на карту в robots.txt. Это проверенный способ помогать поисковым системам находить документы, хотя он не является заявленной технологией нового пилота Cloudflare и не гарантирует показ именно в ChatGPT. Внутренние ссылки из других статей тоже оставь: у читателя должен быть понятный путь к материалу без всякого краулера.
Что делать с битой страницей или дублями
Возьми несколько важнейших URL и пройди их как обычный посетитель. Статья должна открываться по своему адресу, а не вести на главную. Если документ удалён, серверу лучше честно вернуть ошибку, чем показывать под старым URL нерелевантный текст. Если один материал живёт по нескольким адресам, выбери основной и приведи карту сайта и внутренние ссылки к нему. Это решение удобно и человеку, и краулеру.
Cloudflare отдельно предупреждает, что новые находки могут сначала увеличить число запросов к сайту: роботу нужно проверить обнаруженную страницу. Обещание уменьшить лишнюю нагрузку относится к будущей эффективной фильтрации повторных обходов, а не к магическому исчезновению всего бот-трафика завтра. В аналитике сравнивай ответы 200, 3xx и 4xx по конкретным путям. Если основная масса обходов уходит на пустые адреса, у тебя есть измеримая проблема до всякого GEO.
Повторный обход после изменения - отдельная задача. Авторы пилота хотят точнее сигнализировать, когда содержимое обновилось. Это пока план исследований, а не публичная команда «переиндексировать в ChatGPT». Не рисуй новый протокол из пресс-релиза; публикуй устойчивые адреса и действительно обновляй сведения, которые меняются: цены, требования, версии. Дата правки текста имеет смысл, если ты перепроверил содержание, а не просто переписал число в метаданных.
Чего пилот пока не доказал
Нам не показали контрольную выборку сайтов с приростом цитат и заказов. Пилот идёт на части сети Cloudflare, поэтому нельзя заявить, что все сайты на этой платформе автоматически получили дополнительный трафик. Нельзя назвать и независимую «кнопку подключения»: публичная статья описывает исследование и последующую работу над сигналами, но не инструкцию для вступления владельца блога в выбранный 1%.
Для меня главный практический результат проще громкого заголовка. Проверь, может ли поисковый робот дойти до настоящего текста, отличает ли сервер страницу от 404 и не выдаёт ли защита запрет полезному краулеру. Потом меряй собственные переходы, а не чужой счётчик URL. Если публикуешь материалы по теме, где у тебя есть опыт, оставляй конкретный ответ и ссылку на первоисточник. Такую страницу полезно открыть человеку даже в тот день, когда ChatGPT её не процитирует.
Источники
- Cloudflare и OpenAI: результаты совместного пилота, 15 октября 2026 года.
- OpenAI: назначение OAI-SearchBot, GPTBot и ChatGPT-User.
- Cloudflare: AI Crawl Control, настройка и ограничения аналитики.
- Cloudflare: управление доступом отдельных краулеров.
- Google Search Central: sitemap и ограничения обнаружения URL.
- Google Search Central: что поисковые роботы видят в JavaScript-сайтах.