23 августа 2026 г.
Почему ChatGPT перестал цитировать Reddit - и что это значит для твоего контента

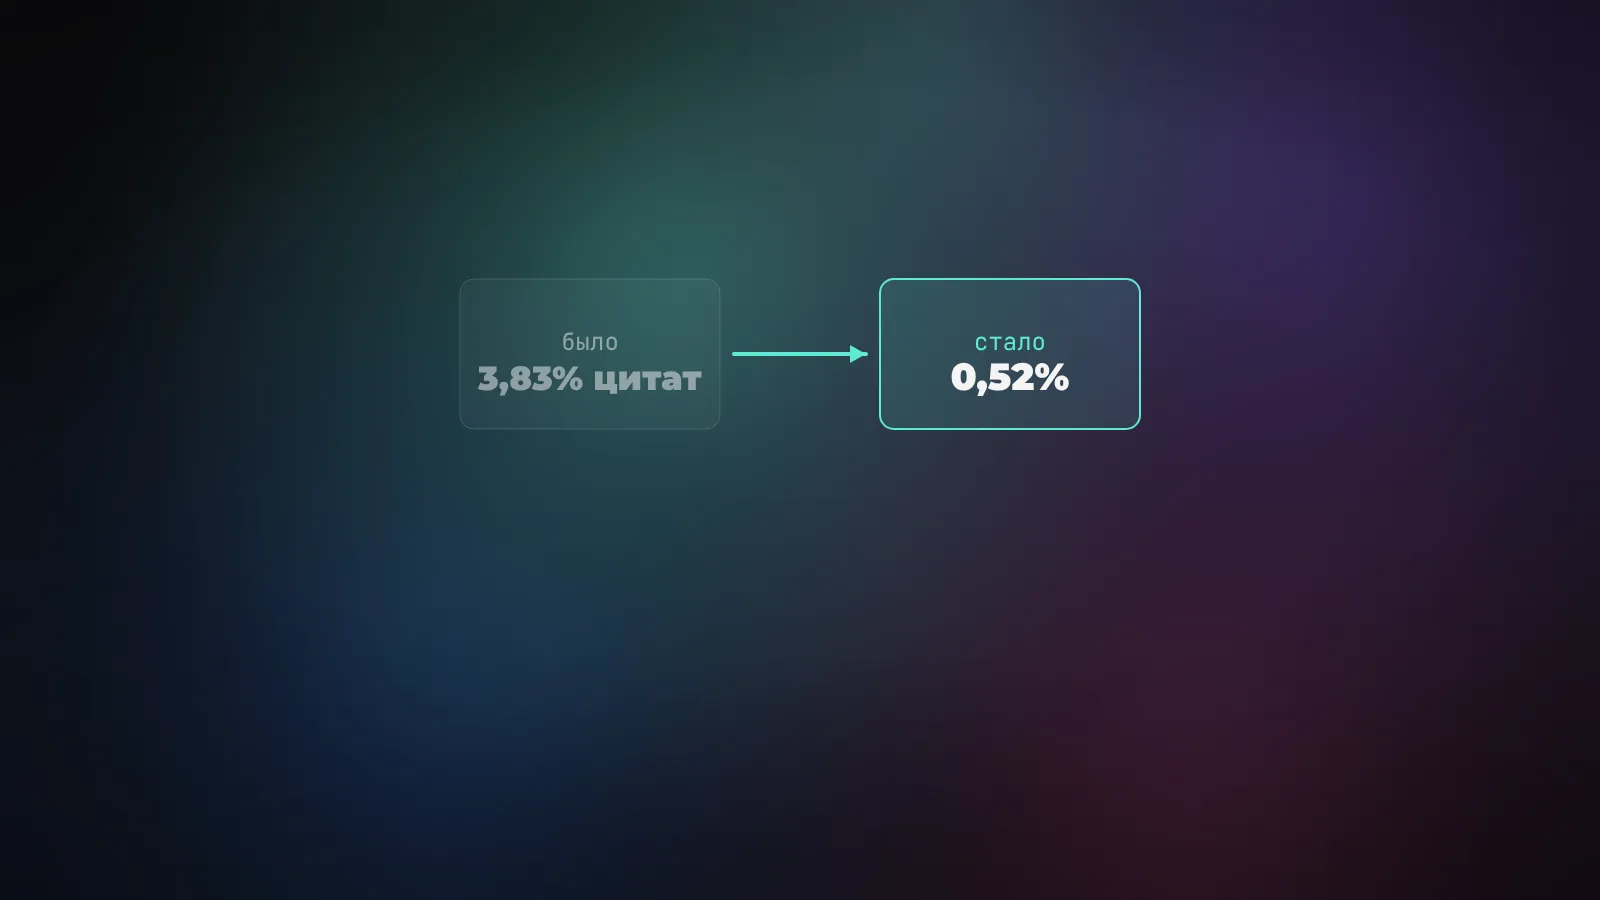
Доля Reddit в цитатах ChatGPT за четыре дня августа рухнула почти на 86% - с 3,83% до 0,52%. Reddit при этом ничем не провинился. ChatGPT поменял саму механику веб-поиска: вместо широких запросов по всему интернету он теперь точечно бьёт по конкретным доменам - официальным сайтам и документации, - и форумы просто перестали попадать в его выдачу.
История сама по себе про Reddit, но вывод из неё касается любого, кто выкладывает контент и хочет, чтобы ИИ его показывал. Видимость в ответах нейросетей может обвалиться за несколько дней без единого предупреждения, и повлиять на это ты почти не можешь. Разбираю, что произошло на самом деле, почему так вышло и что с этим делать.
Что именно произошло
Цифры собрала платформа Promptwatch, которая мониторит, на какие сайты ссылаются ИИ-поисковики. Картина такая: с 18 июля по 7 августа Reddit держался стабильно и давал в среднем 3,83% всех цитат в ChatGPT Search. Потом, между 8 и 14 августа, показатель поехал вниз, а к отрезку 14-17 августа осел на 0,52%. Это падение на 86,4% относительно прежнего уровня.
Важная оговорка, которую делают сами авторы: данные показывают, когда произошёл сдвиг, но не доказывают почему. Они честно пишут, что не могут полностью исключить и погрешность собственного сбора, и держат выводы как предварительные. Так что относимся к конкретным долям как к ориентиру, а не к высеченной в камне истине. Но масштаб обвала слишком велик, чтобы списать его на шум.
Почему Reddit выпал - механизм
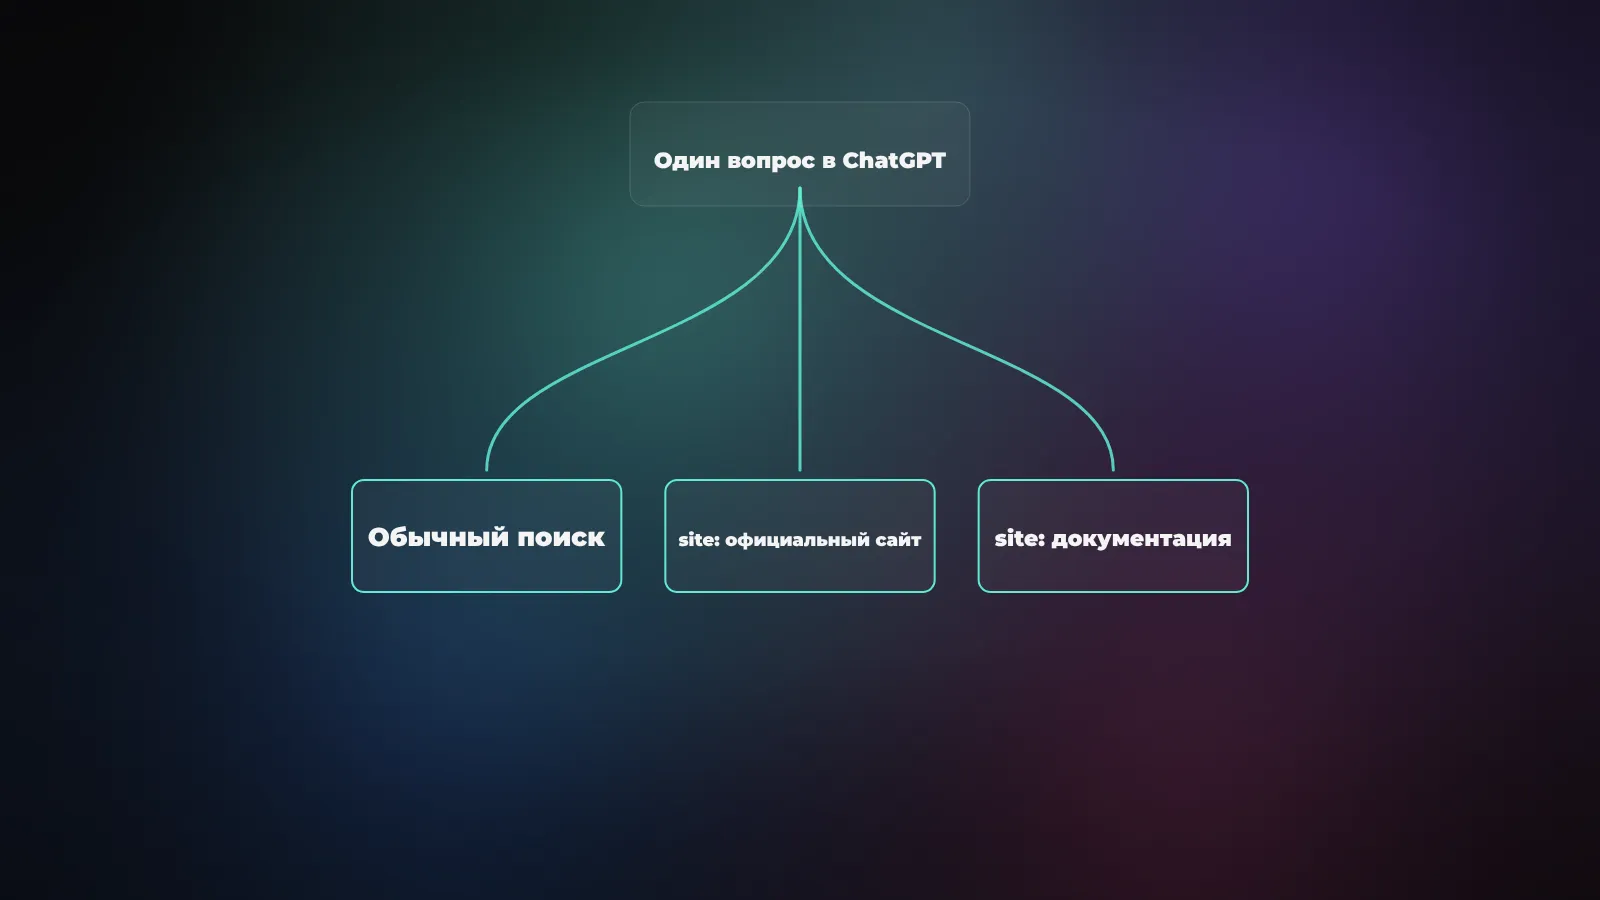
Самое интересное - не сам факт падения, а его причина. Promptwatch связывает обвал с тем, что 8 августа ChatGPT поменял «query fan-out» - то, как он разбивает один твой вопрос на несколько поисковых запросов под капотом.
Раньше модель делала в основном широкие запросы по вебу, и в такой выдаче форумы вроде Reddit всплывали часто. С 8 августа ChatGPT начал массово использовать оператор site: - тот самый, которым в обычном поиске сужают выдачу до одного домена. Доля запросов с site: подскочила с 0,37% до 16,8% за один день. Это примерно сорокакратный рост.
При этом старые запросы никуда не делись. Модель не заменила общий поиск точечным, а добавила точечный сверху: среднее число поисков на один ответ почти удвоилось, с 1,08 до 1,83. То есть теперь ChatGPT сначала прикидывает, на каких авторитетных доменах искать ответ, и идёт спрашивать прямо туда - на официальные сайты и в документацию. А форумы в такую адресную выдачу просто не попадают.
Ключевой вывод инженеров: это изменение в том, как ChatGPT решает, у каких сайтов спрашивать, а не персональный штраф для Reddit. Просто новая логика поиска устроена так, что community-форумы оказались за бортом. У Reddit с ИИ-компаниями и без того непростая история вокруг доступа к данным, но конкретно этот обвал - про механику фан-аута, а не про войну с одной площадкой.
Почему это касается не только Reddit
Теперь главное, ради чего вообще стоит про это читать, если ты не сидишь на Reddit. Целый пласт видимости одной из самых цитируемых площадок интернета обнулился за четыре дня. Без анонса, без объявления, без возможности как-то к этому подготовиться.
И это не первый такой скачок. По данным SEMrush, ещё в сентябре 2025 года на большой выборке в сотни тысяч промптов доля Reddit в ответах ChatGPT за пару недель сложилась примерно с 60% до 10% - а потом отросла обратно. Видимость в ИИ штормит в обе стороны, и амплитуда огромная.
Для сравнения: у Google AI Overviews за то же время доля Reddit снижалась плавно, с примерно 2,5% в начале июля до 2,1% в августе. Никакого обвала за сутки, как в ChatGPT, там не было. Разные движки по-разному решают, кого показывать, и меняют эти правила каждый на своём графике.
Кого ИИ цитирует вместо форумов
Если форумы задвинули, то кто выходит вперёд? По логике нового фан-аута - официальные сайты, документация, справочные ресурсы вроде «Википедии». То, что модель воспринимает как авторитетный первоисточник по конкретному домену.
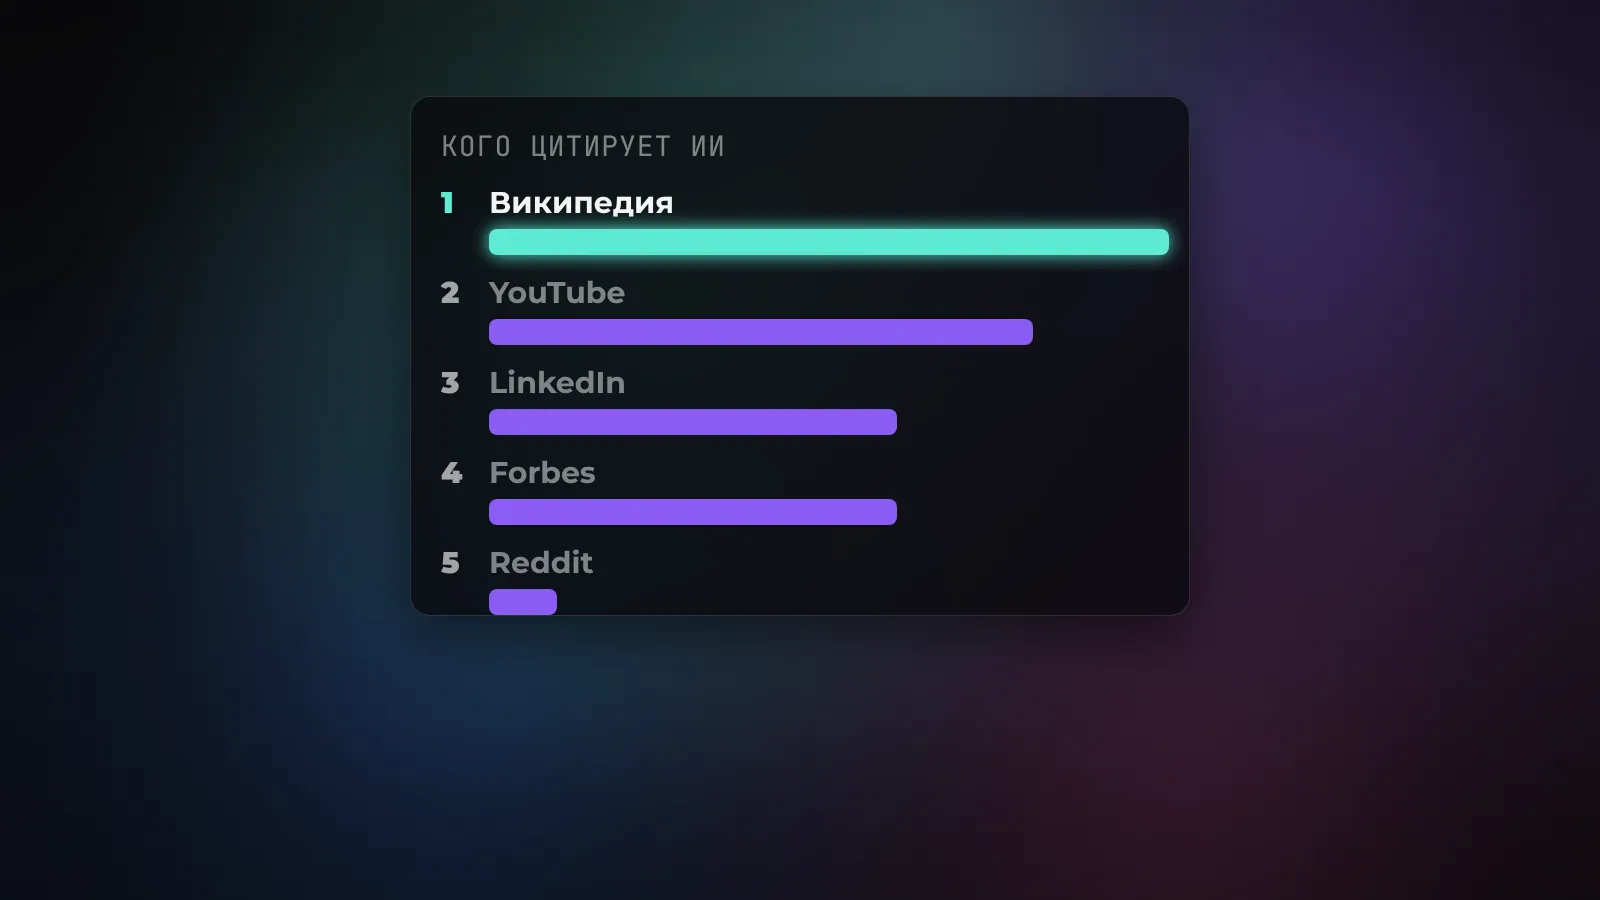
Если смотреть шире, картина по всем движкам такая. Сводный индекс, собранный из нескольких исследований на 680+ млн цитат за период с августа 2024 по апрель 2026, показывает: Reddit, «Википедия», YouTube, LinkedIn и Forbes вместе с десятком других источников дают примерно две трети всех цитат, которые выдают ChatGPT, Claude, Gemini, Perplexity и Google AI Overviews.
Но есть отрезвляющая деталь. Даже у самого цитируемого домена на любой из платформ доля редко превышает 5%. Остальные 95% размазаны по тысячам сайтов. Цитаты ИИ - это длинный хвост с несколькими выбросами, а не рынок, где победитель забирает всё. И это, на самом деле, хорошая новость для небольших авторов: место в выдаче не занято намертво парой гигантов.
Что такое GEO и почему это игра вдолгую
Из всей этой истории выросла целая дисциплина - GEO, generative engine optimization. Если по-простому: это когда ты выстраиваешь контент так, чтобы ИИ-движки цитировали и рекомендовали именно его в своих ответах. Аналог SEO, только оптимизируешь не под синие ссылки в Google, а под то, что нейросеть проговорит пользователю голосом.
Тут есть тонкость, которой нет в обычном SEO. У ИИ два разных источника ответа. Первый - живой веб-поиск в момент запроса, где как раз и случился весь этот фокус с site:. Второй - обучающий корпус модели: статья, которую ты выложил два года назад, может всплыть в ответе сегодня, потому что она вшита в саму модель. Поэтому GEO - это марафон, а не спринт.
Один из специалистов по медиаизмерениям сформулировал это так: не надо вешать все надежды на GEO как на волшебного единорога, которого не существует. Это долгая игра, и присутствовать нужно на многих разных каналах сразу. Ровно то, что подтвердил обвал Reddit: ставка на одну площадку - плохая ставка.
Что делать, если хочешь попадать в ответы ИИ
Собираю из этого практику для тех, кто делает контент - для себя, для бренда или для клиентов.
Первое - размазывай присутствие по разным поверхностям. Не молись на один источник, будь то Reddit, один блог или одна соцсеть. Авторитет, набранный на нескольких независимых площадках, - это то, что держит удар, когда у одной из них выдался плохой месяц. Упала одна - тебя всё ещё видно на остальных.
Второе - держи собственную площадку, которую у тебя не отнимут. Свой сайт, свой блог, свой канал. Чужие платформы дают охват, но правила на них меняют без тебя. Собственный домен - единственное место, где алгоритм не выключит тебя за сутки.
Третье - структурируй контент так, чтобы ИИ было легко выдрать из него готовый ответ. Свежесть, понятная структура с заголовками и прямыми ответами на вопрос, реальная экспертиза вместо воды. Движки любят вытаскивать из текста самодостаточный кусок, который можно вставить в ответ как есть.
Четвёртое - следи за тем, как эта картина меняется. Не разово, а регулярно. Обвал Reddit заметили только те, кто мониторил цитаты каждую неделю. Все остальные узнали об этом из новостей, когда уже поздно было что-то менять.
Что это значит лично для тебя
Если коротко - правила видимости в ИИ пишут не для тебя и меняют без тебя. Reddit, махина с миллиардами страниц, за четыре дня потерял почти всю долю в цитатах ChatGPT из-за одной технической правки, которую никто не анонсировал. Если это может случиться с ним, то с твоим блогом или брендом - тем более.
Отсюда простой вывод, который я держу в голове и для своих проектов. Нельзя строить всю видимость на одной площадке и на одном алгоритме, который тебе не подчиняется. Своя площадка плюс присутствие на нескольких чужих, нормальная структура контента и регулярный взгляд на то, кто тебя цитирует, - это скучно, зато не рассыпается от одного обновления, про которое ты узнаёшь последним.