22 августа 2026 г.
Цифровые двойники: ИИ симулирует живых людей на 85% точно - и это новый scaling law

Цифровой двойник человека - это ИИ-модель конкретной личности, которая отвечает на вопросы и принимает решения так же, как ответил бы сам человек. Стартап Simile довёл точность до 85%: его двойники повторяют ответы живых людей почти так же точно, как сами эти люди повторяют свои же ответы спустя две недели. Идея простая - симуляция человека становится следующим рубежом масштабирования ИИ после данных и вычислений.
Звучит как фантастика, но за этим стоят громкие имена и большие деньги. В июле 2026 Simile подняла $200 млн при оценке $2 млрд, а в основе лежит работа, которую в Стэнфорде начали ещё в 2023-м. Разбираю, как это устроено, где уже применяется и что это значит для тех, кто продаёт, пишет тексты и запускает продукты.
Что такое цифровой двойник человека
Обычную нейросеть ты просишь: «ответь как маркетолог» или «представь, что ты покупатель». Она отыгрывает роль по усреднённому шаблону из обучающих данных. Получается собирательный образ, средний по больнице, а не конкретный живой человек с его тараканами.
Цифровой двойник устроен иначе. Это модель, натренированная на данных одного реального человека: его интервью, поведении, прошлых решениях. Задаёшь ей вопрос - и она отвечает не «как усреднённый покупатель», а как вот этот конкретный Иван из Твери, 34 года, двое детей, недавно сменил работу. Со всеми его нелогичностями и противоречиями.
Разница принципиальная. Средний ответ модели гладкий и разумный. Живой человек часто ведёт себя не разумно, а по-своему - и именно это поведение важно предсказать, если ты хочешь угадать реакцию рынка.
Откуда это выросло: 25 агентов в городке Smallville
Всё началось с работы «Generative Agents: Interactive Simulacra of Human Behavior», которую в 2023 году представили исследователи из Стэнфорда во главе с Джун Сон Паком. Они запустили маленький виртуальный городок Smallville, населённый 25 агентами на базе ChatGPT. У каждого - имя, профессия, характер и абзац описания в качестве стартовой памяти.
Дальше начиналось интересное. Агенты просыпались, завтракали, шли на работу, встречали друг друга, обменивались новостями. Никто не программировал сценарий - поведение рождалось само. Самый известный момент: один агент решил устроить вечеринку ко Дню святого Валентина, разослал приглашения, и слух пополз по городку - другие агенты узнавали о вечеринке друг от друга, договаривались, кто с кем пойдёт, и в нужный час собирались в нужном месте.
Это доказало важную вещь: если дать языковой модели память, умение планировать и рефлексировать, из неё получается правдоподобный имитатор социального поведения. Дальше оставалось задать вопрос посерьёзнее - а можно ли так же точно смоделировать не выдуманных персонажей, а конкретных живых людей?
1052 человека и точность 85%
Ответ дала следующая работа той же команды - «Generative Agent Simulations of 1,000 People». Исследователи набрали 1052 реальных человека, подобранных так, чтобы выборка представляла население США по возрасту, полу, расе, региону, образованию и политическим взглядам. С каждым провели двухчасовое интервью о жизни: детство, работа, ценности, важные решения.
На основе этих интервью для каждого участника собрали цифрового двойника. А потом устроили проверку: и живым людям, и их двойникам дали одни и те же задания - большой социологический опрос General Social Survey, тесты личности, поведенческие экономические игры.
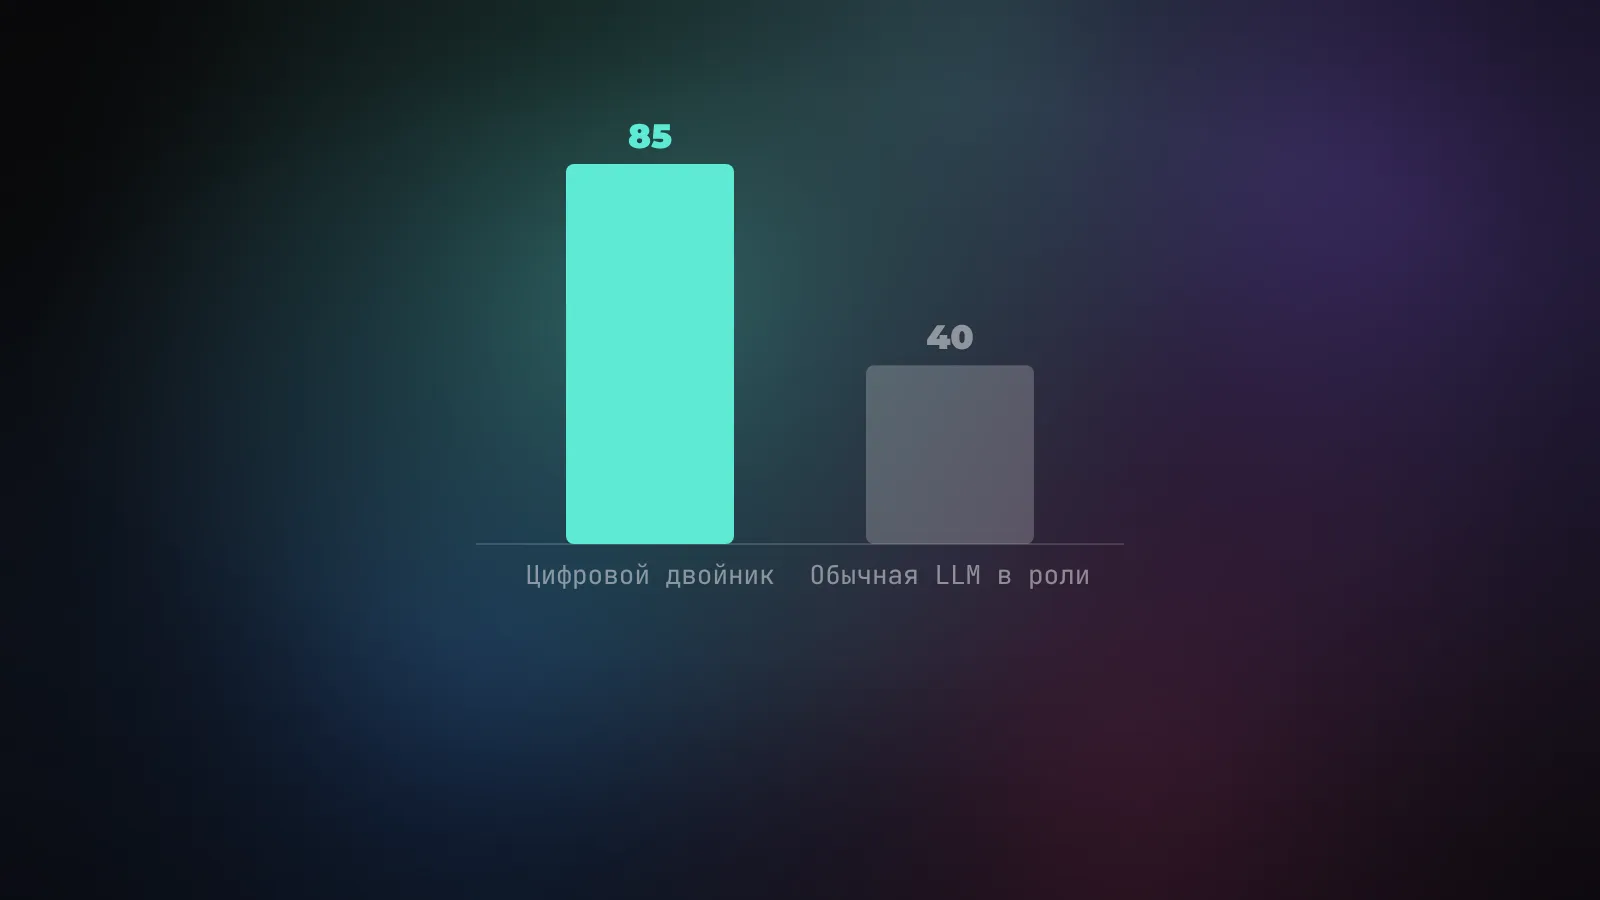
Результат и есть та самая цифра 85%. Двойники повторяли ответы своих прототипов на 85% так же точно, как сами люди повторяли собственные ответы через две недели. То есть двойник ошибается примерно настолько же, насколько ты сам противоречишь себе, если пройти один опрос дважды с интервалом в полмесяца. Для сравнения: если просто попросить ChatGPT или Claude отыграть роль по короткому описанию, попадание в реального человека, по словам создателей Simile, держится где-то в диапазоне 20-60%.
Как двойник учится: три типа данных
Именно на этой технологии выросла Simile - компания, которую основал тот самый Джун Сон Пак вместе с Майклом Бернстайном и Перси Лянгом (человеком, который в своё время ввёл термин «фундаментальные модели»). Чтобы двойник получился точным, компания опирается на три разных типа данных.
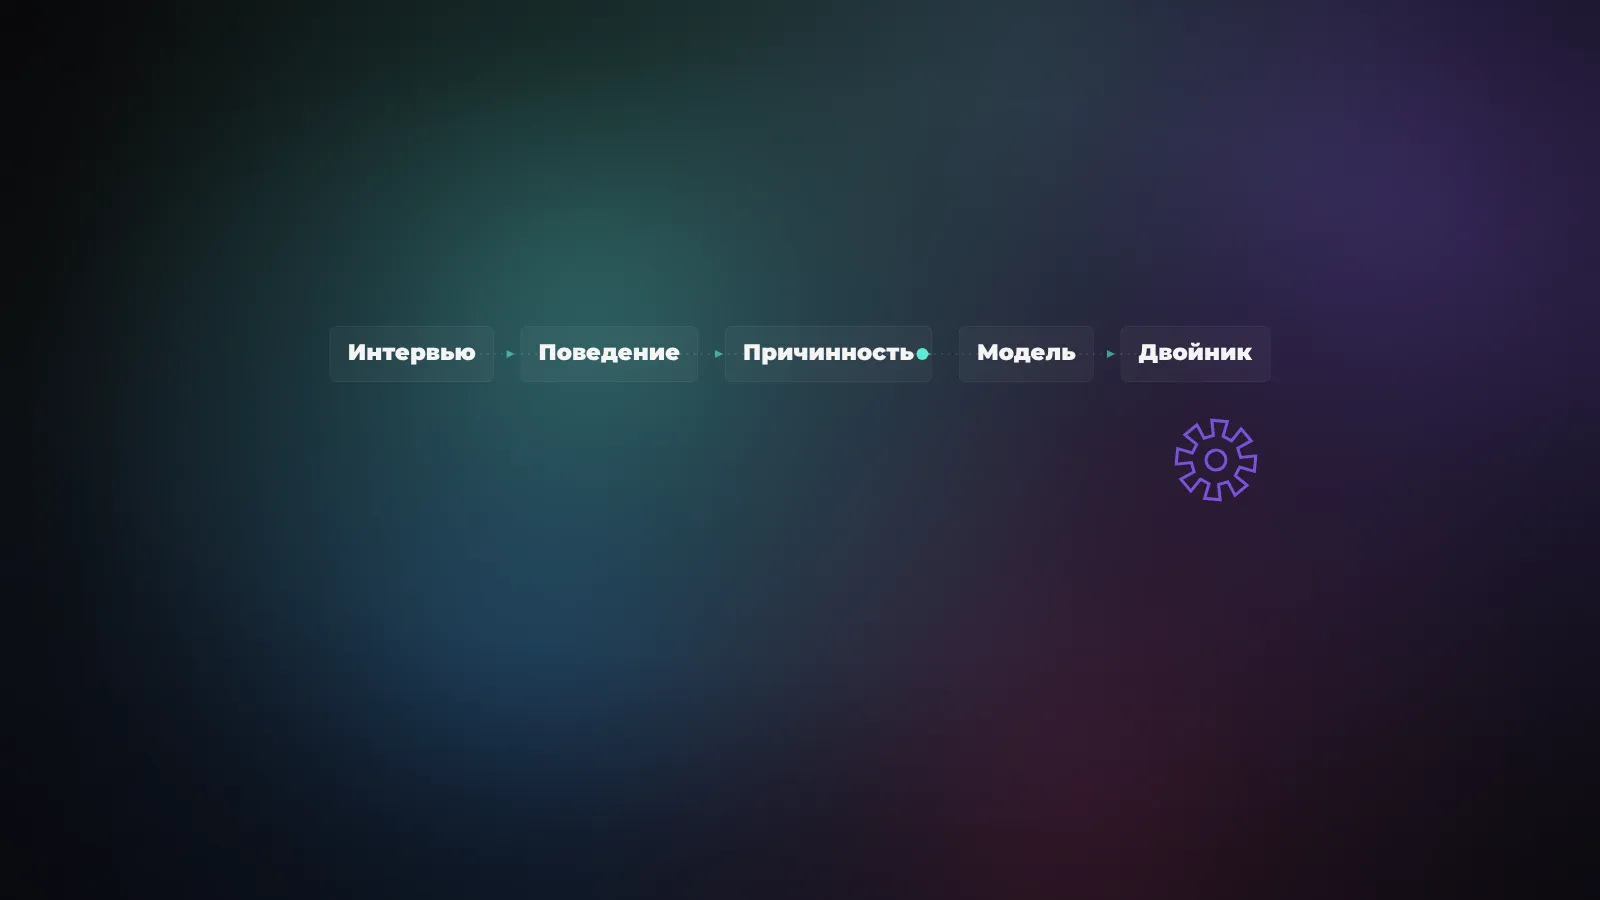
Интервью. Длинные разговоры о жизни человека - его история, мотивы, страхи, поворотные решения. Это даёт двойнику характер и логику, по которой человек вообще принимает решения.
Поведение. Записи реальных действий: что купил, на что кликнул, как прошёл по сайту, что бросил в корзине. Слова человека и его поступки часто расходятся, и поведенческие данные ловят это расхождение.
Причинные данные. Самое ценное и самое трудное. Это результаты контролируемых экспериментов, которые показывают не что человек сделал, а почему - что именно подтолкнуло его к решению. Такие данные объясняют не итог, а механизм: дёрни за этот рычаг - получишь вот такую реакцию.
«Симуляция - новый scaling law»: ставка Simile
Тезис Пака звучит крупно. Последние годы ИИ рос за счёт двух вещей: больше данных и больше вычислений. Он считает, что следующий рубеж - симуляция: воссоздание живых людей и целых обществ в цифре. По его словам, в любой развитой цивилизации из научной фантастики есть две опорные технологии - искусственный интеллект в какой-то форме и симуляция реальности.
Инвесторы в это поверили деньгами. Simile основали в конце 2025-го, публично запустили в феврале 2026-го, и всего за полгода компания прошла путь от раунда A на $100 млн до раунда B на $200 млн при оценке $2 млрд. Последний раунд возглавил фонд Greenoaks, среди участников - венчурное подразделение аптечной сети CVS Health.
Дальний прицел компании - смоделировать всех 8 миллиардов жителей Земли, чтобы прогонять на симуляции вопросы уровня целого общества: как поведут себя рынки, что предшествует политическим кризисам, сработает ли конкретная мера против изменения климата. Пока речь идёт о десятках и сотнях тысяч смоделированных людей, но направление задано.
Где это уже применяют
Самое приземлённое применение - заменить дорогие и медленные исследования аудитории. Среди клиентов Simile называют CVS Health, Wealthfront, Deloitte и Gallup - последняя, между прочим, сама живёт на опросах общественного мнения.
Вот на что уже годится синтетическая аудитория:
- Тест сообщений и офферов. Прогнать десять вариантов заголовка или лендинга через панель двойников и посмотреть, какой заходит какому сегменту, до того как тратить бюджет на реальный трафик.
- Фокус-группы без людей. Обычная фокус-группа - это недели поиска участников, аренда, модератор. Синтетическая панель отвечает за минуты и не устаёт от сотого вопроса.
- A/B-тесты интерфейсов. Двойники умеют ходить по сайту, читать картинки, кликать по макету в Figma - можно проверить путь пользователя ещё до релиза.
- Прогноз реакции. Как рынок ответит на новость компании, как аудитория примет повышение цены, куда качнётся сегмент после смены упаковки.
Главный плюс с точки зрения экономики - двойников собирают один раз, а спрашивать можно бесконечно. Живого человека на каждое новое исследование надо искать заново, а двойник уже стоит на полке и готов ответить на следующий вопрос.
Что это значит для тебя
Если ты продаёшь, пишешь тексты или запускаешь продукты, за этим стоит следить по одной причине. Самое дорогое в маркетинге - проверить гипотезу на живых людях: настроить рекламу, слить бюджет, собрать данные, сделать вывод. Синтетическая аудитория обещает сдвинуть часть этой проверки на этап до трат.
Полностью доверять прогнозу двойников пока рано, но как первый фильтр это уже работает. Отсеять заведомо слабые варианты офферов на симуляции, а на реальный трафик выпускать только те два-три, что прошли отбор - вполне рабочая схема даже на сегодняшнем уровне точности.
Где подвох
Сам Пак описывает свою задачу неожиданно честно: он делает не идеально разумную модель, а модель, которая «так же туповата, как я сам». Если человек ошибается, двойник обязан ошибиться так же. В этом сила подхода - и в этом же его хрупкость.
Первое ограничение - данные. Двойник хорош ровно настолько, насколько богаты интервью и поведенческие записи под ним. На тонком описании получается тот самый средний персонаж, от которого и хотели уйти.
Второе - новизна. Модель воспроизводит прошлое поведение. В ситуации, которой в жизни человека и близко не было, ей не на что опереться, и она домысливает.
Третье - этика и приватность. Строить цифровую копию конкретного человека по его интервью и покупкам - территория, где вопросы согласия и владения данными пока опережают ответы. Кому принадлежит твой двойник и что он имеет право за тебя «решать» - вопрос без готового ответа.
Так что цифровые двойники - не хрустальный шар, а новый и довольно точный инструмент прогноза. Уже сегодня он способен отсеять слабые идеи до того, как ты потратишь на них деньги. А куда это вырастет за пару лет, если ставка на симуляцию как новый scaling law сыграет, - вот за этим и стоит наблюдать.