24 августа 2026 г.
Spec-driven development: почему код перестаёт быть главным артефактом
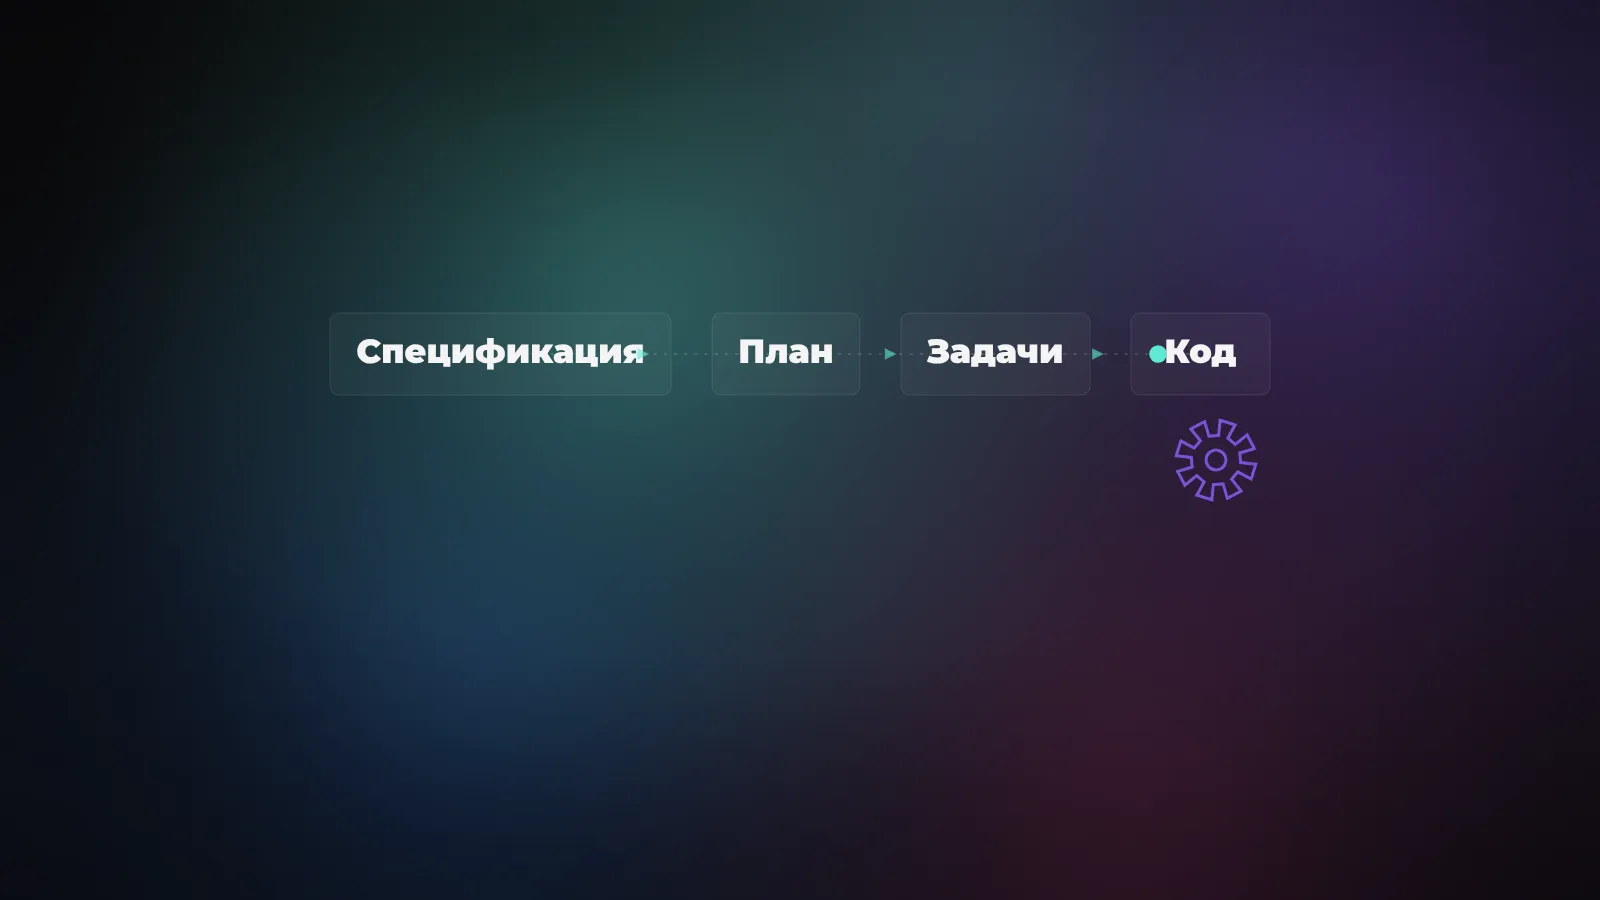

Spec-driven development (SDD) - это подход, где главным артефактом проекта становится не код, а спецификация: сначала ты пишешь понятный документ о том, что и зачем система делает, а код агент генерирует уже из него. Спека - источник правды, код - производное, которое можно пересобрать. Так ИИ-агент перестаёт угадывать за тебя.
За последний год спека тихо переехала в центр разработки на ИИ. Дошло до того, что Claude Code стал сам, без спроса, дописывать правила и спек-файлы после каждой правки - на Reddit из-за этого целые треды жалоб. Инструменты не просто так тянут тебя в эту сторону. За ними стоит цельная методология, и её стоит понять, прежде чем ругать агента за самодеятельность.
Почему вайб-кодинг упирается в потолок
Вайб-кодинг - это когда ты кидаешь агенту короткий промпт и принимаешь то, что он выдал, по ощущению «вроде работает». Для одноразового прототипа или чтобы за вечер проверить идею - отличный режим, ничего лучше не придумали. Проблемы начинаются, когда из прототипа вырастает что-то, что надо поддерживать.
Тут вылезают три болячки. Первая - расползание замысла. Ты недоописал задачу, агент дописал за тебя дефолтами, и эти дефолты не совпали с тем, что ты держал в голове. Вторая - забывчивость. Проект растёт, вылезает за окно контекста, и агент начинает противоречить решениям, которые сам же принял двести строк назад. Третья - непроверяемость. Ты не задал критериев готовности, и теперь ревью превращается в бесконечное «а вот тут точно правильно?» без ответа.
Все три растут из одного корня: агент - очень старательный, но буквальный исполнитель. Он силён в распознавании паттернов и слаб в чтении мыслей. Дай ему двусмысленную инструкцию - получишь двусмысленный результат, и чем больше кода, тем дороже это чинить.
Спека вместо кода: в чём переворот
Обычно источником правды в проекте был код. Документация отставала, ТЗ пылилось в почте, а как система работает на самом деле - знал только тот, кто читал исходники. SDD переворачивает эту иерархию. Правда теперь живёт в спецификации, а код - это то, что из неё сгенерировано, и при желании его можно снести и пересобрать заново.
Ключевая фраза, которую повторяют в GitHub и AWS: «спека - это и есть промпт». Ты не подсказываешь агенту наводящими репликами в чате. Ты один раз внятно описываешь, что должно получиться, и это описание становится и заданием, и критерием приёмки, и документацией. Код - расходный материал: не понравился результат, поправил спеку, пересобрал.
Звучит как возврат к тяжёлым ТЗ из нулевых, но разница принципиальная. Раньше подробное ТЗ писали для человека, который потом месяцами кодил вручную. Теперь спеку читает агент, который превращает её в код за минуты. Стоимость «переписать всё с нуля» упала настолько, что подробное описание наконец окупается.
Четыре шага плюс конституция
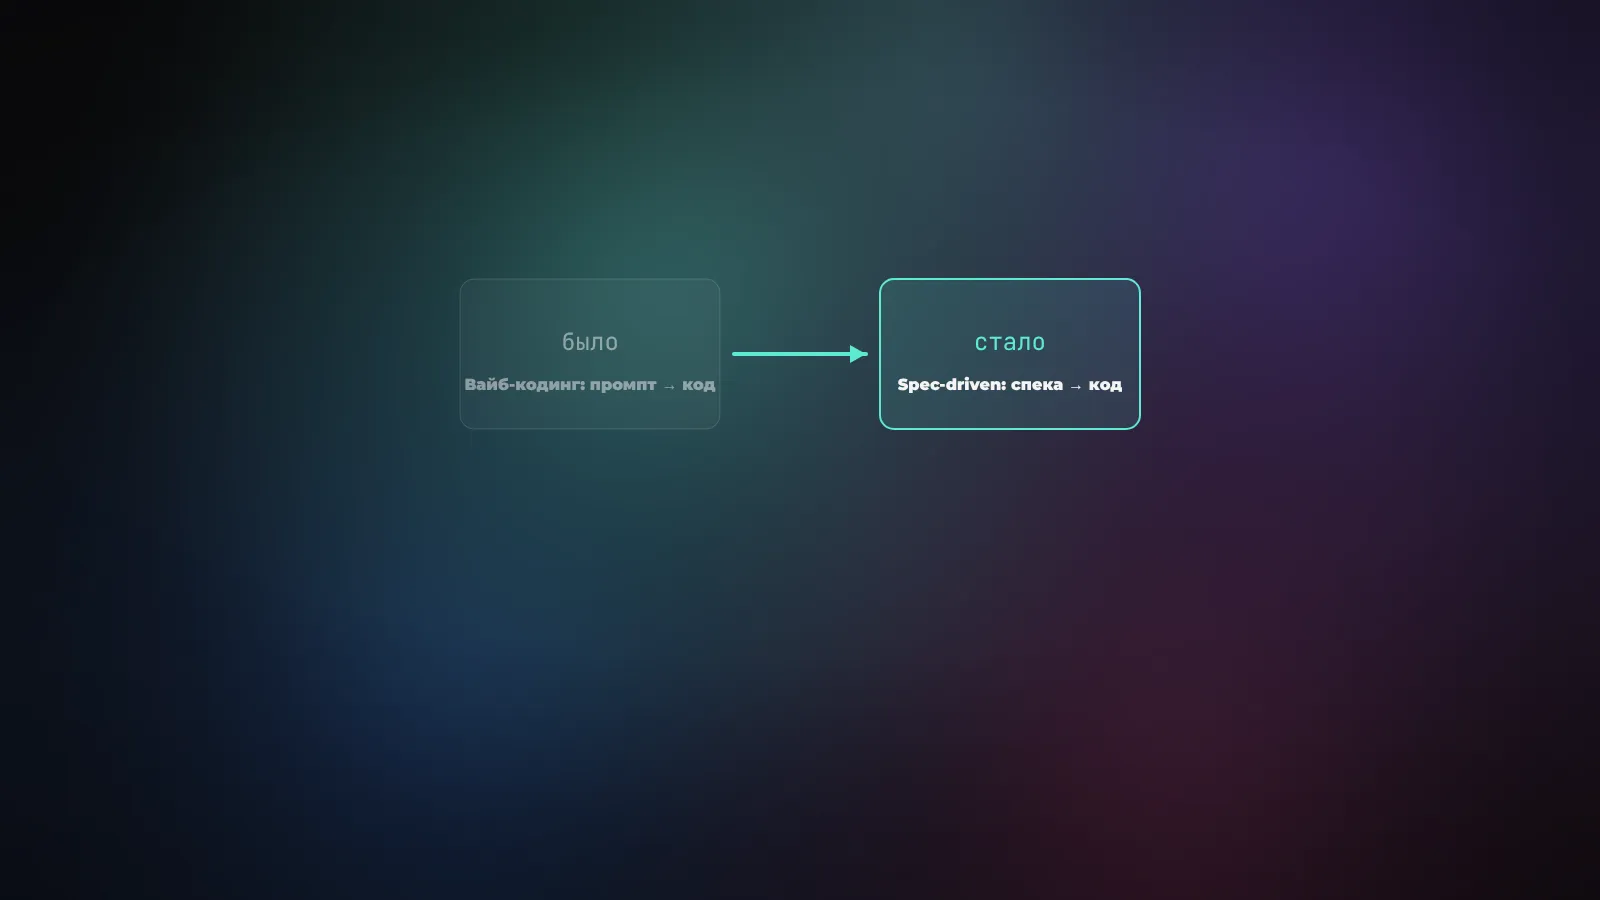
У методологии есть внятный порядок. Перед всем идёт конституция проекта - документ с неотменяемыми правилами: на каком языке пишем, как тестируем, какие зависимости можно тянуть, что с безопасностью и доступностью. Это фон, который агент держит в голове на каждом шаге. Дальше - четыре фазы.
Спецификация. Ты описываешь, что и зачем: пользовательские истории, критерии приёмки, что в границах задачи, а что явно за бортом. Ни слова про технологии - только поведение.
План. Агент предлагает, как это построить: архитектуру, модель данных, контракты API, какие библиотеки взять. Здесь живут технические решения.
Задачи. План разбивается на атомарный чек-лист - мелкие пункты, каждый из которых можно сделать и проверить отдельно, выстроенные по зависимостям: фундамент раньше того, что на него опирается.
Реализация. Агент идёт по списку и пишет код, сверяясь с критериями приёмки. Ты как человек проверяешь не финальную кашу целиком, а результат на границе каждой фазы.
EARS: как писать требования, чтобы агент не гадал
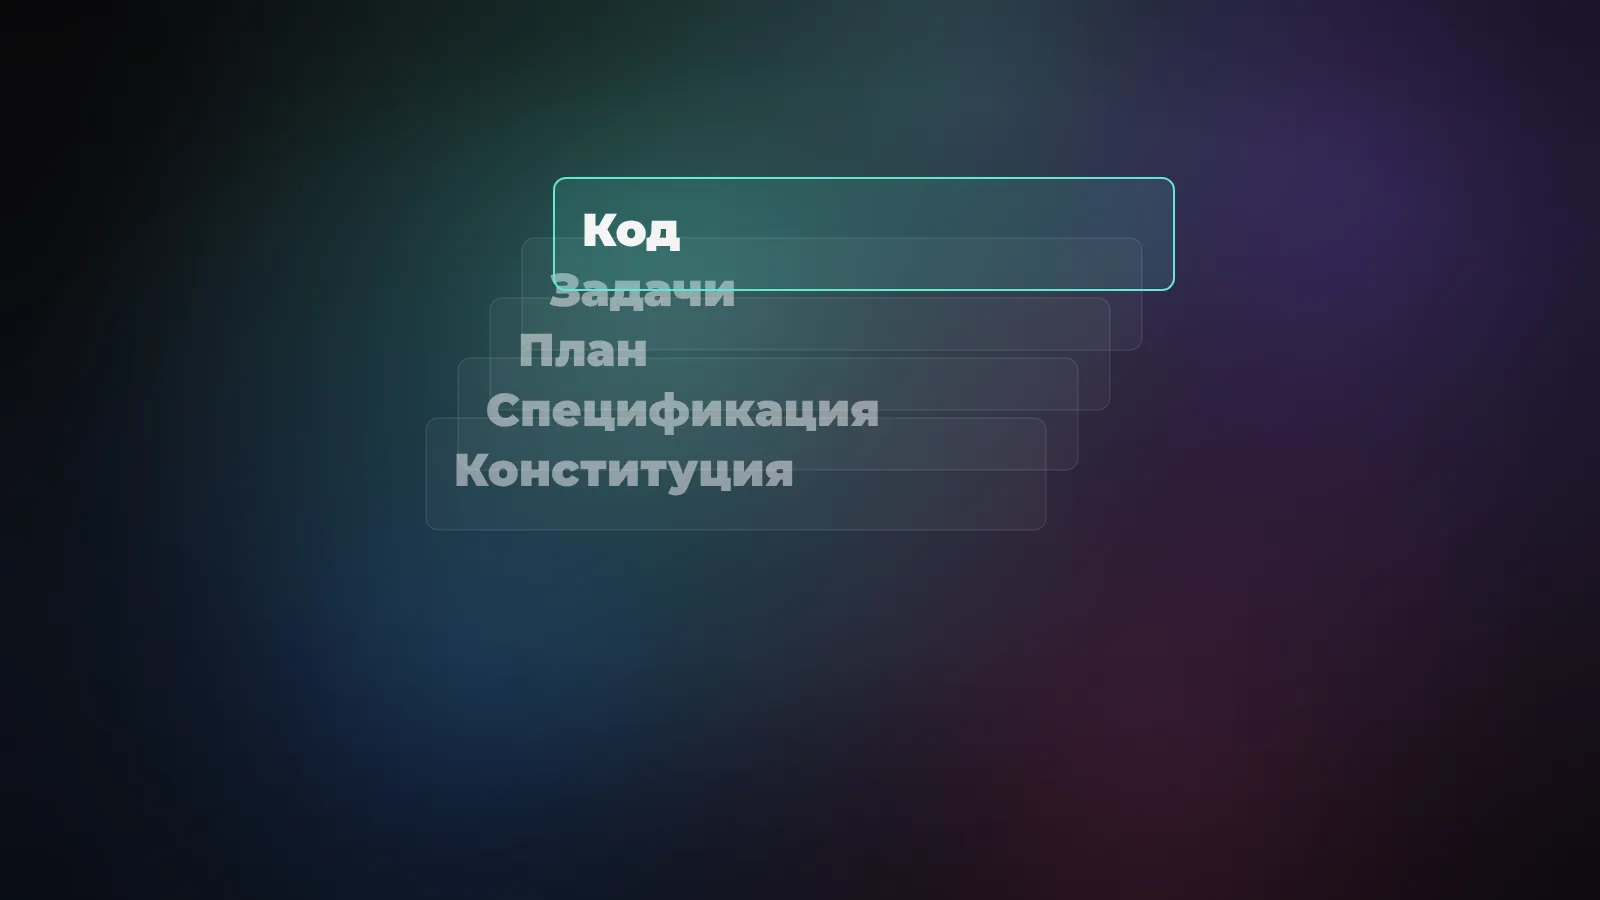
Главный секрет спеки, которая работает, - однозначные формулировки. Для этого придумали нотацию EARS (Easy Approach to Requirements Syntax): пяток простых шаблонов, которые не дают требованию расплыться.
Основных паттернов немного. Постоянное правило: «Система должна логировать каждую попытку входа». Событие: «КОГДА пользователь отправляет форму входа, ТОГДА система проверяет учётные данные». Нежелательное поведение: «ЕСЛИ проверка провалилась три раза за минуту, ТОГДА заблокировать аккаунт на 15 минут». Состояние: «ПОКА идёт синхронизация, показывать индикатор прогресса». Опция: «ГДЕ включена двухфакторка, требовать одноразовый код».
Разница между «сделай нормальную авторизацию» и такими фразами - это разница между агентом, который гадает, и агентом, который знает. Amazon в своём IDE Kiro формализует критерии приёмки ровно через EARS, и это не случайность: буквальному исполнителю нужна буквальная инструкция.
Чем это делают: Spec Kit, Kiro и другие
Инструментов уже целый выводок. Главный открытый - GitHub Spec Kit. За неполный год он собрал больше 130 тысяч звёзд на GitHub и добрался до версии 1.0 - один из самых быстрорастущих девелоперских проектов года. Он не привязан к одной модели: работает с тремя десятками агентов, включая Claude Code, Copilot, Cursor, Gemini CLI и Codex CLI. Ставится через specify init, а дальше ты гоняешь фазы командами вроде /speckit.specify, /speckit.plan, /speckit.tasks, /speckit.implement прямо из своего агента.
Второй заметный игрок - Amazon Kiro, агентный IDE, который с самого начала построен вокруг спеки. Ты описываешь цель словами, Kiro задаёт уточняющие вопросы, пока задача не станет прозрачной, и генерирует три документа - требования, дизайн и задачи, - которые становятся единицей работы и держатся в синхроне с кодом. Рядом крутятся Cursor с его режимом плана, лёгкий OpenSpec на голом Markdown и десяток решений поменьше.
Цифры вокруг подхода стоит читать со скидкой - их приводят сами вендоры, - но порядок показательный. GitHub говорит про «на порядок меньше циклов переписывания с нуля» по сравнению с наугад-промптингом. В корпоративных исследованиях 2026 года под управлением спекой заявляют кратное падение доли задач, которые агент проваливает с первого раза, и заметное сокращение времени до релиза. Точные проценты каждый меряет по-своему, но направление везде одно.
Что это меняет для тебя
Первое и трезвое: спека нужна не всегда. Собираешь одноразовый скрипт, проверяешь гипотезу за вечер, лепишь демку на выброс - вайб-кодинг тут быстрее и приятнее, не насилуй себя формальностями. SDD начинает окупаться, когда задача нетривиальна, живёт долго, размазана по многим файлам или её пилят несколько человек. Чем дольше проекту жить, тем дороже обходится «агент угадал не так».
Второе: тебе не обязательно тащить весь Spec Kit, чтобы забрать главное. Сама дисциплина ценнее тулинга. Перед тем как отпустить агента в код, напиши короткий человеческий документ: что делаем, зачем, как поймём, что готово, чего точно не делаем. Даже пять внятных строк в стиле EARS срезают половину недопониманий - без единой новой команды.
Третье: посмотри на это глазами того самого треда с жалобами. Claude Code, дописывающий спек-файлы сам, раздражает, но он честно отражает, куда движутся инструменты - от болтовни в чате к управляемому артефакту. Можно с этим бодаться, а можно возглавить: если агент всё равно тянется писать спеку, задай её сам и по-человечески, чтобы она была твоей, а не собранной наугад из твоих правок.
Общий смысл простой. Год назад главным навыком работы с ИИ-агентом считалось умение хорошо попросить в чате. Spec-driven development смещает акцент: выигрывает не тот, кто ловчее подсказывает, а тот, кто заранее внятно договорился с агентом, что именно строим. Код при этом из ценности, которую бережёшь, превращается в то, что можно пересобрать в любой момент - лишь бы спека была правдой.