4 сентября 2026 г.
Почему четыре ИИ легли в один день - и что это значит для тех, кто на них полагается

3 сентября почти одновременно перестали отвечать ChatGPT, Claude и Grok - несколько крупнейших ИИ-сервисов легли в одно утро. Единой подтверждённой причины публично нет, но два из этих гигантов уже сидят в одном дата-центре. Вывод простой: ИИ стал инфраструктурой, и держать продукт на одном провайдере без запасного плана теперь опасно.
Сама по себе авария на пару часов - не новость, сервисы падают у всех. Новость в том, что легли сразу несколько независимых компаний в одно окно, и никто внятно не объяснил почему. Я разобрал, что известно точно, что осталось догадкой, и что из этого стоит унести тому, у кого на ИИ завязан продукт или рабочий процесс.
Что именно упало и когда
Утром в четверг, 3 сентября, по тихоокеанскому времени почти в одну минуту начали сыпать Grok и Claude - примерно в 6:30. ChatGPT подключился к общему празднику позже, около 7:30, с отдельной «ошибкой маршрутизации», и вместе с ним лёг Codex. Claude полностью восстановился к середине утра, OpenAI дочинили к обеду.
Заголовки написали про четыре сервиса, но твёрдо подтверждены три - ChatGPT, Claude и Grok, их падение зафиксировали сразу несколько независимых изданий. Четвёртым в списках идёт Gemini, но там аккуратнее: был всплеск жалоб на трекерах вроде DownDetector, а официально Google сбой не признал, часть репортёров вообще пишет, что Gemini устоял. Так что «четыре» - это про заголовок, реально твёрдых три.
По сообщениям пользователей, посыпалось и то, что стоит поверх этих API. ИИ-редактор Cursor ловил отказы по всей цепочке запасных моделей, у Claude не создавались новые чаты, у OpenAI не работали логины, загрузка файлов и голосовой режим, Grok пропал в X и в мобильных приложениях. Детали downstream в основном из обсуждений и единичных источников, поэтому беру их как иллюстрацию, а не как протокол.
Общей причины официально нет - и Azure тут ни при чём
Сразу расставлю честно: единую общую причину публично никто не подтвердил. На этом сходятся вменяемые издания - Ars Technica, Axios, The Register.
При этом по сети мгновенно разошлась версия, что виноват сбой Microsoft Azure в регионе East US. Её растащили десятки контент-ферм, но это неправда: Microsoft причастность отрицает, а AWS, Azure и Cloudflare о крупных авариях в это окно не сообщали. Технический директор Cloudflare отдельно открестился в обсуждении на Hacker News. Так что красивая версия «одно облако уронило всех» на фактах не стоит.
OpenAI свой инцидент описала отдельно - как ошибку маршрутизации по ChatGPT и Codex, и случился он заметно позже остальных. Похоже на самостоятельную поломку, а не на общий рубильник.
Но два из четырёх сидят в одном дата-центре
А вот здесь начинается самое интересное. Grok упал не просто так: xAI официально назвала причиной сбой в своём вычислительном центре в Мемфисе - это площадка Colossus. Компания даже извинилась публично, и не только перед пользователями Grok, но и, дословно, перед «пострадавшими партнёрами по вычислениям».
Кто эти партнёры? Тут всплывает деталь, которая многое объясняет. Anthropic - та самая компания, что делает Claude - арендует мощности этого же мемфисского дата-центра. По данным CNBC, Bloomberg и DataCenterDynamics, речь о контракте примерно на 1,25 миллиарда долларов в месяц до 2029 года, сотни мегаватт и больше двухсот тысяч видеокарт. То есть Grok и Claude физически живут в одном здании.
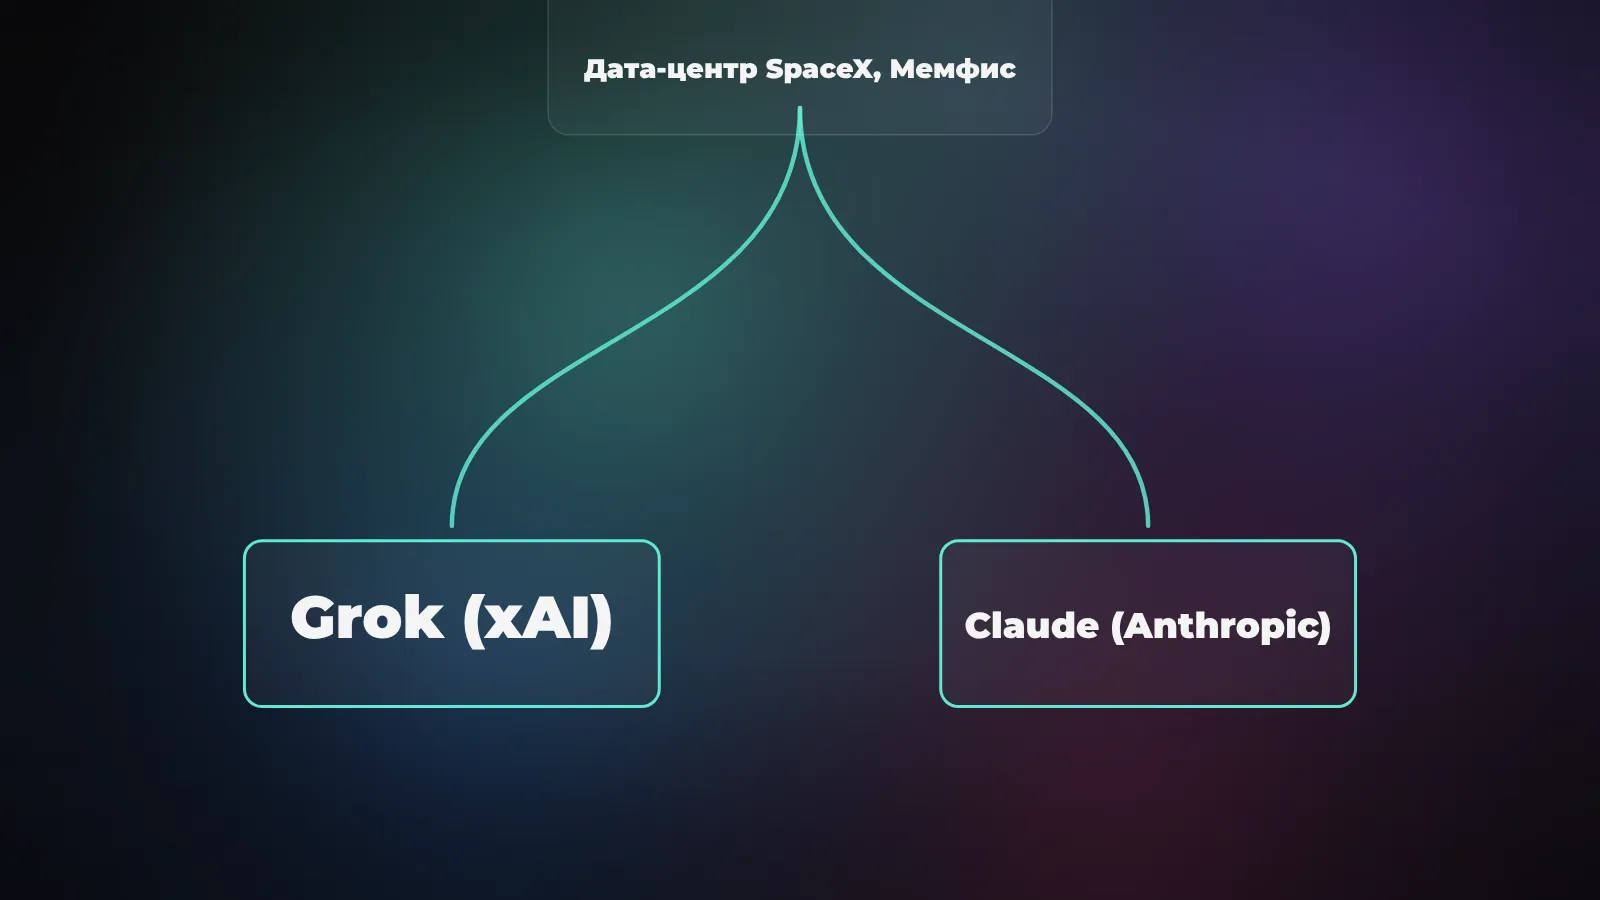
Соблазн сделать вывод огромный: одна площадка чихнула - и легли сразу два конкурента. Но честно: ни Anthropic, ни xAI прямо не сказали, что мемфисский сбой уронил именно Claude. Совпадение по времени сильное, общая инфраструктура известна, извинение «перед партнёрами» звучит красноречиво - но причинную связь официально никто не подтвердил. Так что держу это как очень правдоподобную нить, а не как доказанный факт.
Даже в таком виде картинка отрезвляет. Два публичных соперника, которые в маркетинге меряются рвами и уникальностью, на уровне железа уже сидят на одной точке отказа. И это без всякого общего облака - просто потому, что мощностей под ИИ мало, а строит их пока горстка игроков.
Эффект домино: как падение одного роняет соседей
Есть и второй механизм, который не требует общего дата-центра. Когда ложится один крупный сервис, его нагрузка не испаряется - она переливается на соседей. Часть пользователей идёт руками в другой чат, а инструменты с автоматическим запасным вариантом, вроде того же Cursor, сами перекидывают запросы на другую модель. Соседи получают всплеск сверх обычного и тоже начинают захлёбываться.
Это пока гипотеза, а не установленный факт по сентябрьскому случаю - но паттерн не новый. В июне 2024 года ровно так же в одно окно легли ChatGPT, Claude и Perplexity, и продержались недоступными около шести часов. Тогда каскад перетока нагрузки задокументировали открыто.
Соедини две вещи - общую инфраструктуру снизу и переток нагрузки сверху - и станет понятно, почему «независимые» сервисы всё чаще падают синхронно. Независимость у них в интерфейсе и в биллинге, а вот в фундаменте её всё меньше.
Главное: ИИ перестал быть «плюшкой»
Лучше всех смысл события сформулировал аналитик Forrester Чарли Дай. По его словам, почти одновременные сбои показывают, что ИИ превращается из приятного дополнения к продуктивности в операционную инфраструктуру. А когда несколько крупных провайдеров падают внахлёст без внятной общей причины, компании просто не могут оценить свой системный риск: непонятно, насколько ты завязан на одну точку и повторится ли это завтра.
Вот в чём поворот. Пока ИИ был игрушкой для черновиков и картинок, его недоступность на три часа никого не разоряла - подождал и ладно. Как только на нём завязаны реальные процессы - поддержка клиентов, обработка заявок, кодовый пайплайн, - каждый час простоя стоит денег и нервов. Ты уже зависишь от ИИ так же, как от электричества и интернета, только резервного генератора себе не поставил.
И зависимость эта концентрированная. Рекомендация Forrester звучит скучно, но бьёт в точку: мульти-модельная стратегия, запасные сценарии на случай отказа и план непрерывности бизнеса. То, что раньше писали в регламентах про дата-центры, теперь придётся писать про доступ к нейросетям.
Как подстраховаться
Перейдём от философии к делу. Что конкретно сделать, если у тебя на ИИ завязан продукт или рабочий поток.
Не ставь один ИИ-сервис на критический путь без запасного. Если без ответа модели у тебя встаёт вся цепочка - это не автоматизация, а мина. Держи как минимум второго провайдера, на которого можно переключиться.
Самый простой способ не привязываться к одному имени - единый шлюз к разным моделям. Про OpenRouter я подробно писал отдельно: один ключ, автоматический переброс на живого провайдера, когда основной упал. Но у сентябрьской истории есть отдельный урок именно про запасной вариант.
Заложи в продукт мягкую деградацию. Сервис должен пережить недоступность ИИ, а не падать вместе с ним: поставь запрос в очередь, отдай заранее заготовленный ответ, покажи ручной путь. Пользователь стерпит «сейчас чуть медленнее», но не стерпит белый экран.
Для по-настоящему критичных сценариев держи локальную модель как аварийный резерв. Она слабее облачной, но работает, когда весь внешний ИИ лежит. Как поднять открытую модель на своём железе, я разбирал на примере Glimmer - для запасного контура этого часто достаточно.
И последнее, самое дешёвое: подпишись на статус-страницы своих провайдеров и не зашивай в код один-единственный эндпоинт. Когда что-то ляжет снова - а оно ляжет, - ты хотя бы узнаешь об этом раньше своих пользователей.
Источники
- The Register: ChatGPT, Claude and Grok all had outages at the same time - три подтверждённых сервиса и хронология
- 9to5Google: ChatGPT, Claude, Grok outages - тайминги и опровержение версии про Azure
- Engadget: SpaceXAI apologizes for outage that affected Grok and compute partners - официальное извинение и упоминание «партнёров по вычислениям»
- CNBC: Anthropic and SpaceX data center capacity и DataCenterDynamics про контракт на аренду - Anthropic арендует мемфисский дата-центр
- IT Pro: комментарий аналитика Forrester про ИИ как операционную инфраструктуру - концентрационный риск и рекомендации
- TechCrunch: ChatGPT, Claude and Perplexity down at the same time (июнь 2024) - прецедент синхронного сбоя