14 ноября 2026 г.
MAI-Transcribe-2: сколько стоит расшифровка речи и как попробовать модель Microsoft

MAI-Transcribe-2 - облачная модель Microsoft для перевода речи в текст, в том числе русской. Сейчас её можно попробовать через Azure Speech или OpenRouter: ориентир цены - $0.10 за час записи, но Microsoft называет его временным. Для встреч и субтитров полезны разделение говорящих и таймкоды; прежде чем подключать поток файлов, проверь качество на своих записях и фактический счёт.
Поводом стал новостной дайджест, но у релиза есть дата: карточка Microsoft датирована 3 сентября 2026 года. Так что свежесть здесь не в громком анонсе. Интереснее другое: можно ли за небольшую цену получить рабочие расшифровки звонков, роликов и встреч, не собирая собственную инфраструктуру? Я проверил документацию и независимые замеры, а платный запрос за тебя не делал.
Что вышло и для каких записей
Это модель ASR, автоматического распознавания речи. Даёшь ей аудиофайл, получаешь слова, которые в нём произнесли. В документации Azure Speech перечислены WAV, MP3 и FLAC. Microsoft заявляет поддержку 60 языков, включая русский, и автоматическое определение языка. Модель создана для обработки записи; обещать на её основе телефонный разговор в реальном времени было бы неверно.
У второй версии есть вещи, которые нужны после простого «дай текст». Диаризация распределяет реплики по говорящим. Таймкоды помогают привязать слово к месту в аудио. Список терминов подсказывает модели имена и профессиональные слова, которые она могла бы не расслышать. Можно запросить дословный вариант с запинками или более чистый текст без слов-паразитов. Это конкретные настройки из справки Microsoft, а не обещание, что каждая фамилия будет записана идеально.
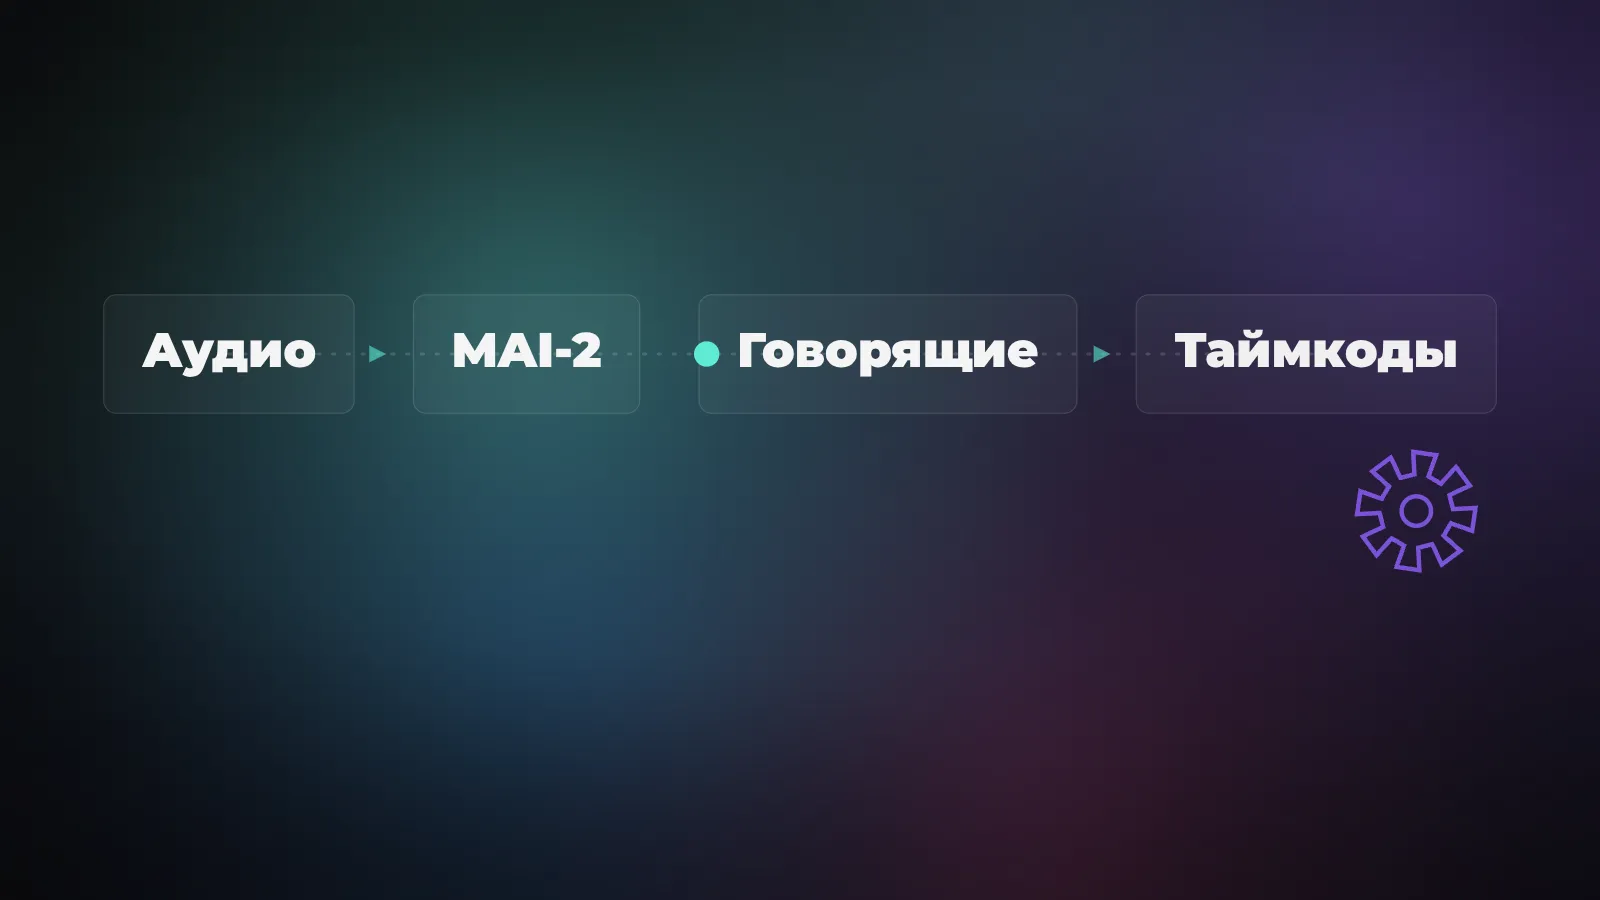
Для меня здесь главный вопрос не «обгоняет ли модель всех», а сколько ручной правки останется после обработки именно твоего материала. Запись совещания с плохим микрофоном, голосовое сообщение с жаргоном и студийное интервью - разные тесты. Одна модель может хорошо справляться с первыми двумя и путать имена в третьем.
Цена за час: где легко ошибиться
В модельной карточке Microsoft указаны $0.10 за час аудио как временное предложение. Страница модели у OpenRouter показывает те же $0.10 за час для своего маршрута через Azure. Это тариф за длительность входящей записи, а не за час ожидания ответа или за время работы сотрудника. Десять часов аудио по этой ставке - $1, если ставка и способ учёта не изменятся.
Не стоит смешивать цену распознавания и полный бюджет проекта. Если нужен бот на звонке, добавятся телефония, хранение записей, возможная обработка персональных данных, исправление ошибок и, вероятно, отдельная модель для ответа. Из распознанного текста само собой не появится ни протокол встречи, ни правильное решение по клиентскому обращению. За эти задачи придётся отвечать отдельно.
У OpenRouter на карточке сейчас указан один провайдер - Azure. Это удобный вход через общий API-шлюз, но не запасной независимый движок распознавания на случай сбоя Microsoft. Если тебе важна отказоустойчивость, второй маршрут через тот же Azure не решает вопрос. Цена у Azure при прямом подключении может зависеть от договора, региона и конкретного биллинга: сверь фактический тариф до запуска, не пересчитывай один публичный прайс в гарантию своего счёта.
Как попробовать без сервера с видеокартой
Самый прямой технический путь - Azure Speech. Понадобятся подписка Azure, Speech-ресурс в поддерживаемом регионе, ключ и короткий файл в подходящем формате. Официальный пример REST-запроса отправляет файл и JSON-описание в multipart-запросе; чтобы получить именно эту модель, включают enhancedMode.enabled: true и задают enhancedMode.model: "MAI-Transcribe-2". Если опустить настройку, легко проверить совсем другой маршрут распознавания и сделать неправильный вывод о качестве.
На практике я бы начал с одной минуты своего аудио. Создал ресурс, посмотрел регион в Azure Portal, взял оттуда ключ, загрузил файл в отдельном тестовом проекте и сравнил результат с записью на слух. Ключ не вставляй в публичную команду, скриншот или репозиторий. Сначала добейся ответа на обычном файле, затем добавляй разделение говорящих и таймкоды: если включить всё сразу, труднее понять, где ошибка конфигурации, а где ошибка модели.
В PDF-карточке для модели назван предел 300 MB или два часа на один файл. Но Microsoft Learn отсылает к отдельной REST-справке за актуальным пределом: если у тебя длинная запись, проверь его для своего маршрута и разбей файл без обрыва слов. Не переноси это ограничение автоматически на все интеграции с моделью.
Альтернативный вход - страница MAI-Transcribe-2 у OpenRouter. Если у тебя уже есть оплаченный аккаунт и принято отправлять аудио через этот шлюз, можно сверить доступность и цену там. Это тоже облачный вызов: запись уходит к стороннему сервису и его провайдеру, а не остаётся на твоём ноутбуке. Для чувствительного аудио сперва проверь юридические и организационные ограничения на передачу записи.
Говорящие, таймкоды и имена: что включать
Azure Speech позволяет включить диаризацию через настройку diarization.enabled: true. На выходе появляются сегменты с идентификаторами говорящих и временными смещениями. Но «говорящий A» не означает «это Иван из отдела продаж». Чтобы получить имя, придётся сопоставить голос с человеком отдельно, и при одновременной речи проверить границы вручную.
У таймкодов несколько режимов. modelOptions.timestamps: "word" даёт позицию для каждого слова; режим сегментов полезен, когда тебе нужны крупные блоки для навигации, а отсутствие таймкодов экономит лишнюю структуру в ответе. Для субтитров и поиска конкретной цитаты по ролику я бы взял слова. Для обычного черновика заметок можно обойтись сегментами. Эти поля подтверждаются описанием параметров Microsoft.
modelOptions.transcribeStyle: "clean" чистит слова-паразиты и помогает получить читаемый черновик; по умолчанию выбран дословный вариант. Для юридически значимой записи или расследования пропавшей реплики лучше оставить дословный стиль и сверить аудио с текстом. Чистый вариант может убрать то, что в контексте было важно: паузу, самопоправку, оговорку. Список фраз phraseList.phrases подсказывает термины, но не заставляет модель вставлять их в ответ вопреки звуку.
Насколько точны громкие цифры
Microsoft в карточке модели показывает свои сравнительные тесты на многоязычных записях и говорит о высокой скорости. Это проверяемая информация об условиях их испытания, но не доказательство, что на любом русском звонке MAI-Transcribe-2 будет быстрее и точнее всех. На скорость влияет способ отправки файла, очередь у провайдера и длина записи. На точность - качество микрофона, фон и словарь.
Посмотрел независимый рейтинг Artificial Analysis. Там для MAI-Transcribe-2 указан WER 2.0% в их тестовом наборе и цена $1.67 за тысячу минут по отображаемому тарифу. При этом у других моделей на той же странице есть и более низкая ошибка, и более низкая цена по отдельности. WER - доля ошибочно распознанных слов, меньше значит лучше в конкретном тесте. Таблица использует несколько собственных наборов с английской речью; делать по ней вывод «русский у этой модели лучший» нельзя.
Есть ещё ловушка самой метрики. В исследовании систем диктовки авторы сравнили ошибки при тихой речи, шёпоте и переключении языков и показали: похожий WER может скрывать разные практические провалы. MAI-Transcribe-2 в том исследовании не тестировали. Поэтому я беру работу как предупреждение о методике сравнения, а не как оценку Microsoft.
Сделай свой маленький эталон: вручную запиши правильный текст нескольких типичных отрывков, отметь имена, числа и перебивания. Потом прогони один и тот же набор через две модели при одинаковых настройках и посмотри не только на общий процент ошибок, но и на то, сколько минут ушло на исправление. Если после прогона приходится восстанавливать потерянные реплики, дешёвый тариф перестаёт быть дешёвым.
Кому подходит и где остановиться
Для субтитров длинного интервью, черновика протокола встречи или текстового поиска по аудио это разумный кандидат на тест. Можно получить текст и метки времени, а при нескольких участниках включить диаризацию. Русский язык есть в списке Microsoft, но это не гарантия качества на каждой записи, особенно с узкой терминологией и шумом.
Если тебе нужна живая беседа с мгновенным ответом, внимательно проверь требования к задержке и потоковому вводу: обработка готового файла и работа голосового агента во время звонка - разные сценарии. Если нужен перевод с одного языка на другой, распознавание речи само по себе его не делает. Полученный текст ещё надо передать переводчику или отдельной модели. И если нельзя отправлять запись за пределы своей инфраструктуры, облачная модель не подходит независимо от хорошей цены.
Я бы не покупал интеграцию вслепую. Взять тестовый файл, получить расшифровку, проверить слова и счёт, сравнить с уже используемым способом - такой эксперимент даст больше, чем любое «самая точная в мире». У MAI-Transcribe-2 есть конкретные настройки и понятный вход, но решение принимать тебе по собственному аудио.