2 октября 2026 г.
LM Arena: как сравнивать модели и читать рейтинг нейросетей

LM Arena, теперь просто Arena, помогает сравнить две нейросети на одном запросе вслепую: сначала читаешь оба ответа, голосуешь, а затем узнаёшь названия моделей. Рейтинг собирается из таких сравнений, но его лидер не обязан лучше всех решать твою задачу. Для выбора модели я бы смотрел нужную категорию и проверял ответы на собственных рабочих примерах.
В поиске до сих пор встречаются «lm arena» и «lmarena нейросеть». Это тот же сервис на новом адресе arena.ai: название сократили в январе 2026 года. Ниже покажу, что там нажимать, как читать таблицу и где она перестаёт быть полезной.
LM Arena: что это и зачем сравнивать модели вслепую
Представь, что выбираешь нейросеть для писем клиентам. В одном окне ответ А, в другом ответ Б, но сверху нет логотипов OpenAI или Anthropic. Ты видишь, какой текст точнее попал в задачу, а не то, сколько стоит подписка и кто сейчас громче всех в новостях. Это и есть Battle Mode.
Сервис вырос из исследовательского проекта Chatbot Arena. Теперь в нём есть отдельные арены для текста, кода, изображений и других задач. Важно не путать его с обычным каталогом моделей: у Arena есть и режим, где модель выбираешь сам, но голоса из такого режима в публичный рейтинг не попадают.
Частая ошибка - открыть общий лидерборд, выписать победителя и на этом закончить. Люди вносят в слепые битвы разные запросы, включая развлекательные. Если тебе нужен аккуратный разбор договора или исправление теста в репозитории, общий вкус аудитории - слабая замена проверке на таких же задачах. Отдельный обзор рейтинга нейросетей по задачам у меня уже есть; здесь речь именно о механике Arena, а не о том, кого сегодня объявить победителем.
Как провести слепой тест на Arena.ai
Открой официальный сайт Arena и выбери нужный тип задачи. Интерфейс меняется, поэтому ориентируйся на названия режимов, а не на положение кнопки в старом видео. Описание процесса от самой Arena укладывается в четыре действия:
- Перейди в Battle Mode для нужного типа материала: обычный текст для письма, код для задачи по разработке, изображения для визуального макета.
- Введи реальный запрос. Для письма полезно указать аудиторию, исходный текст и ограничения, например «не обещай скидку, которой нет в условиях». Но не вставляй персональные данные клиента в публичный тестовый сервис.
- Прочитай два ответа до голосования. Сравнивай не стиль приветствия, а выполнение условия, точность фактов и удобство результата. Если оба ответа плохи, не объявляй один из них хорошим только потому, что требуется выбрать.
- Отдай голос за лучший вариант и посмотри названия моделей после выбора. Зафиксируй для себя, что именно выиграло: модель, формулировка задачи или просто удачный единичный ответ.
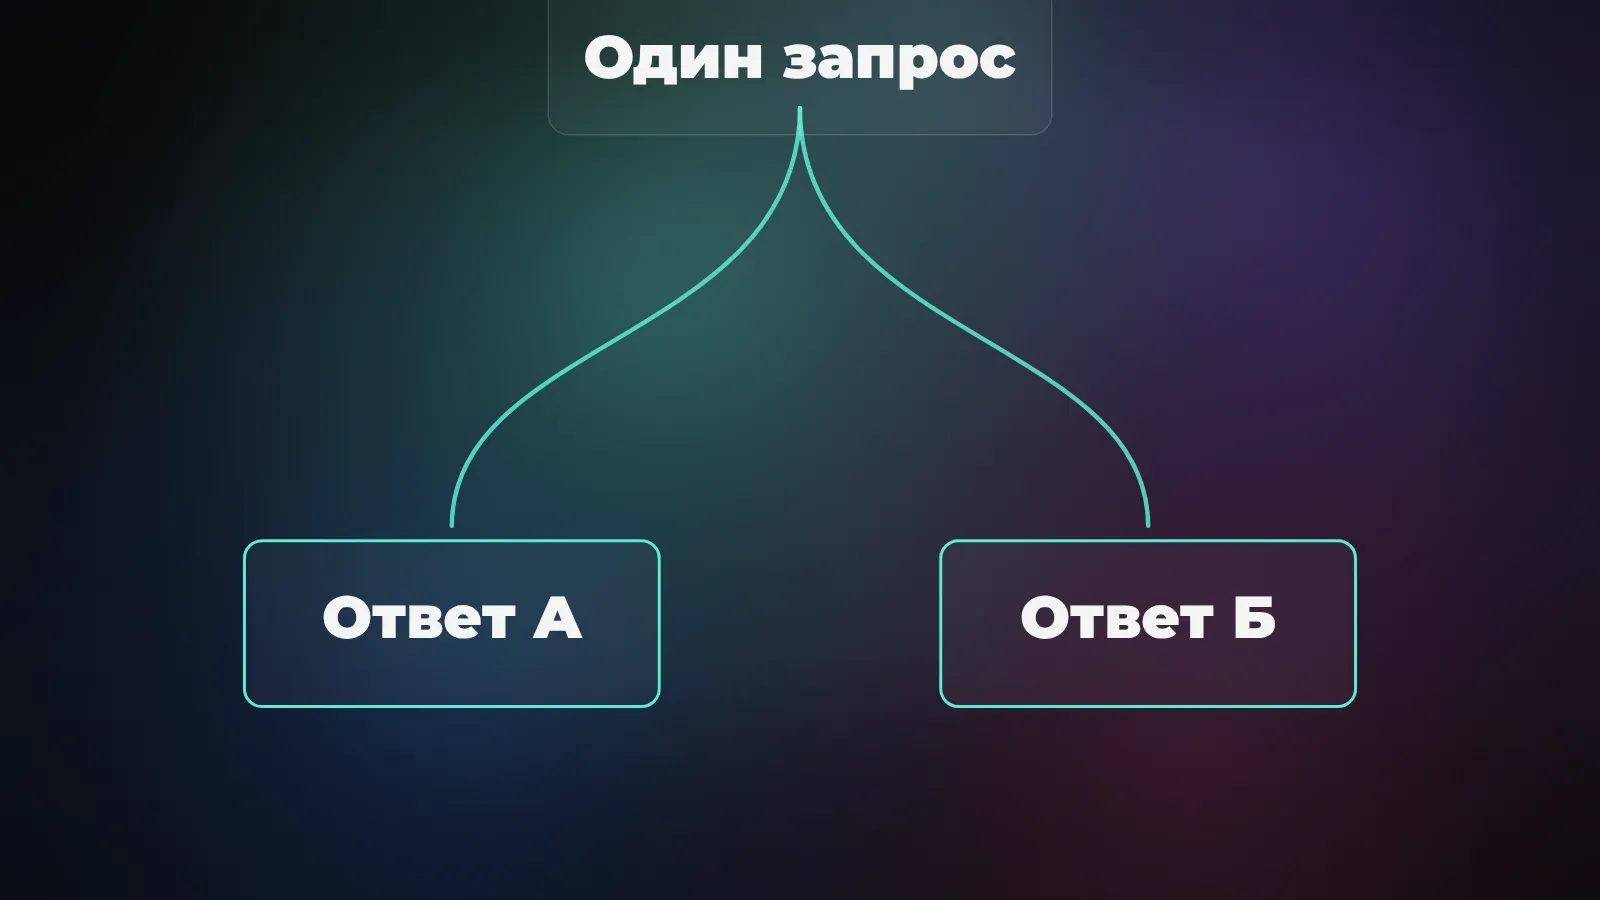
Я бы повторил тест на нескольких разных входных данных: коротком письме, длинном тексте и неудобном случае с противоречивыми требованиями. Один ответ может понравиться случайно. Серия ближе к тому, как модель поведёт себя в работе. Если сравниваешь модели для программирования, добавь проверяемый результат: тесты, дифф кода, список файлов, которые агент не должен был трогать.
Battle, Side by Side и Direct: куда идут голоса
Здесь легко запутаться, потому что в каждом режиме на экране может быть чат. Разница в том, знаешь ли ты название модели до выбора и влияет ли твой голос на общую таблицу. Официальный FAQ проводит границу довольно чётко.
| Режим | Что видишь до ответа | Влияет на публичный рейтинг |
|---|---|---|
| Battle | Две анонимные модели | Да, голос до раскрытия названий |
| Side by Side | Две выбранные тобой модели | Нет |
| Direct | Одну выбранную модель | Нет, голосования нет |
Если хочешь проверить конкретно Claude против конкретно Gemini, Side by Side удобнее: сам выбираешь пару. Но потом нельзя говорить, что личный эксперимент поднял модель в лидерборде. И наоборот, Battle хорош для независимого голосования, однако заранее выбранную пару тебе там не обещают. Названия могут открыться только после голоса; даже последующие оценки той же раскрытой пары не меняют официальный счёт.
В Arena есть и Agent Mode. Там оцениваются длинные задачи агента с инструментами, а рейтинг строится по другой методике, включая сигналы о выполнении задания. Не ставь его цифры в одну колонку со счётом текстовых слепых битв: измеряют разное.
Как читать рейтинг нейросетей, а не только первое место
В справке по лидербордам Arena перечисляет столбцы Rank, Rank Spread, Score и Votes. Rank - место в таблице; Score - оценка на основе результатов сравнений; Votes - сколько сравнений участвовало. Рядом со Score показывают диапазон неопределённости, а Rank Spread отражает возможный разброс места. Две соседние строки с перекрывающимися интервалами не стоит объявлять разными лигами.
Порядок вычисляют по модели Брэдли - Терри на парных предпочтениях людей. Это объяснение из FAQ Arena, а не старая формулировка про шахматный Elo из статей первых лет проекта. Число не измеряет «истинный интеллект». Оно сводит множество предпочтений в сравнительный показатель. Представь ресторанный рейтинг: полезен для выбора, но не сообщает, подойдёт ли тебе конкретное блюдо.
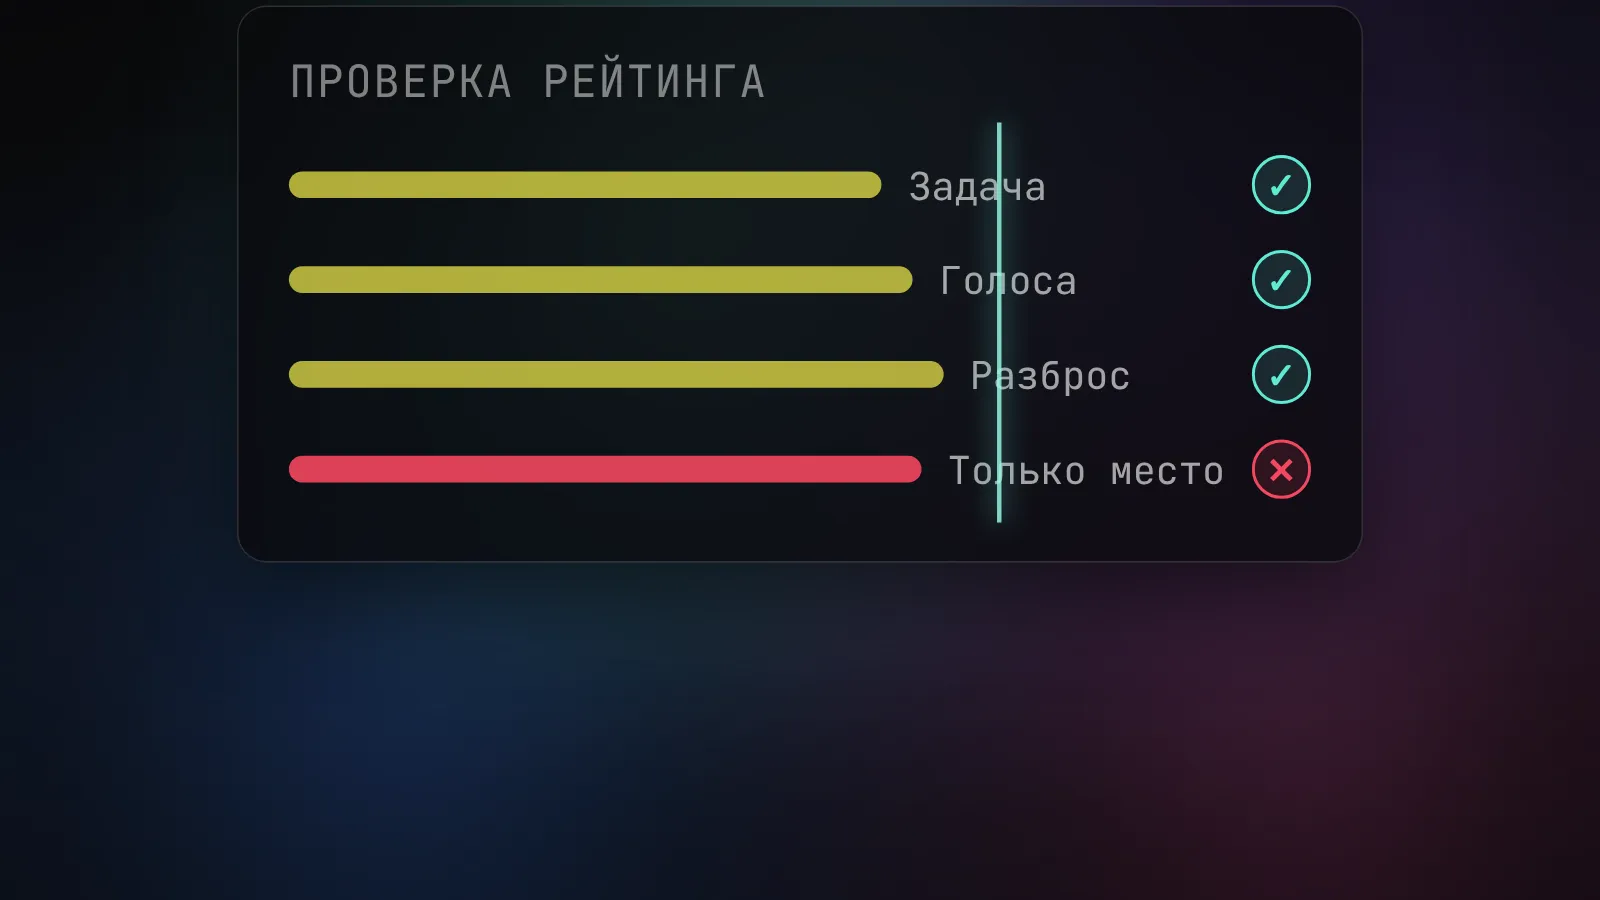
Начинай с вкладки задачи: Text, Code, Vision, Document, Search, генерация изображения или видео. Затем смотри фильтры: в интерфейсе есть, например, запросы специалистов и отдельные профессиональные категории. Для проверки правдоподобия фактов предусмотрен фильтр Factuality в Text и Search, но он использует сочетание предпочтения людей и проверки утверждений, то есть это отдельный критерий, а не просто альтернативное имя общего рейтинга.
Где лидерборд обманывает ожидания
Самая заметная ловушка - приятный ответ выигрывает голос даже тогда, когда в нём пропущено условие или придумана деталь. Оценка людей показывает предпочтение, поэтому для задач, где цена ошибки высока, проверяй факты отдельно. Опция Factuality полезна, но даже она не заменяет чтение первоисточника и тест результата. Особенно если речь о коде, расчёте или договоре.
Вторая проблема - неодинаковый состав запросов. Пользователь просит стихотворение, другой просит SQL, третий проверяет русский перевод. Общая позиция смешивает разные навыки. Категории уменьшают эту путаницу, но твоя рабочая нагрузка всё равно может отличаться от распределения запросов аудитории Arena. Сравнение нескольких собственных задач даёт более приземлённую картину.
Третья - стоимость. Лидерборд оценивает качество ответов, но не твою конечную цену за рабочую задачу. Проверь прайс выбранного провайдера, если запускаешь массовую обработку. Уточни расходы на вход и выход и то, позволяет ли нужный продукт вообще выбрать эту версию модели. О том, как устроена тарификация API на примере Claude, я писал отдельно. Строка в таблице не покупает тебе доступ.
Как выбрать модель для своей работы
Для себя я бы составил короткий лист проверки. Сначала категория, соответствующая задаче. Потом две-три модели из верхней группы, без поклонения первой строчке. После этого одинаковые тестовые входы и оценка ошибок: нарушено ли ограничение, есть ли выдуманные факты, собирается ли код. В конце - цена и доступность в твоём инструменте.
Если нужна нейросеть для кода, есть отдельное сравнение рабочих инструментов: IDE, агент и модель там влияют на результат вместе. Для повседневных задач полезнее обзор ИИ для работы. Arena помогает сузить выбор, но последнюю проверку делай на материале, за который будешь отвечать сам.
Источники: как работает Arena, FAQ о голосах и методике, справка по таблице и фильтрам, смена названия.