23 октября 2026 г.
ИИ для работы с аудио: расшифровка записи и очистка звука

ИИ для работы с аудио решает две разные задачи: переводит речь из готовой записи в текст и чистит звуковую дорожку от помех. Для расшифровки бери сервис с распознаванием речи или локальную модель, для ровного фонового шума - аудиоредактор. Сохраняй оригинал и проверяй имена, числа и смысл на слух: красивый текст ещё не означает точную стенограмму.
Я бы сначала спросил себя, какой результат нужен: цитаты для статьи, протокол разговора или чистый голос для публикации. Одна кнопка редко одинаково хорошо справляется со всеми тремя задачами. Особенно если запись сделана в шумном помещении и люди говорят одновременно.
Какая задача у аудио: текст, звук или оба результата
Готовая запись разговора и живой поток с микрофона требуют разной обработки. В руководстве OpenAI по транскрипции для законченного файла стартовой моделью названа gpt-transcribe, а для речи, поступающей в реальном времени, - gpt-live-transcribe. Нужна стенограмма интервью после созвона? Выбирай работу с файлом. Нужны субтитры во время прямого эфира? Это уже потоковая задача с другим способом подключения.
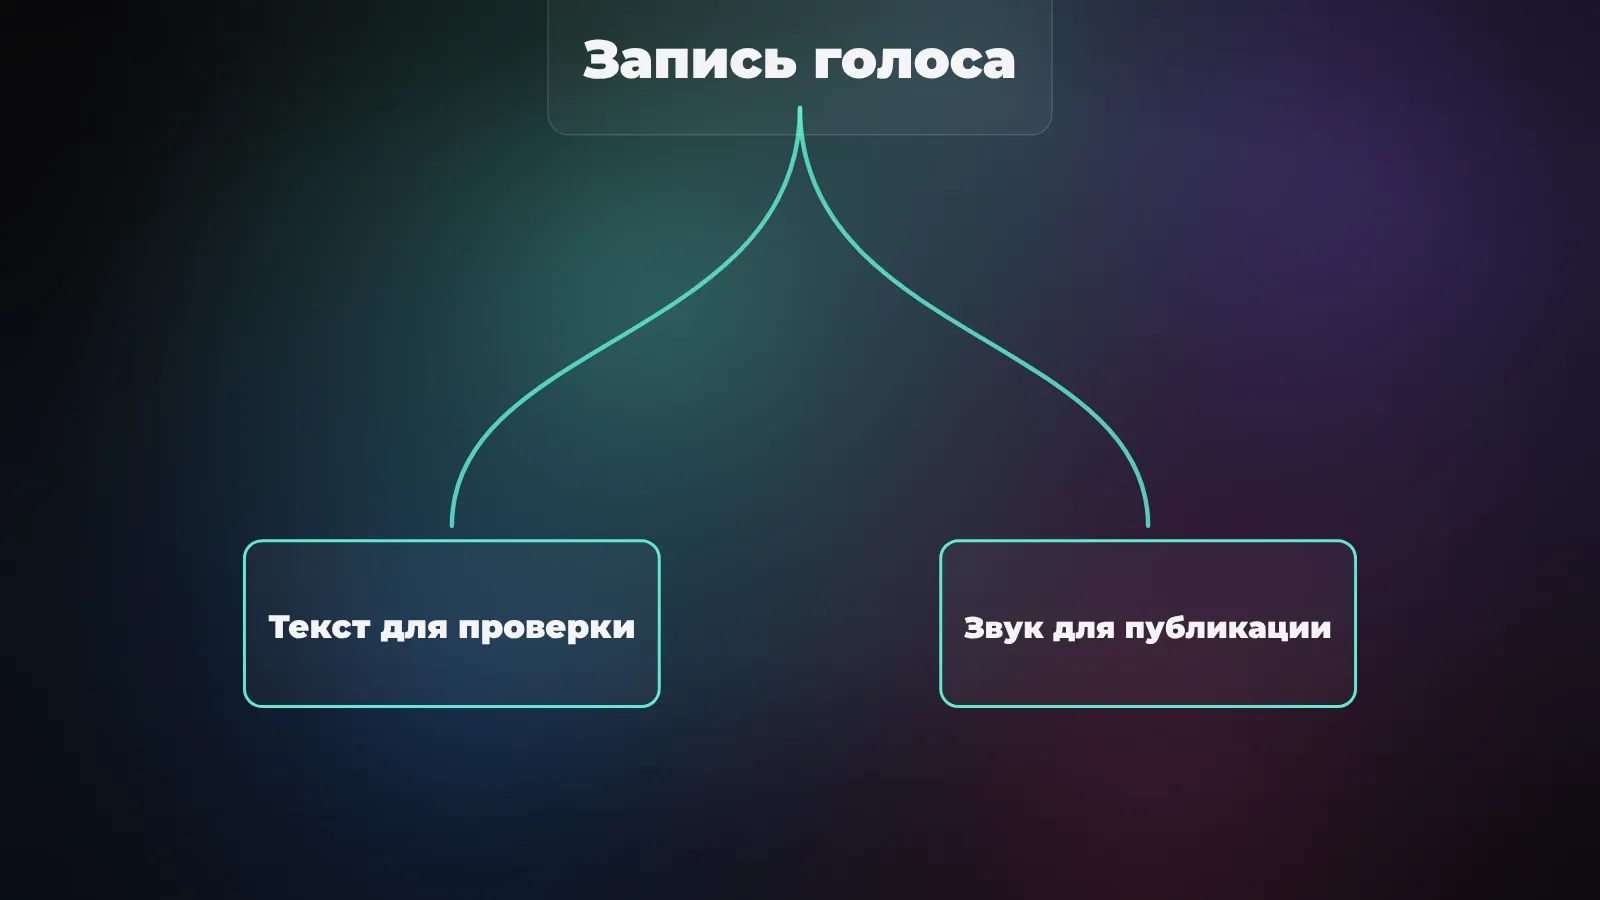
Очистка звука - отдельная работа. Результат распознавания может быть читаемым, хотя запись продолжает гудеть. Или наоборот: голос стал приятнее на слух, но расшифровщик перепутал фамилию и сумму договора. Поэтому делай два выхода: аудиофайл для прослушивания и текст для поиска и редактуры. Не считай один автоматической проверкой другого.
Если вопрос именно о видео, монтаже и автосубтитрах, есть отдельный разбор ИИ для работы с видео. Здесь речь о звуковой дорожке: интервью, голосовых заметках, подкасте и рабочей записи, из которых нужно извлечь текст или привести голос в порядок.
Расшифровка готовой записи: что делать с файлом
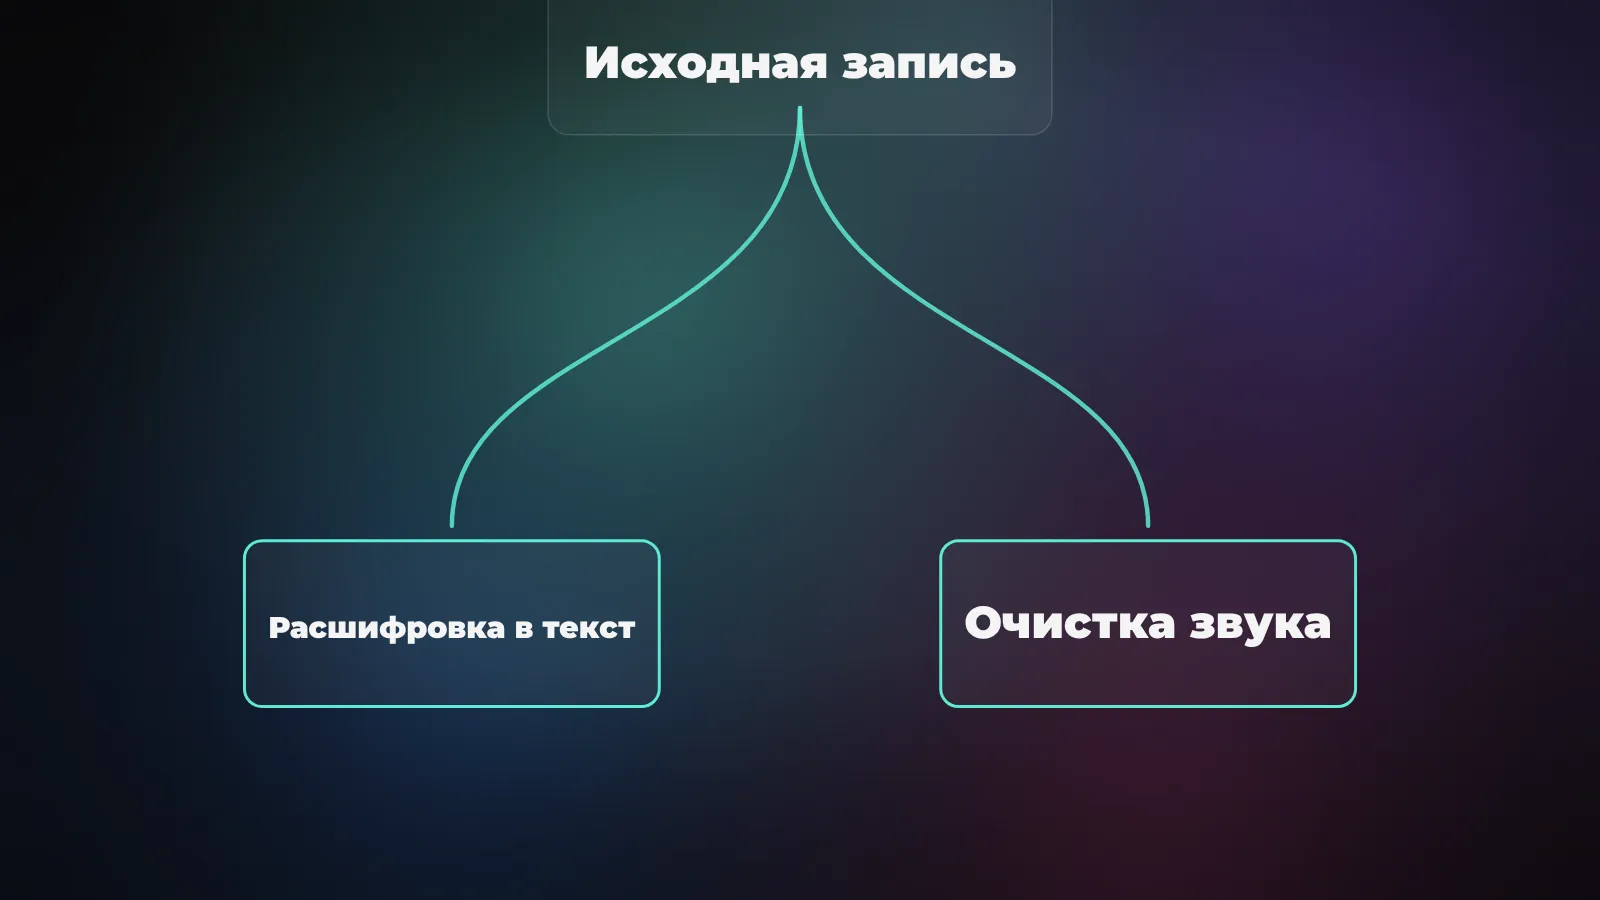
Первым делом сохрани исходник отдельно. Если запись не повреждена, не стоит бездумно пережимать её несколько раз перед расшифровкой: результат распознавания надо будет сравнивать с первоначальным звуком. Укажи рабочий язык, если сервис позволяет, и сделай первый проход на коротком фрагменте, где есть название компании, имя собеседника и шум. Именно на таких местах удобно оценить пользу выбранного инструмента.
Для разработчика OpenAI описывает загрузку готового файла в /v1/audio/transcriptions с моделью gpt-transcribe. На этой странице перечислены MP3, MP4, MPEG, MPGA, M4A, WAV и WEBM; лимит загружаемого файла - 25 MB. Большую запись придётся сжать или делить на части по смысловым паузам. Резать посреди слова или ответа плохо: следующая часть потеряет контекст.
В модели можно передать подсказку о теме и ожидаемые термины. Это полезно для фамилий, названий компаний и профессионального жаргона, но подсказка не доказывает, что слово прозвучало. OpenAI прямо предупреждает, что нерелевантные ключевые слова способны появиться в тексте, хотя в записи их не было. Поэтому список терминов - помощь распознаванию, а не замена прослушивания. Для рабочей стенограммы отмечай неуверенные места временем и оставляй пометку «неразборчиво», когда звук действительно не даёт ответа.
Старые инструкции могут советовать API-модель whisper-1 или gpt-4o-transcribe. Текущая справка по файловой транскрипции называет их устаревающими для API и указывает дату отключения 26 февраля 2027 года. При новой интеграции начинать с примера из давно опубликованного туториала - так себе идея. Это касается имён моделей облачного API, а не автоматического удаления локального проекта Whisper с твоего компьютера.
Локальная работа: когда запись нельзя отправлять в облако
Если звук содержит чувствительные рабочие сведения, я сначала выясняю правила обращения с данными. Кто владеет записью, разрешено ли загружать её в сторонний сервис, кому потом откроется расшифровка? Фраза «я просто попробую бесплатную кнопку» этих вопросов не снимает. Сделай обезличенный тестовый файл либо используй локальную обработку, если передача исходника третьей стороне недопустима.
Открытый проект Whisper от OpenAI позволяет запускать распознавание локально. Это отдельный способ эксплуатации модели, отличающийся от одноимённого устаревающего API-идентификатора. В README есть требования к Python, FFmpeg, памяти и команды установки. На системном Python с управляемыми пакетами безопаснее использовать виртуальное окружение, а не ставить зависимости в основную систему. На слабой машине обработка займёт время; я бы сначала проверил один файл, прежде чем строить поток из десятков записей.
Локально не значит автоматически приватно во всей цепочке. После расшифровки текст легко по привычке вставить в облачный чат для резюме и тем самым отправить туда всё содержимое разговора. Проверь маршрут данных от исходного аудио до окончательной заметки и доступ к папке, где остаются промежуточные файлы. Удали лишние копии по принятой у тебя политике хранения, а оригинал держи до финальной проверки.
Как убрать постоянный шум и не испортить речь
Если в записи ровный гул вентилятора или шипение, можно обойтись без облачной нейросети. Руководство Audacity по Noise Reduction предлагает сначала выделить кусочек, где слышен только шум, и получить профиль помехи. Потом выделить нужную область целиком, открыть Effect > Noise Removal and Repair > Noise Reduction, послушать Preview и осторожно применить эффект.
Здесь есть важный подвох. Если захватить в профиль не только шум, но и тихий слог человека, фильтр будет считать часть голоса помехой. Audacity советует слушать режим Residue: он показывает, что будет вырезано. Слышишь в остатке узнаваемые слова - ослабь подавление или чувствительность. Я бы оставил немного фонового шороха, чем получил «металлический» голос с пропавшими окончаниями.
Этот эффект рассчитан на относительно постоянный шум. Стук посуды, внезапный автомобиль, перебивания и смех аудитории так не исправить. Audacity отдельно предупреждает: при переменной помехе или когда голос ненамного громче шума результат может сильно исказиться. В таких местах лучше сохранить проблемный фрагмент как есть или вырезать паузу вручную, если это допустимо для твоей задачи. Чистить «до нуля» любой ценой не нужно.
Что проверять в готовой расшифровке
Автоматический текст удобен для поиска и подготовки черновика. Для публикации его надо редакторски проверить. Особенно имена, числа, адреса, аббревиатуры и отрицания. Последние опаснее опечатки: «согласовали» и «не согласовали» могут выглядеть в гладкой стенограмме одинаково убедительно, но означают противоположное. Оставь маркеры неуверенности и вернись к оригинальной дорожке.
Мой порядок такой: сначала пробегаю текст целиком, затем слушаю фрагменты с решениями, суммами и необычными терминами. Если разговор предполагает протокол встречи, прошу участника подтвердить итоговые решения отдельно. Распознавание звука не знает, была ли реплика шуткой, условием или окончательным согласием. Подробнее о формате протокола и различии между записью и договорённостью есть статья про ИИ для встреч.
Когда нужен текст для субтитров, проверь ещё стыки фрагментов и начало реплик. Разделение большого файла на части способно потерять контекст на границе. Если нужна дословная цитата, не полагайся на красивую пунктуацию, которую дописал сервис. Открой соответствующий участок звука и запиши то, что действительно произнесли. Для аналитического отчёта можно пометить пересказ как пересказ, а цитату оставить только там, где она проверена.
Выбор инструмента под рабочую задачу
Для редкого короткого интервью чаще хватает одного сервиса файловой расшифровки и ручной проверки. Для регулярных больших объёмов важнее воспроизводимый маршрут: разрешения на запись, единый формат файлов, разметка ошибок, место хранения текста и способ вернуться к оригиналу. Сначала организуй этот маршрут, потом автоматизируй загрузку. Смена модели не исправит перепутанные права доступа и потерянный исходник.
Если задача - получить чистую дорожку для публикации, сначала пробуй профильное редактирование звука на копии. Если задача - найти цитаты, начни с распознавания и проверки спорных мест. Нужны оба результата - веди процессы параллельно от одного оригинала, не делай расшифровку из уже агрессивно испорченной шумодавом версии, если исходная речь различима. Тест на коротком проблемном куске покажет больше, чем рекламное обещание «идеальный звук одной кнопкой».
Я бы фиксировал для каждого файла три вещи: исходную запись, проверенный текст и список неразборчивых мест. Такой набор полезен и редактору, и тому, кто будет переслушивать разговор через месяц. Чем важнее последствия ошибки, тем меньше смысла экономить минуты на финальной сверке.