29 октября 2026 г.
ИИ-агенты ломают общую тестовую базу: как разделить их в CI

Если несколько ИИ-агентов меняют один проект параллельно, отдельных Git-веток мало: тесты могут писать в общую базу и портить результаты друг другу. Рабочий выход - дать каждой задаче свою временную базу с одинаковыми исходными данными, а объединённый код проверить на новой базе. Microsoft показала такой процесс с эмулятором Azure Cosmos DB. Начни с двух задач и теста изоляции.
Мне понравилось, что в разборе команды Cosmos DB от 28 октября проверяют довольно скучную вещь: что происходит с одним и тем же документом, когда соседние задачи одновременно пишут в базу. Скучную ровно до момента, когда твой агент говорит «всё зелёное», а другой только что сбросил ему тестовые данные. Здесь есть готовый репозиторий, команды и честные границы демо.
Что именно показала Microsoft
FleetCharge - небольшое Python-приложение для управления зарядкой и отправкой машин. Приложение хранит данные в Cosmos DB; в демонстрации вместо облачного аккаунта используется локальный эмулятор. Для проверки самого приложения авторы отдельно используют Ollama и локальную модель. В новом опыте правки кода делает GitHub Copilot. Не стоит путать эти две роли: Ollama не управляет агентами, которые редактируют код.
Разработчики собрали три проверки. Первая ставит два экземпляра базы и пробует записать конфликтующие данные. Вторая гоняет отдельные задачи через GitHub Actions. Третья запускает несколько рабочих деревьев Git, проверяет их правки и объединяет результат в ещё одном дереве с новой базой. В описании прогона есть отдельный режим с настоящими coding-агентами и режим с детерминированными заглушками. Обычный CI на pull request не вызывает Copilot вместо тебя.
Смысл тут не в том, что Microsoft «научила базы ветвиться как Git». Каждая задача получает независимый экземпляр эмулятора, куда заново загружаются заранее сохранённые тестовые данные. После работы экземпляр удаляют. Ветки данных обратно не сливаются: сливается только код, затем тестируется его объединённая версия. Разница тонкая, но на ней держится вся схема.
Почему отдельной Git-ветки недостаточно
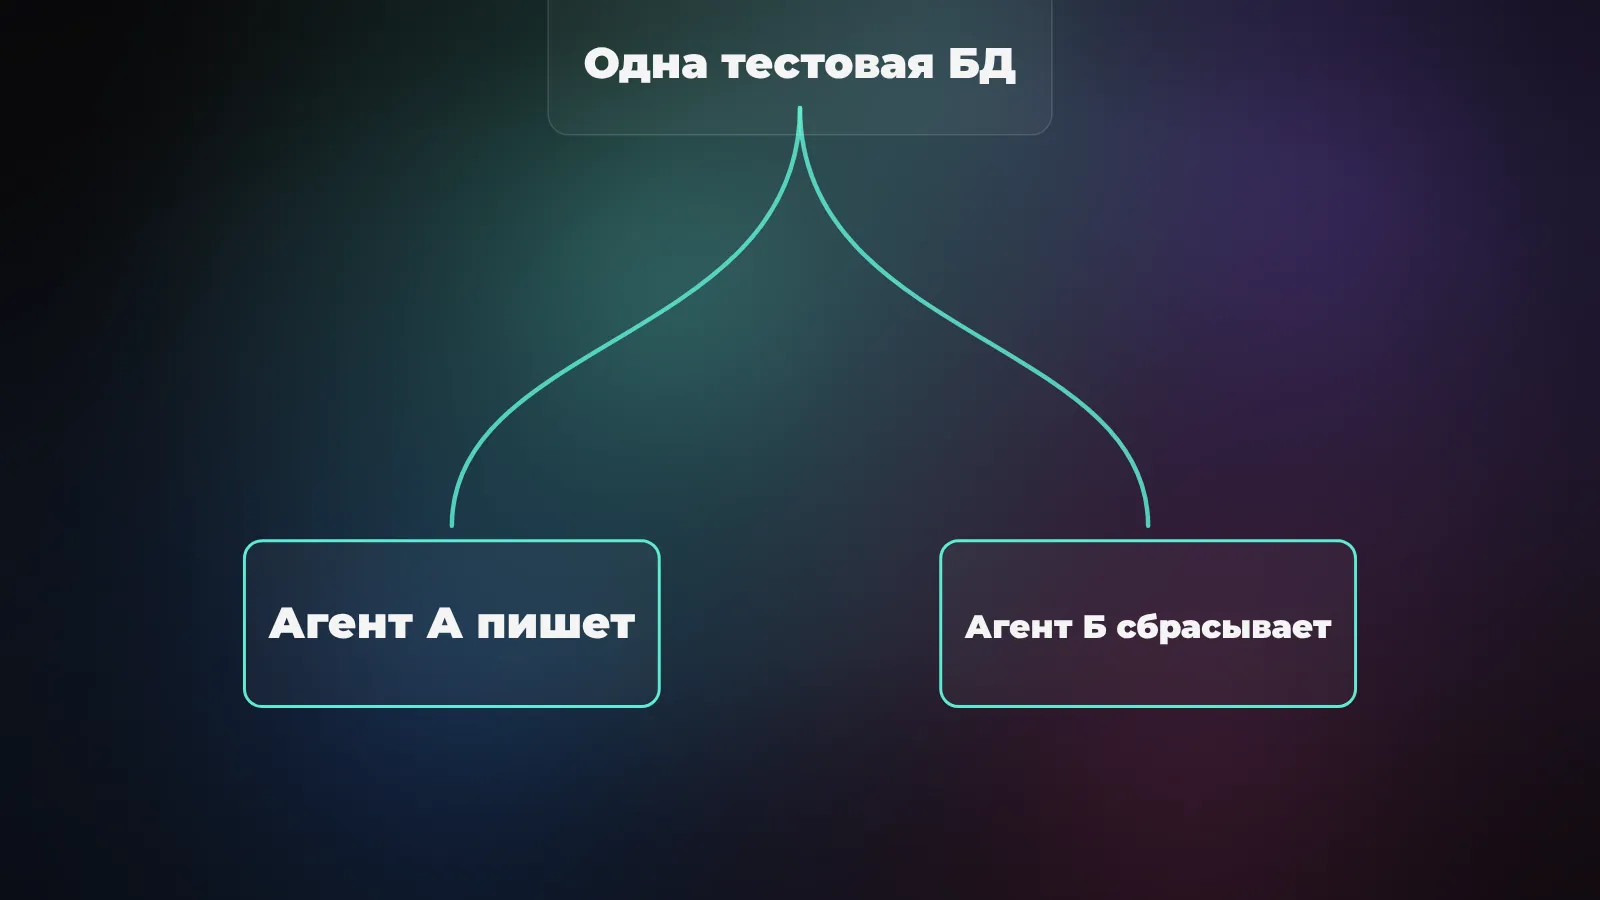
Git worktree даёт каждой ветке собственный каталог файлов. Это хорошо: один агент не перезапишет черновик другого в общей рабочей директории. Но адрес базы обычно лежит в настройках приложения. Если оба каталога подключены к одному тестовому серверу, разделились лишь файлы. Запись, очистка и повторное заполнение базы остаются общими.
Представь тест на изменение места получения груза. Агент А записал новое место и собирается его прочитать обратно. В эту секунду агент Б очистил фикстуры и заново создал исходную запись. Первый тест упал, хотя правка А могла быть верной. Бывает и хуже: оба теста случайно стали зелёными, потому что один проверил данные соседа. Если запускать их по очереди, гонка исчезает, но параллельной работы уже нет.
В старой статье я разбирал, почему несколько агентов мешают друг другу при работе с общим состоянием. Здесь предмет уже: конкретная проверка границы между задачами. Для каждого запуска нужны свой каталог кода, свой адрес базы, свои результаты тестов и право удалять только созданные им ресурсы. Даже отдельная база внутри одного эмулятора может подойти для небольшого стенда; отдельные контейнеры дают ещё и независимый срок жизни экземпляров.
Как проверить, что данные действительно разделились
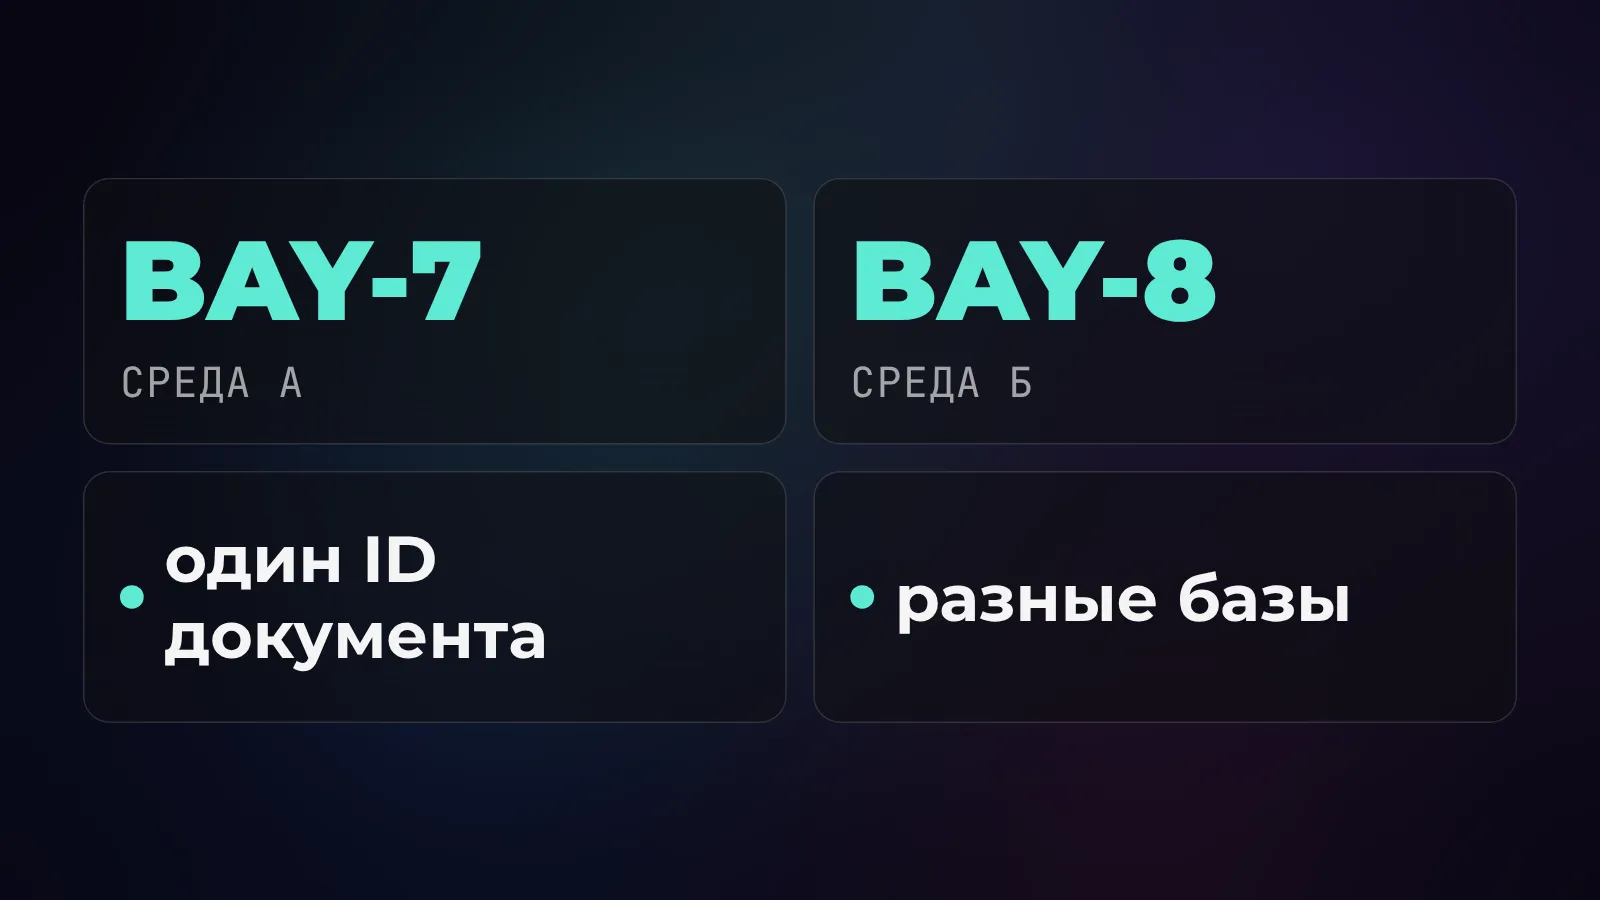
Вместо абстрактного «кажется, они независимы» Microsoft положила в оба эмулятора запись с одинаковыми идентификаторами базы, контейнера, документа и ключа раздела. Исходное место получения для обеих задач - BAY-2. Задача А меняет его на BAY-7, задача Б - на BAY-8. После одновременных записей каждый клиент снова читает свой документ по идентификатору current-dispatch и ключу SEA-01. Протокол теста описан пошагово.
Если бы авторы дали задачам разные ID, положительный результат можно было бы объяснить тем, что они просто не попали в одну запись. Здесь идентификаторы одинаковы намеренно: отличаются адреса самих экземпляров. После чтения результатов удаляется среда А, и новый клиент ещё раз читает Б. Она обязана работать дальше и хранить своё значение. В конце удаляются оба контейнера, но только принадлежащие этому запуску. Проверяется не лишь запись, но и уборка.
Заодно авторы устроили отрицательный контроль: два исполнителя пишут в один общий эмулятор, и тест ожидает потерю одной из записей. Это демонстрирует, зачем нужны две среды, а не просто успешный тест с пустыми базами. Отрицательный контроль использует заглушки даже тогда, когда изолированные задачи работают с настоящим Copilot. Он показывает конфликт состояния, а не способность модели писать код.
Как попробовать на своём компьютере
Минимальный опыт можно провести без оплаченного Copilot и без запуска модели. Нужны исходники FleetCharge, Python 3.12, uv и Docker с Linux-контейнерами на x86-64 Windows или Linux. Для двух эмуляторов понадобится запас оперативной памяти и процессорного времени. Из корня репозитория Microsoft предлагает команду:
uv run --locked --extra test python -m scripts.agent_isolation
Она поднимает оба эмулятора, ждёт готовности, загружает фикстуры, проводит записи и чтения, затем удаляет свои контейнеры. Docker выдаёт раздельные порты на 127.0.0.1, поэтому две базы не конкурируют за один порт хоста. Автор специально указывает: контейнеры запускаются последовательно, параллельны уже заполнение и конкурирующие записи. Команда не запускает Copilot и не делает вызов к модели.
Я не выдаю этот сценарий за лично прогнанный: в ходе подготовки статьи не запускал Docker-эмулятор. Здесь полезно повторить именно тест границы, а не полагаться на скриншот чужого зелёного CI. Сохрани отчёт о двух прочитанных значениях и проверь, что после завершения не остались чужие контейнеры. Дай скрипту удалять только то, что создал его собственный запуск.
Как перенести проверку в CI
В workflow проекта настроена матрица двух типов задач. GitHub Actions запускает каждую в отдельном job на собственном runner, внутри появляется один эмулятор с отдельным адресом. fail-fast: false даёт соседней задаче закончить проверку, даже если первая упала. Артефакты сохраняются и при ошибке: иначе команда видела бы только красную галочку без причины. Как работает матрица в целом, отдельно объясняет справка GitHub.
Одних узких проверок по задачам недостаточно. Изменения кода нужно соединить и прогнать общие тесты на свежем экземпляре базы. Две независимые ветки могут по отдельности проходить тесты и всё равно конфликтовать при слиянии. Автоматическое разрешение текстового конфликта тоже не доказывает, что сохранился смысл обеих правок. Поэтому после объединения остаются просмотр диффа человеком и полный тест затронутого приложения.
Если задача всего одна и тесты занимают секунды, отдельный эмулятор под каждого агента окажется лишней инфраструктурой. Начни с одного повторяемого тестового набора. Затем проверь два параллельных запуска на одинаковых ID; только после первого воспроизведённого конфликта добавляй матрицу и автоматическую уборку. Не забудь ограничить время жизни задач: иначе забытые контейнеры будут жечь память и минуты CI, даже если тестовый код уже никому не нужен.
Что этот опыт доказывает, а что остаётся тебе
В публичном запуске GitHub Actions job с настоящим Copilot завершился успешно. По отчёту авторов отдельные задачи прошли 18, 18 и 57 проверок; наборы частично пересекаются, складывать их в общую оценку нельзя. Объединённая версия прошла 75 тестов на новом эмуляторе. Это результат конкретного демо, а не обещание, что твои агенты станут писать без ошибок.
У демонстрации есть и стоимостная граница: ручной режим настоящих агентов требует включённой оплаты Copilot в организации; обычная проверка изоляции его не требует. Числа бюджета в статье Microsoft - конфигурационный потолок опыта, а не фиксированная цена запуска. Сам эмулятор не превращает код в production-приложение: README прямо называет пример облачного CD демонстрационным, с отключённым деплоем. Для реального Azure надо отдельно настроить базу, модель, права и секреты.
А если отдельные контейнеры слишком тяжелы, стоит рассмотреть базу на задачу внутри общего тестового сервера. Только не подменяй этим контроль владения: удаление одной базы не должно затронуть другую. ETag и условная запись Cosmos DB помогают заметить конфликт при изменении одного документа, но они не спасут соседний тест от команды «очистить всю тестовую базу». Выбирай размер изоляции по реальной поверхности риска.
Мой вывод простой: параллельный агентный CI начинается с адреса тестовой базы и правила уборки, а не с числа запущенных моделей. Сначала докажи, что А может записать своё значение, Б - другое, а удаление А оставляет Б живой. Потом проверяй объединённый код. Без этих двух условий красивый «рой» легко превращается в генератор ложных зелёных тестов.
Источники
- Microsoft: Agentic CI/CD с изолированными средами Cosmos DB
- Репозиторий FleetCharge и код демонстрации
- Workflow Agent task CI
- Публичный запуск проверок GitHub Actions
- GitHub Docs: матрицы задач
- Git: рабочие деревья
- Microsoft Learn: ограничения эмулятора Cosmos DB
- Microsoft Learn: конкурентные записи и ETag