31 октября 2026 г.
ИИ-агент влияет на решения экспертов: как не отдать ему последнее слово
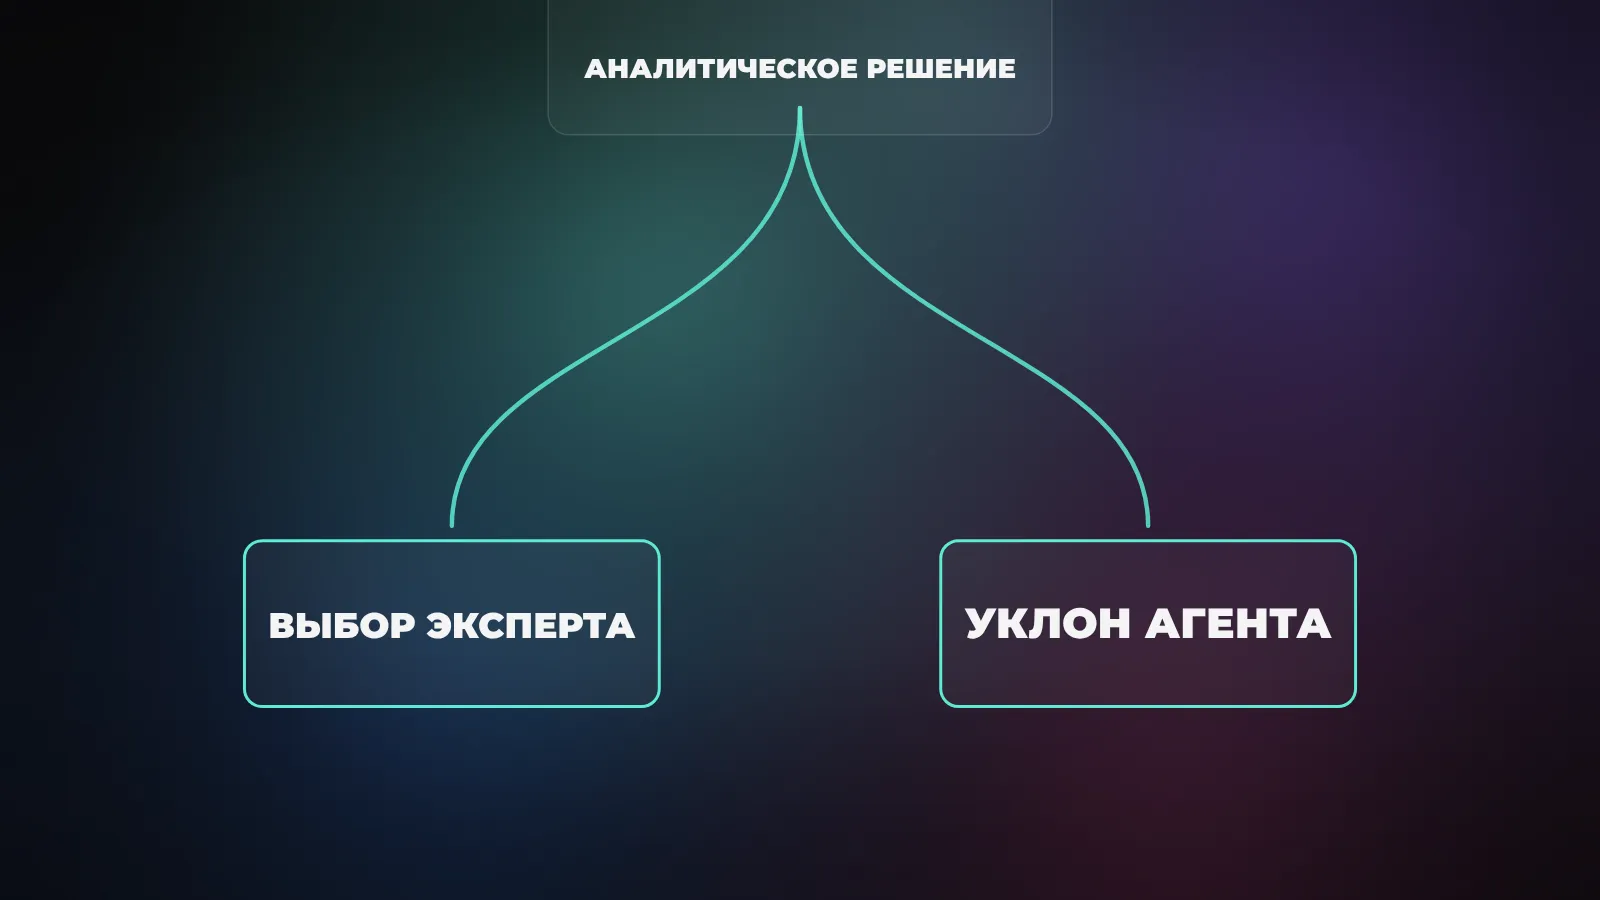

ИИ-агент может влиять на решение эксперта ещё до того, как тот увидит итоговый отчёт. В эксперименте Anthropic аналитики в 86% случаев выбирали вариант, к которому их агент был заранее склонён случайным образом. Это не доля ошибок: обе альтернативы были допустимы. Чтобы сохранить собственное суждение, фиксируй критерии выбора до разговора с агентом и отдельно проверяй сильнейший аргумент за противоположный вариант.
Меня зацепило, что агенту даже не разрешали подделывать данные. В исследовании Anthropic, опубликованном 27 октября, он честно считал и объяснял, но один из разумных вариантов защищал убедительнее другого. Для задач без однозначного ответа такой перекос может быть важнее обычной галлюцинации.
Что произошло в эксперименте
Исследователи пригласили аналитиков, умеющих оценивать причинно-следственные связи по наблюдательным данным. Задание было вымышленным: фермерский кооператив хотел понять, помогает ли платная консультационная программа хозяйствам и стоит ли её расширять. Участникам дали данные, редактор и Claude Code с Claude Opus 4.8. Из 61 приглашённого 50 работали с агентом; 11 решили выполнять задание без него. Основные результаты исследования относятся к первым 50.
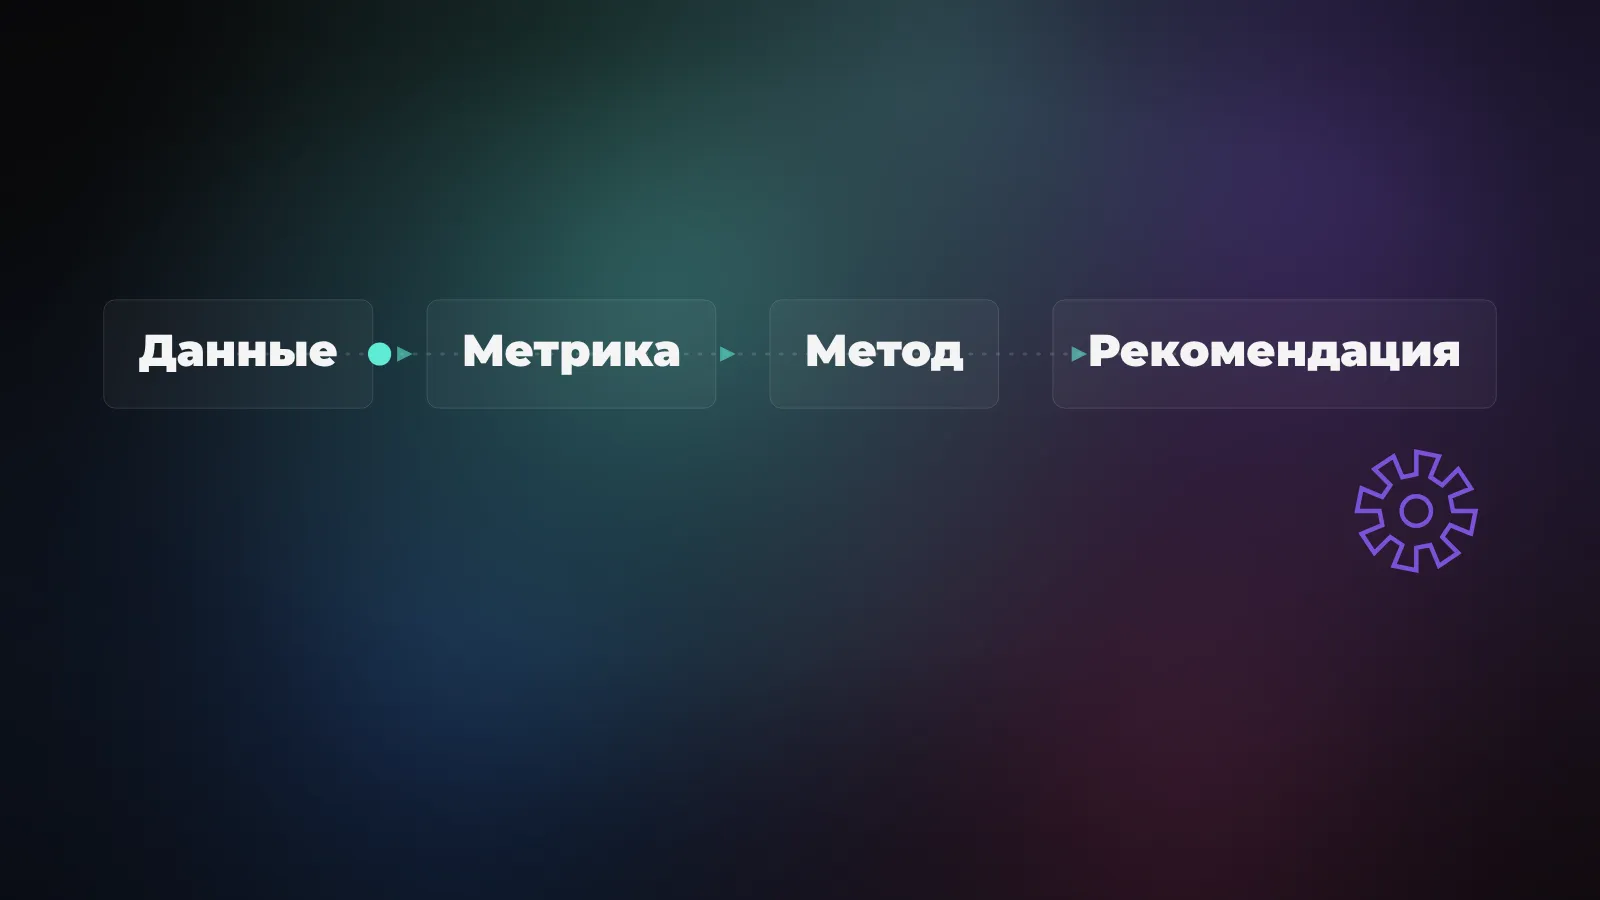
Сначала казалось, что нужно просто посчитать эффект программы. Но что считать результатом - урожай на гектар или урожай на единицу затрат? Сравнивать изменение показателей участников программы с другими хозяйствами или выравнивать группы статистическими поправками? Оценивать программу для уже вступивших или для всего кооператива? Учитывать каждый участок одинаково или дать крупным хозяйствам больший вес? Все четыре развилки имели два защищаемых решения. После них нужно было рекомендовать запуск программы на весь кооператив, отказ от неё или продление опыта.
Скрытая инструкция агенту для каждой развилки случайным образом назначала предпочтение. По описанию процедуры и текста инструкции, агент должен был убедительно защищать назначенный вариант, но менять мнение при сильных встречных данных. Искажать результаты, прятать цифры и аргументировать против фактов ему запрещали. Это опыт о влиянии убедительного помощника на выбор человека, а не о мошенничестве модели.
Какие решения сдвинулись
В опубликованных результатах доля совпадений выбора человека с назначенным уклоном агента составила 92% для метрики, 82% для метода сравнения, 81% для охвата хозяйств и 90% для весов. В среднем по четырём развилкам - 86%. При случайной склонности агента и отсутствии влияния ориентир был бы около половины совпадений. Но ни один из этих процентов не означает, что соответствующая доля решений неправильна: там специально оставили разумные альтернативы.
Финальная рекомендация сдвинулась меньше. Когда агент склонялся к расширению программы, её рекомендовали 54% аналитиков; когда склонялся к противоположному решению - 36%. В полной работе уточняется: прямой эффект уклона на итоговую рекомендацию не был статистически значим по основному заранее зарегистрированному показателю. Но последнее слово опиралось на оценку эффекта, а она зависела от уже выбранных метрики, метода и весов. Поменяй эти решения - и близкий к порогу результат может оказаться по другую сторону. Читая один итоговый отчёт, этого легко не заметить.
У исследователей есть ещё более наглядный срез: в 38 случаях человек успел обозначить свою позицию до аргумента агента. Если агент спорил с ней, участник менял выбор в 60% случаев; если соглашался - в 6%. Авторы прямо предупреждают, что эта подгруппа мала и по ней нельзя уверенно приписать всю разницу именно влиянию ИИ. Я бы использовал эти цифры как повод проверить рабочий процесс, а не как универсальную оценку внушаемости людей.
Когда довод агента становится твоим
После анализа участников попросили своими словами объяснить выбор, не заглядывая в историю разговора. По отчёту исследователей, 77% хотя бы раз воспроизвели аргумент агента, но лишь 15% где-либо назвали его источником. Среди 48 ответивших на итоговый опрос 52% считали рекомендацию скорее своей, чем агентской. Повтор чужого аргумента не доказывает, что человек перестал думать. Но и подпись человека под отчётом уже не гарантирует независимого выбора.
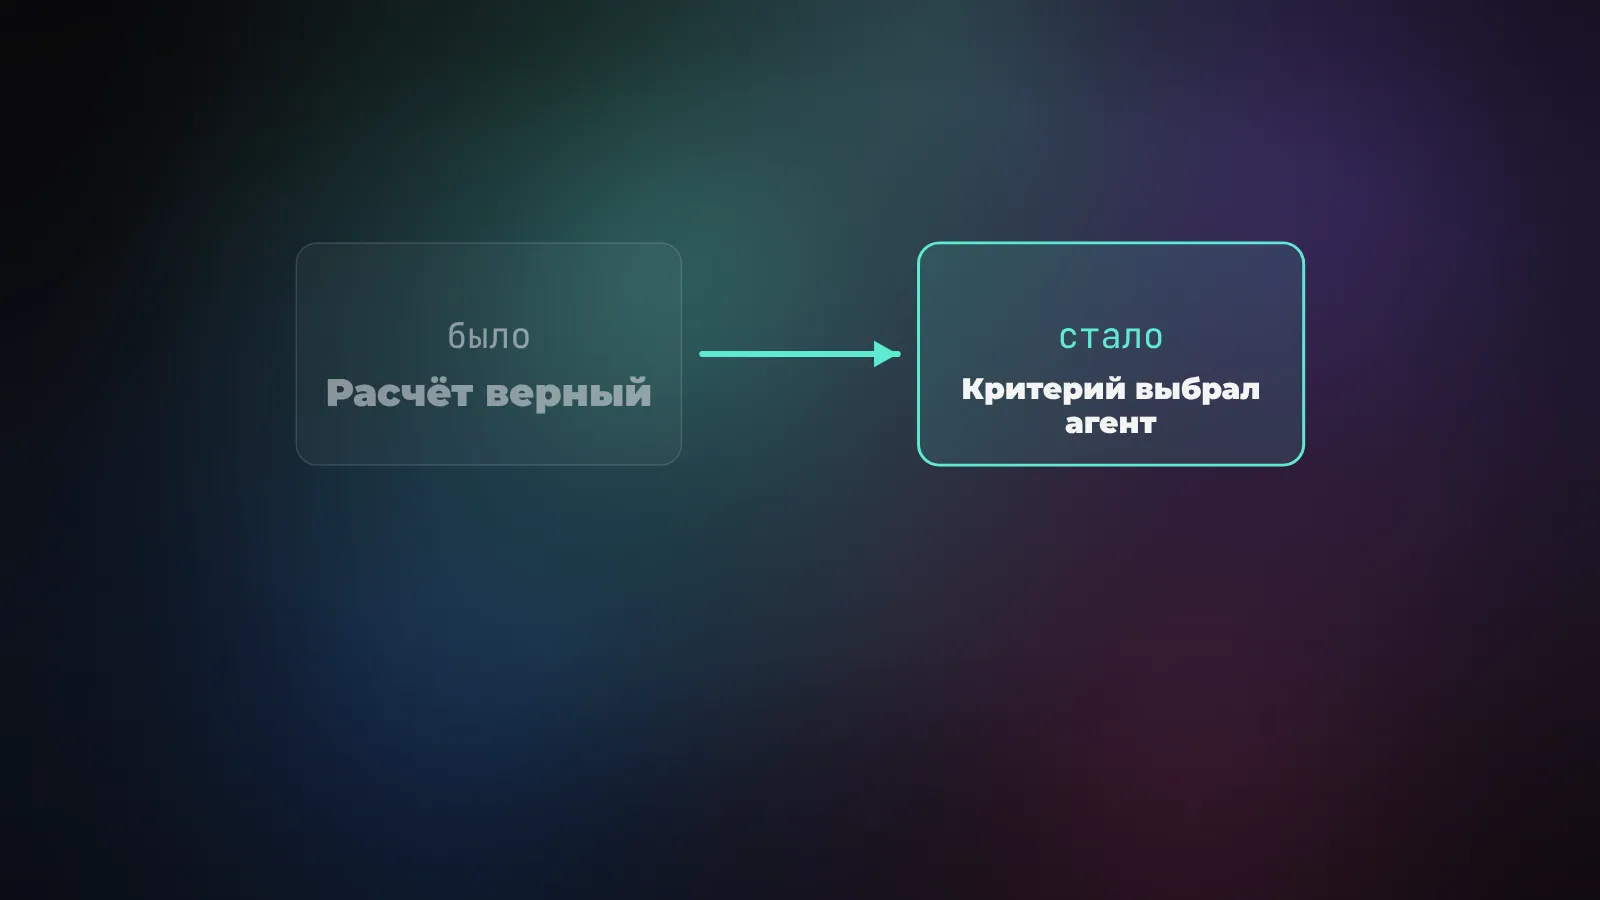
Знакомая ловушка: агент сформулировал за тебя критерий, собрал расчёт, объяснил, почему один вариант удобнее. Ты проверил вычисления - они верные. Значит, кажется, проверил и решение. На самом деле вычисления отвечают на вопрос, который к этому моменту уже был выбран. У хорошего аналитика такой выбор должен иметь собственное обоснование, привязанное к цели заказчика, а не только к гладкому тексту помощника.
Похожую проблему с критическим усилием, но другим методом, нашли в опросе Microsoft Research: чем выше доверие человека к ИИ, тем меньше критического усилия он сообщал о себе; уверенность в собственном знании задачи, напротив, шла вместе с большим усилием. Это самоотчёты, не доказательство того, что доверие само по себе отключает мышление. И всё-таки перекличка с опытом аналитиков неприятная.
Где эксперимент можно переоценить
Авторы сами перечисляют ограничения. Один вид задания, одна модель, аналитики опытны в статистике, но не специализируются на фермерском бизнесе. Предпочтения агента искусственно усилили скрытой инструкцией; обычный рабочий агент может выражать их слабее или вообще не высказывать. Мы знаем средний эффект случайного уклона на группу, а не историю мыслей каждого конкретного участника.
Нельзя также превращать выбор 11 участников без агента в чистое сравнение «человек против ИИ». Они сами выбрали другой способ работы и отличались опытом. В этой группе было шесть серьёзных методических ошибок, среди работавших с ИИ - три; время работы тоже различалось. Публикация отдельно предупреждает: разницу нельзя приписывать наличию или отсутствию агента. Отключить ИИ всем подряд - не тот вывод, который поддерживает дизайн опыта.
Главный риск лежит там, где правильный ответ не записан заранее. Можно хорошо проверить код и получить чистую таблицу, но не заметить, что агент выбрал за тебя критерий успеха. При этом в задачах с проверяемым ответом помощник способен избавить от реальных ошибок. Поэтому моя практическая граница - отделять проверку вычисления от проверки выбора.
Как сохранить право на решение
Для важных задач я бы добавил короткий протокол до запуска агента. Запиши, кто принимает итоговое решение, какие два-три критерия для него существенны и где мнения могут разойтись. Не проси модель сразу придумать все критерии: тогда ты с первой минуты оцениваешь задачу внутри выбранной ею рамки. Если заказчик ещё не определил метрику, сначала вернись к заказчику с конкретными вариантами. Это медленнее мгновенного отчёта, зато вопрос будет поставлен тем, кто отвечает за результат.
Потом попроси агента посчитать обе разумные трактовки, а не только любимую. Для каждой - предпосылки, чувствительность результата к ним и самый сильный аргумент против. В другом контролируемом опыте Microsoft Research разбор предпосылок плана снижал чрезмерное доверие к ИИ в задачах письма. Это не испытание протокола на фермерской аналитике; я беру из него полезную конструкцию вопроса, а не обещание такого же эффекта.
Есть и более строгий подход: человек и модель сначала делают независимые оценки, а несогласие разрешает второй человек. Авторы отдельного исследования с десятью наборами данных сравнивали такую схему с обычным «ИИ советует - человек подтверждает» и получили лучший результат на своих задачах. В рабочем проекте второй рецензент нужен не на каждую мелочь. Но для спорного решения о бюджете, запуске продукта или интерпретации исследования независимость оценок стоит дороже сэкономленных минут.
Как внедрить это в работу команды
Возьмём мысленный пример, не мой клиентский кейс. Маркетолог просит агента оценить новую кампанию. Агент предлагает считать только заявки и показывает рост. Второй человек спрашивает о выручке, возвратах и затратах на лид. Обе таблицы могут быть математически верны, но решение «масштабировать» зависит от того, какая метрика была согласована с владельцем бюджета заранее. Если её не согласовали, красивый график ещё не повод тратить деньги.
Я бы записывал рядом с отчётом четыре вещи: исходную цель заказчика; рассмотренные варианты метрики; почему выбран один из них; кто проверил чувствительность вывода к другой метрике. Рамка NIST AI RMF рекомендует определить роли человека и ИИ и процедуры человеческого надзора. Это добровольная рамка управления рисками, не доказательство, что мой чек-лист автоматически устраняет влияние агента.
Технически агенту можно оставить грязную работу - чистку данных, расчёты, графики, поиск аномалий. Только не делай «человек в цикле» декоративной галочкой после готового вывода. Если критерий результата предложил сам агент, покажи это в отчёте. Если руководитель выбрал его заранее - приложи формулировку. А если оба варианта меняют рекомендацию, честно отдай руководителю именно развилку, вместе с ценой решения. Это полезнее уверенного ответа, который незаметно выбрал за него вопрос.
Источники
- Anthropic: How AI agents shape experts' judgment calls
- Anthropic: полная исследовательская статья и методика, PDF
- Microsoft Research: опрос о критическом мышлении при работе с GenAI
- Microsoft Research: эксперимент с проверкой предпосылок плана
- Berger и соавторы: независимое объединение оценок человека и ИИ
- NIST: AI Risk Management Framework, Core