19 октября 2026 г.
Harness²: как ИИ улучшает собственную обвязку без переобучения

Harness² - открытый исследовательский проект, который улучшает обвязку ИИ-агента: инструкции, память, подсказки для инструментов и другие файлы вокруг неизменной модели. Он пробует несколько вариантов на задаче, сравнивает следы работы и сохраняет выводы для следующих задач. Начать можно с локального демо без ключей; обещание «агент сам станет умнее» пока проверяй только на своих задачах и с ограниченными правами.
Если ты когда-нибудь переписывал системный промпт после неудачного запуска, принцип знаком. Только здесь правки предлагает отдельный контур, запускает пробные версии и анализирует, что произошло. Google Research выложила код Harness² вместе с исследовательской работой. Я поставил бесплатное локальное демо и посмотрел, где заканчивается воспроизводимая проверка и начинаются заявления авторов про качество агента.
Что именно меняется, если веса модели те же
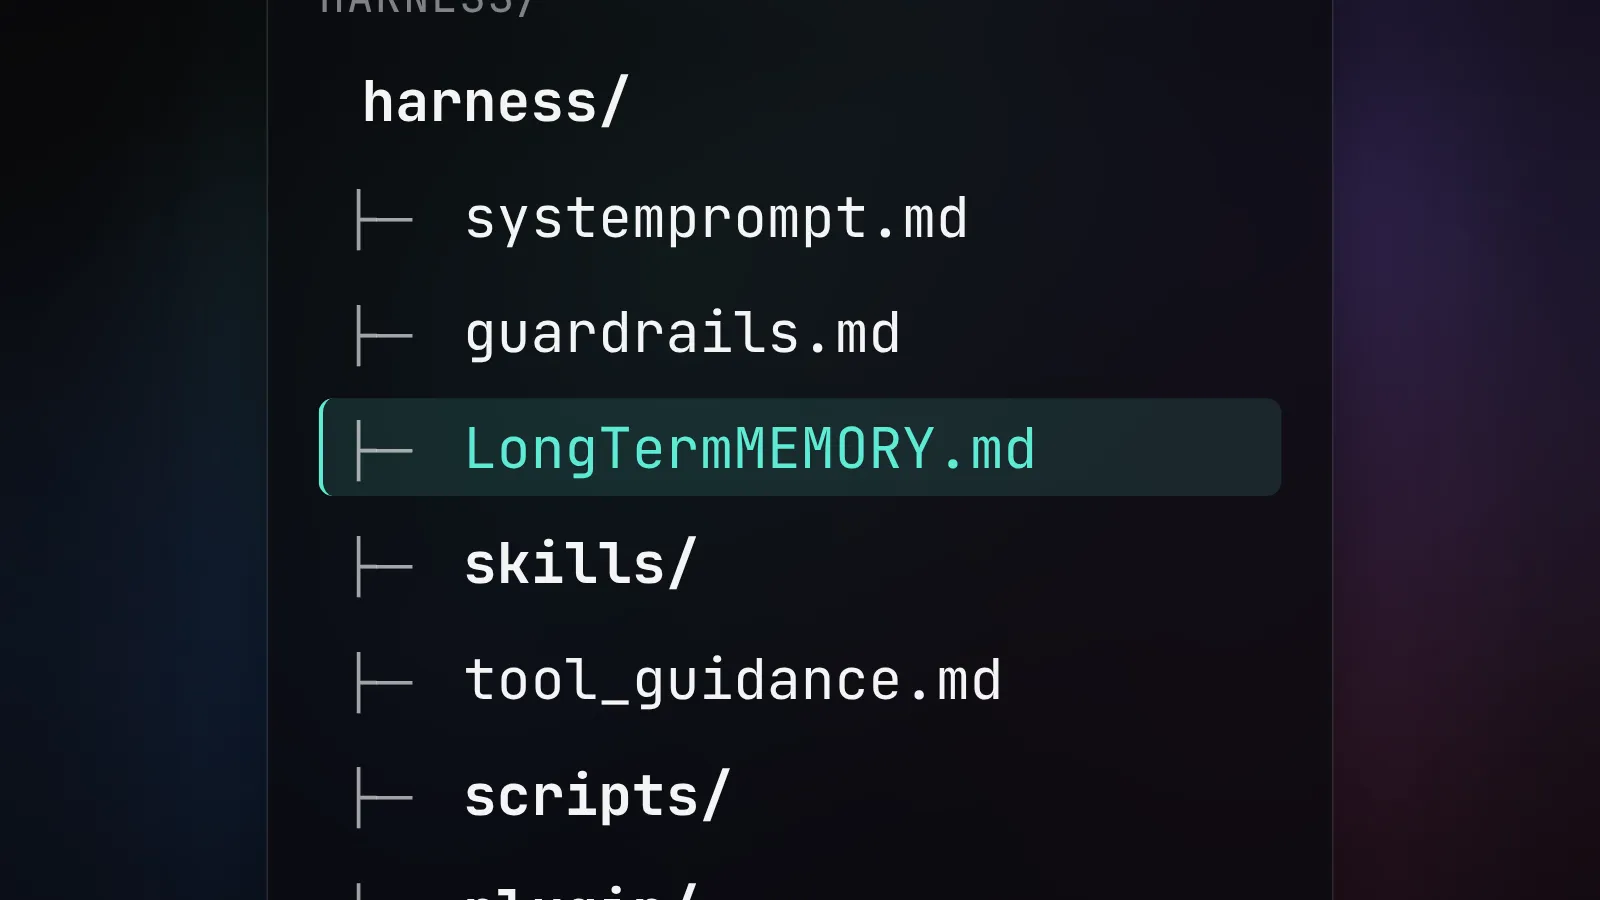
Про обвязку агента я уже писал: одна модель в разных программах получает разные инструменты, правила и рабочую память. У Harness² предметом редактирования становятся конкретные файлы этой обвязки. В опубликованной реализации их восемь: системный промпт, ограничения, память, подсказки к инструментам, субагенты, навыки, скрипты и плагины.
Удобно представить редактор и агента двумя ролями. Исполнитель решает пользовательскую задачу с текущими настройками. Редактор смотрит на результат и предлагает изменить настройки: например, точнее описать инструмент или добавить рабочую процедуру. Затем исполнитель пробует новую версию на той же задаче. Сама нейросеть при этом не дообучается, её параметры остаются прежними.
Это важное отличие от заголовка «ИИ улучшил себя». Здесь программа правит свои рабочие инструкции и окружение. Если после изменения агент перестал путать порядок шагов, результат похож на улучшение модели глазами пользователя. Но считать, что модель приобрела новый навык навсегда, нельзя. Правка действует там, где загружена соответствующая обвязка.
Есть и другой путь, о котором легко забыть: можно вообще не писать автооптимизатор, а вручную исправить пару плохих инструкций. Для редких задач это дешевле. Harness² интересен, когда задач много, изменения повторяются и хочется накопить проверенные правила, а не каждый раз начинать разбор с чистого листа.
Цикл Propose, Probe, Compose без магического «оценщика»
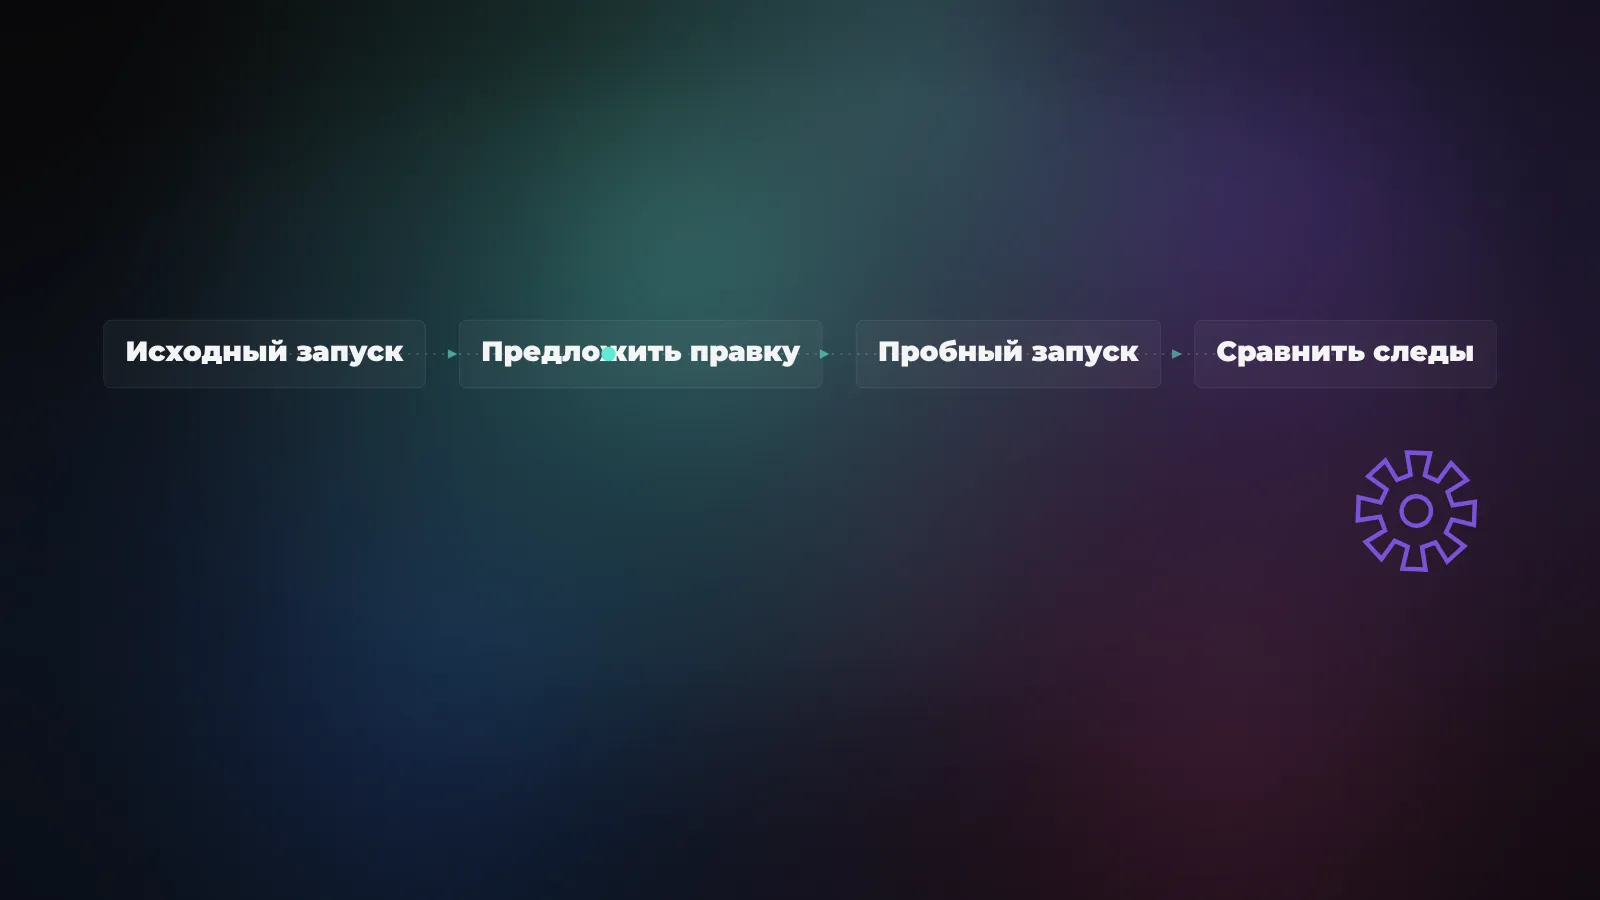
Авторы называют центральный шаг Propose-Probe-Compose. Сначала редактор предлагает кандидатов на изменение файлов. Потом система запускает их на текущей задаче и получает след выполнения: действия, промежуточные наблюдения и готовый артефакт. Наконец, она сопоставляет разные варианты и собирает обновлённую обвязку из правок, за которыми виден полезный эффект.
Здесь нет обещания узнать «правильный ответ» по каждому новому запросу. Для рабочих задач его часто просто нет. Система сравнивает поведение в близких условиях: выполнил ли агент нужные действия, не застрял ли и что оставил на выходе. Это даёт сигнал для следующего шага, но не заменяет независимую проверку результата человеком или отдельным тестом.
У проекта есть два режима. Параллельный исследует несколько кандидатов в одном раунде, последовательный переносит удачную конфигурацию и наблюдения в следующий. Параметр --k задаёт бюджет таких итераций, а не число «уровней интеллекта». Чем больше пробных запусков, тем больше вызовов моделей и расходы. Поэтому на первом опыте нет смысла запускать целый профессиональный бенчмарк.
Второй контур: чему система учится между задачами
После решения задачи Harness² сохраняет принятые изменения и подтверждённые наблюдением уроки в библиотеку по тематике. На следующей задаче редактор видит более ранние записи своей области и получает подсказку, какие правки уже срабатывали. Это второй уровень рекурсии: улучшается порядок подбора обвязки для будущих задач.
По описанию эксперимента, задачи внутри одной области идут по порядку, а разные области можно обрабатывать параллельно. Библиотеки разделены по бенчмарку, исполнителю, режиму и бюджету эксперимента. Это не одна глобальная память, которая волшебно знает, что делать на любой новой работе.
Мне нравится разделение на два результата. Один относится к сегодняшней задаче: изменённая обвязка и выполненная работа. Второй относится к будущему: записанный урок о том, почему конкретная правка помогла. Если просто копировать всю прежнюю настройку в новый проект, можно унаследовать частную хитрость, которая там окажется вредной. Авторы поэтому отдельно говорят о переносе уроков и отборе компонентов.
Это хорошо объясняет, почему результаты тестов нельзя пересказывать как «агент всегда самоулучшается». Новый домен может предъявить совсем другие требования. Даже при совпадающей теме полезность памяти определяется тем, насколько честно она описывает условия прежнего успеха. Спорная правка должна оставаться кандидатом, а не превращаться в правило для всех без проверки.
Как попробовать локальное демо без аккаунта
В репозитории есть демо с детерминированными редакторами и настоящим выполнением Python-кода. Ему не нужны учётная запись модели и API-ключ. Нужны Linux, Python 3.12 и uv. Я проверил его 19 октября 2026 года в отдельном каталоге: установка прошла, команда закончила две тестовые задачи с результатом 2 tasks completed; 0 failed. Это проверяет, что локальный сценарий запускается, но не подтверждает баллы исследования на настоящих моделях.
В пустом временном каталоге склонируй репозиторий, затем из его корня выполни:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
После запуска ищи runs/demo/demo.json: там есть статусы задач и число выполнений. У меня файл показал две завершённые задачи, ноль ошибок, 28 выполнений и 32 вызова детерминированного редактора. Последние числа относятся именно к маленькому демо, не к коммерческой цене API и не к оценке качества на профессиональном наборе.
Чтобы перейти от демо к бенчмарку, потребуется больше подготовки: зависимости самого набора задач, настройка моделей и учётные данные для провайдера. В руководстве по установке описаны Google Cloud CLI и Vertex AI для приведённой авторами конфигурации, а также альтернативный исполнитель Codex через Responses-совместимый мост. Не выдавай четыре команды демо за полноценную установку платного эксперимента.
Что показали тесты и почему я не переношу цифры на свой офис
Авторы работы сравнили исходную и изменённую обвязки на трёх наборах профессиональных задач, в четырёх конфигурациях моделей и исполнителей. После одного шага заявлены приросты до 11,5 пункта на WorkBuddy-Bench, до 4,5 пункта на JobBench и до 11,8 процентного пункта по доле частично выполненных критериев на LAB. Это результаты авторов на выбранных задачах и условиях, а не гарантия для твоего бота.
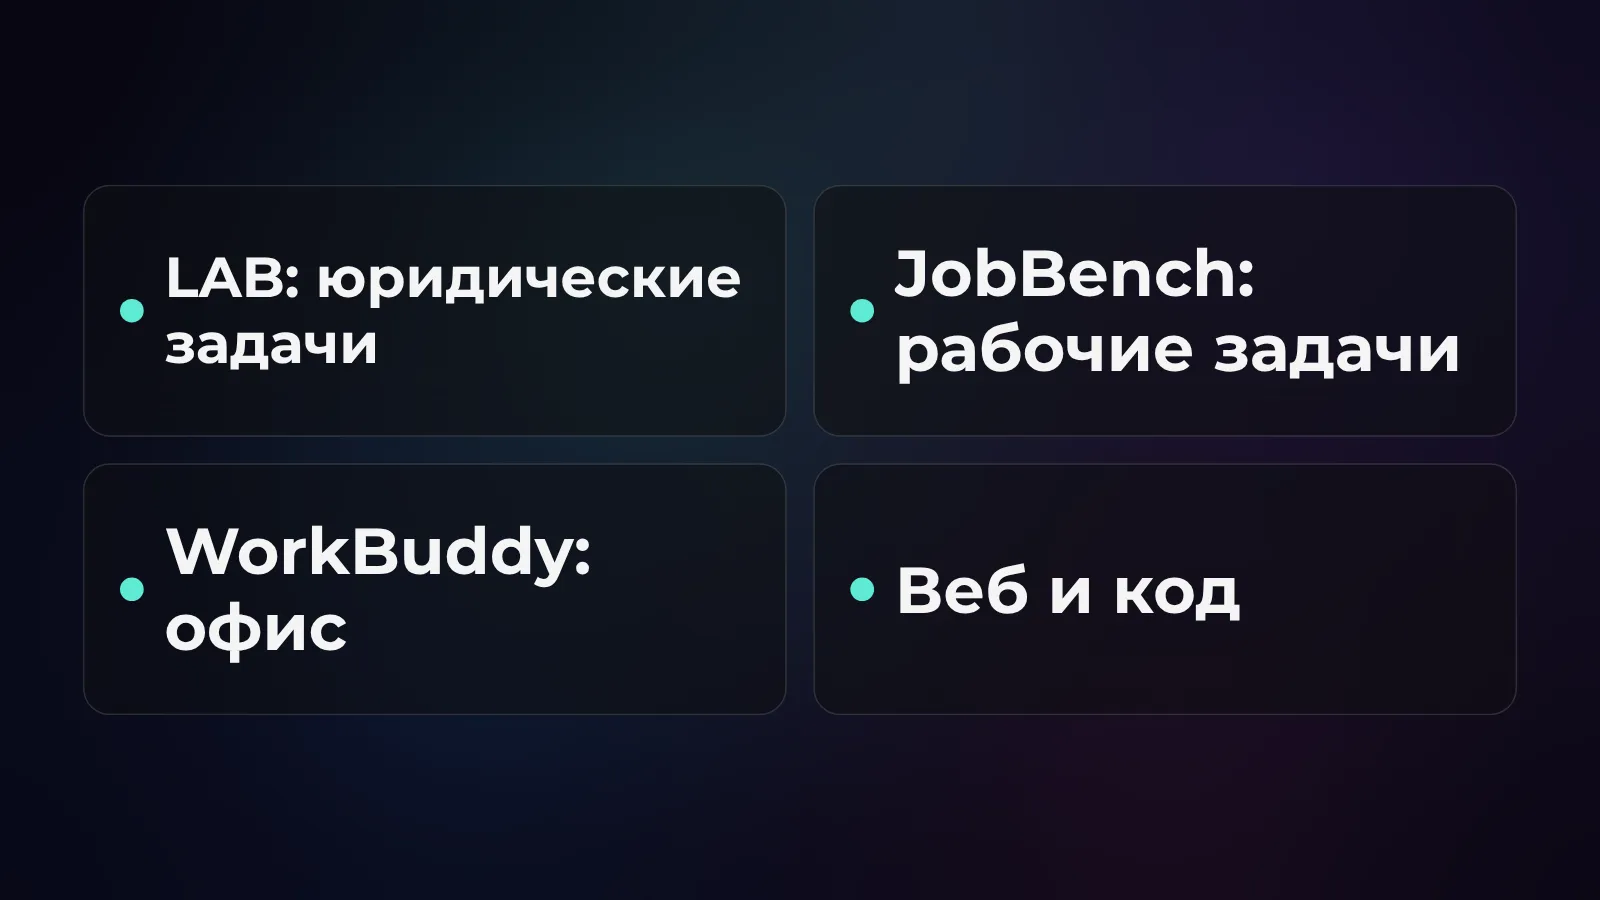
Названия наборов тоже имеют значение. LAB от Harvey проверяет юридическую работу с документами; JobBench даёт профессиональные задачи и собственную систему оценивания; WorkBuddy-Bench от Tencent охватывает офисные, веб- и кодовые сценарии. Результат по одному из них не доказывает, что агент лучше продаёт, безопаснее работает с почтой или аккуратнее публикует контент.
Отдельная ловушка в слове «без правильных ответов». При выборе правки система обходится без эталона для каждой неизвестной задачи. Но оценка результатов исследования всё равно опирается на проверяющие механизмы бенчмарков. Это разные стадии. Можно улучшать обвязку без готового ответа и всё равно потом измерять эффект там, где доступна проверка.
Авторы честно описывают ещё один риск: задания и критерии некоторых публичных бенчмарков доступны в интернете. В экспериментальном гайде сказано, что исполнитель получает свободный сетевой доступ; в одном проверочном запуске Codex сам скачал рубрику задачи. Без сетевого ограничения высокий балл может частично отражать доступ к критериям, а не лучшее решение. Это не повод объявлять все числа недействительными. Это повод проверять условия теста до громких выводов.
Когда брать идею в работу, а когда оставить в песочнице
Я бы пробовал Harness² там, где уже есть повторяемая задача и можно сравнить конкретные артефакты: отчёт с подтверждёнными источниками, исправление с зелёными тестами, документ с проверяемыми полями. Начал бы с копии проекта и небольшой выборки. Потом вручную посмотрел бы, какие файлы менялись, как часто агент повторял задачу и сколько стоили вызовы модели.
В рабочую среду с доступом к оплате, удалению файлов или отправке сообщений такую систему без отдельной границы прав пускать рано. Сам README предупреждает: при использовании Codex в конфигурации проекта песочница исполнителя отключена. Встроенный «улучшатель» редактирует конфигурацию поведения; сам по себе он не даёт ни безопасной изоляции, ни аудита каждого внешнего действия. Правила на уровне инструментов и сети нужны отдельно.
Если ты пришёл сюда из статьи об автоматической оценке Claude Code, разница такая: там мы строим проверки качества своего агента, здесь исследователи предлагают механизм менять его обвязку по результатам проб. Одно без другого слабее. Мне хотелось бы проверять не только финальный ответ, но и цену полученного улучшения: если ради одной удачной правки понадобились десятки прогонов, экономия времени может не случиться.
Мой практический вывод пока приземлённый. Демо действительно запускается без ключей; я это проверил. Утверждение, что Harness² улучшит именно твоего агента, требует своего набора задач, ограничения прав и бюджета. Редактировать обвязку автоматически интересно, но запускать такого редактора на боевых данных до проверки было бы странным решением.
Источники
- Harness²: код, лицензия и инструкция по демо
- Исследование Harness² на arXiv
- Руководство по установке и требованиям
- Режимы рекурсии и оговорка о сетевом доступе
- LAB: первичный репозиторий набора юридических задач
- JobBench: первичный репозиторий оценочного набора
- WorkBuddy-Bench: первичный репозиторий офисных задач