2 октября 2026 г.
Claude Code научился проверять ИИ-агентов: как работают build-eval и hillclimb

В Claude Code появились команды /claude-api build-eval и /claude-api hillclimb: первая помогает собрать проверку твоего ИИ-агента на реальных задачах, вторая по очереди меняет его настройки и сравнивает результат с исходным. Начинать стоит с собственных ошибок агента и ручной проверки оценок. Иначе автоматизация аккуратно улучшит цифру в отчёте, а пользователю лучше не станет.
Я давно хотел кнопку «проверь, стал ли агент полезнее после правки промпта». Но у этой кнопки есть неприятная сторона: кто выбрал проверочные задания и кто решил, что ответ правильный? Новый инструмент Anthropic хорош именно как повод задать эти вопросы до очередного обновления модели.
Что выпустили и где это работает
28 сентября Anthropic описала два сценария в навыке claude-api для Claude Code. build-eval собирает набор задач, правила оценивания и запускает базовый прогон. hillclimb берёт готовый набор и пробует улучшить промпт, описание инструмента, настройки модели или код обвязки. Это команды внутри Claude Code, а не отдельный сайт для загрузки таблицы. В опубликованной инструкции для старта сначала предлагают обновить CLI через claude update, затем вызвать /claude-api build-eval прямо в сессии.
Почему я бы попробовал это на своём агенте? Допустим, он разбирает входящие заявки и выбирает маршрут: продажа, поддержка или человеку. Сегодня ты меняешь описание маршрутов, а завтра ловишь жалобу: заявку на возврат отправил продавцу. Без набора старых ошибок трудно понять, улучшил ли ты систему в целом или только исправил один конкретный случай.
В старом разборе про обвязку агента я объяснял, почему одна модель по-разному работает в разных программах. Здесь вопрос другой: как измерить работу своего приложения на повторяемых задачах, прежде чем крутить эту обвязку дальше.
Что такое eval без страшных слов
Одна задача на входе, один прогон агента и проверка результата - вот минимальная единица оценки. Для маршрутизатора заявок входом служит письмо клиента; результатом - выбранная очередь и запись в системе; проверкой - совпадение очереди с подтверждённым человеком ответом. Повторяешь это на разных письмах после каждой правки. Получается что-то похожее на регрессионный тест, только для поведения системы, а не одной функции.
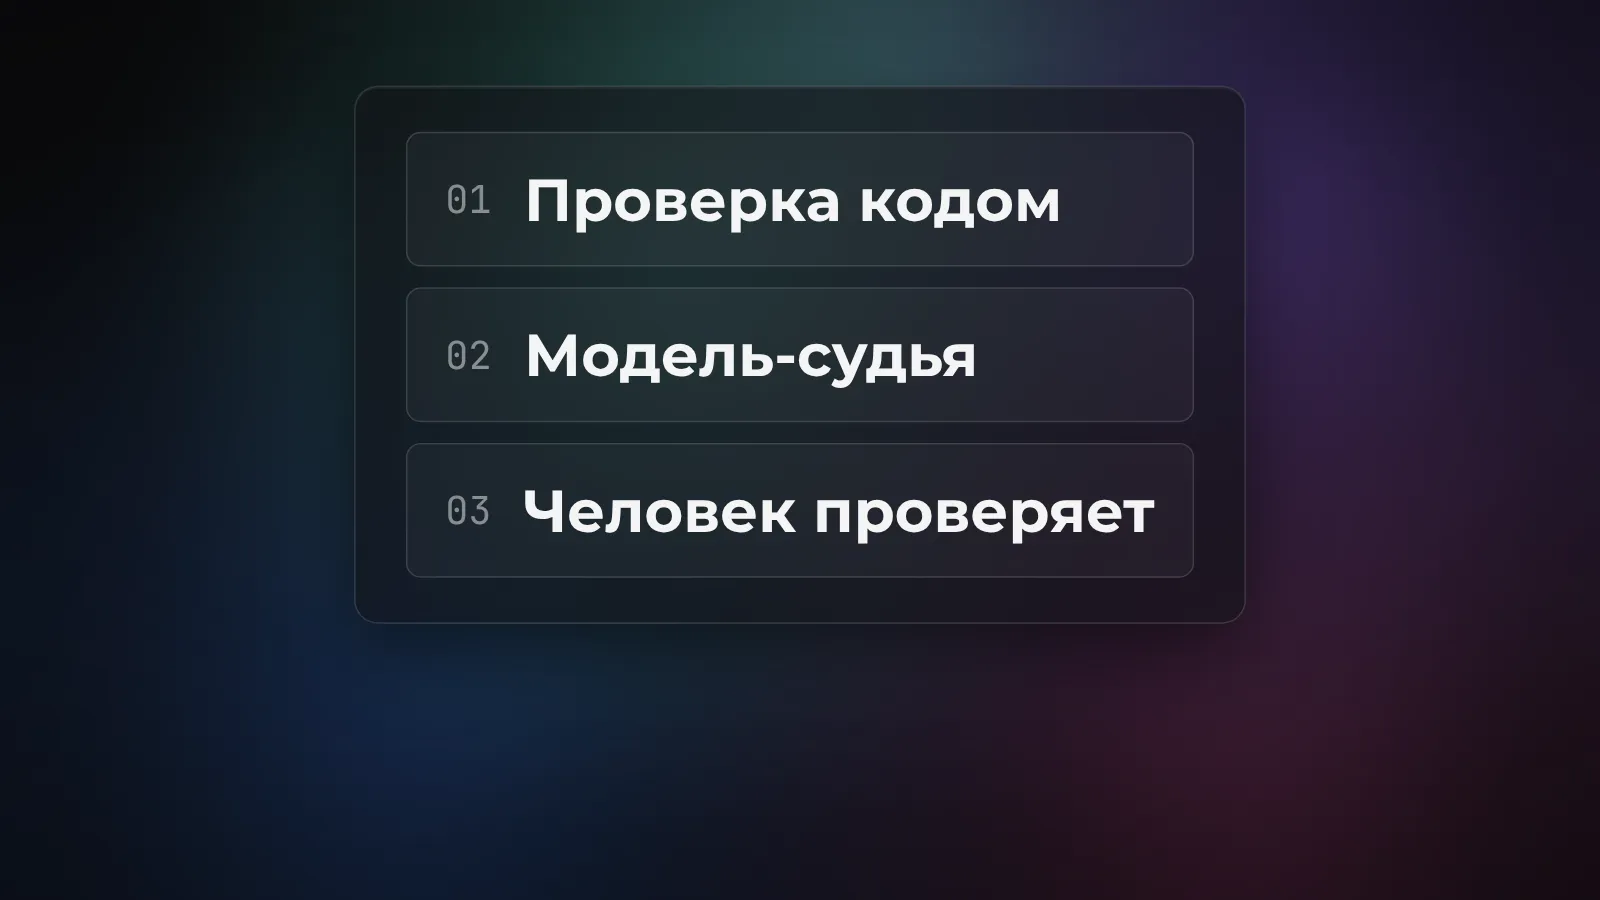
Anthropic делит проверки на три типа. Код умеет проверить строгие вещи: JSON разобрался, очередь существует, возврат действительно оформлен. Другая модель может оценить смысл: вежливо ли агент объяснил отказ и не выдумал ли причину. Человек просматривает спорные примеры и поправляет судью. Такой порядок мне нравится: где можно проверить запись в базе, незачем тратить токены на оценку другой нейросетью.
Нужна и полная история действий агента, или trace: что он прочитал, какой инструмент вызвал, что записал и какой ответ получил пользователь. Финальное «готово» легко выглядит убедительно, даже когда никакой записи в базе не произошло. У Anthropic для этого есть отдельный пример с возвратом денег: красивого ответа мало, нужно проверить состояние возврата.
Это не особая магия Claude. Документация LangSmith советует сначала вручную собрать несколько хороших примеров для каждого важного компонента и отдельно оценивать выбор инструментов и ход работы агента. В руководстве Braintrust та же базовая рамка: данные для проверки, сама задача, способ выставить оценку. Новый сценарий Claude Code снимает часть рутины по сборке и повторным запускам; решение о том, что считать удачей, остаётся за владельцем продукта.
Как собрать первый набор задач
Команда build-eval, по описанию Anthropic, ищет сырьё в таком порядке: записи реальных диалогов с оговоркой о хранении и чувствительных данных, сообщения о багах, несколько примеров от тебя и уже потом синтетические случаи на основе кодовой базы. Дальше показывает входные данные на странице для просмотра и ждёт подтверждения. Это не режим «поручи и уйди спать»: сам владелец продукта решает, отражают ли задания работу настоящих пользователей.
Я бы начинал с писем и задач, на которых агент уже ошибался. Добавил бы пару обычных успешных случаев и пару ситуаций, когда действие совершать нельзя. Если проверять только «должен отправить клиенту письмо», можно получить агента, который пишет всем подряд. Для рабочего набора Anthropic советует брать реальные ошибки и вручную проверяемые сценарии; на раннем этапе, по её инженерному разбору, достаточно начать с 20-50 задач. Это ориентир компании, а не магическое число для любого продукта.
Проверяющий алгоритм тоже нужно испытать. Попроси его оценить несколько примеров, для которых ты уже знаешь ответ, включая случаи «да» и «нет». Читай не только общую долю успешных, но и след каждого спорного прогона. В официальном сценарии инструмент повторно оценивает один и тот же ответ, чтобы увидеть, меняется ли вердикт судьи без изменения данных. Если меняется, сравнивать промпты по такой линейке рано.
Что делает hillclimb и откуда берётся экономия
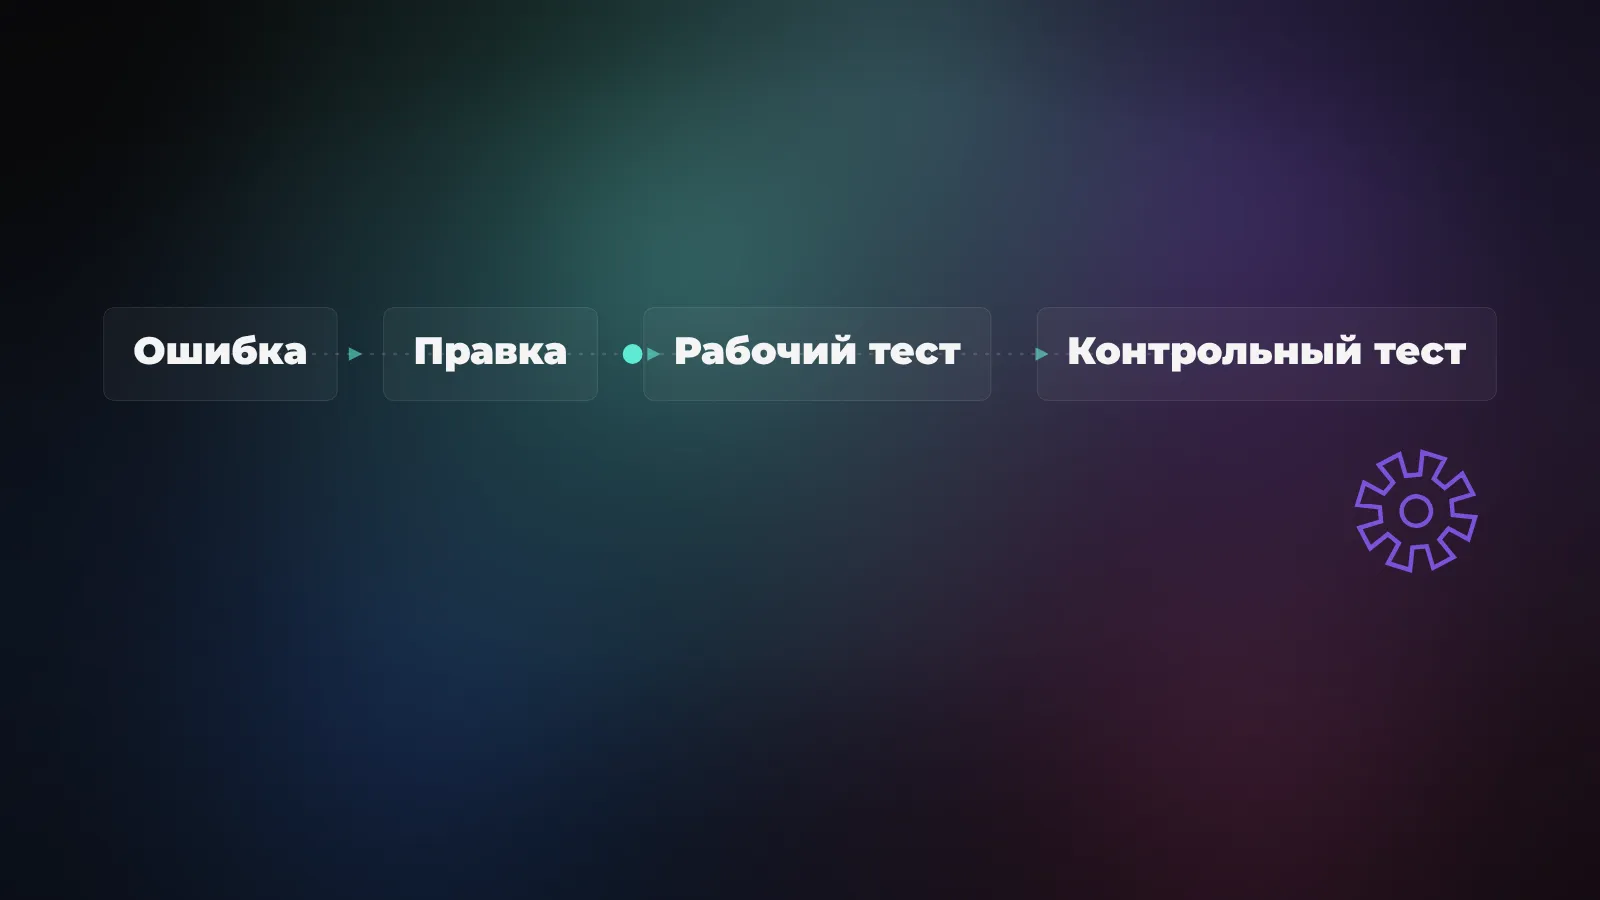
Когда набор готов, /claude-api hillclimb предлагает выбрать цель: повысить качество или сократить стоимость без потери качества. Ты задаёшь, что ему разрешено менять. По описанию Anthropic, инструмент случайно делит примеры на рабочую часть и отложенную контрольную, читает ошибки на рабочей, вносит по одной правке, запускает проверку снова. Если улучшился только рабочий набор, а контрольный стоит на месте, правку откатывает. Если разница лежит в пределах случайного разброса, улучшение не засчитывается.
В опубликованном примере Anthropic проверяла маршрутизацию обращений в поддержку. После упрощения промпта, смены модели и её режима усилия стоимость одного задания на рабочей части снизилась с 4,6 до примерно одного цента; точность на отложенных заданиях выросла по замерам авторов. Звучит здорово, но я бы не продавал это как обещание «любой агент подешевеет в пять раз»: там конкретный набор обращений, модели, тарифы и промпт. Моя собственная задача может дать другой результат или вообще никакого.
Главная инженерная мысль не в красивой экономии, а в способе сравнения: цена за выполненное задание, успех на отложенных случаях, журнал конкретных ошибок. Дешёвый ответ, после которого агент трижды повторяет вызов и всё равно проваливает задачу, не делает систему дешевле. На примере обрезанных логов эта ловушка уже проявлялась особенно хорошо.
Где инструмент пока спотыкается
Хамел Хусейн, специалист по оценке ИИ-продуктов, попробовал новый инструмент на разговорах агента по аренде квартир. Он заметил, что Claude предложил выбрать сбой для оценки до того, как люди внимательно прочитали сами диалоги. Получился знакомый эффект: инструмент очень быстро строит то, о чём его попросили, а вот хороший ли это объект проверки, ещё неизвестно.
Дальше проверять выставленные им метки предлагалось в Markdown-файлах с длинными разговорами и сообщать об ошибках обратно в чат. Хусейну с коллегой пришлось отдельно попросить интерфейс для разметки. Наконец, одну проверку передачи звонка человеку инструмент смешал из нескольких разных ошибок: повторное подтверждение, лишние слова при переводе, озвучивание технических деталей. Общая галочка скрыла, что именно сломалось. По его собственному опыту, находить потенциальные проблемы инструмент умеет впечатляюще, но ставить его на полностью автономный контроль он пока не советует.
Здесь нет конфликта «Anthropic врёт, независимый тест всё опроверг». Документация Anthropic говорит, как задуман сценарий: просмотр данных, проверка судьи, контрольный набор. Хусейн показал, как он сработал на одной реальной сессии. Это разные уровни доказательств. И судя по его заметке, автор инструмента уже получил обратную связь, так что детали интерфейса могут измениться. Не превращай этот единичный опыт в универсальный вердикт, но воспользуйся им как чек-листом при собственной проверке.
Как я бы применил это к своему контент-агенту
У меня агент выбирает тему и пишет статью. Самый простой полезный тест - дать ему карточки новостей, где одна тема уже опубликована, другая подтверждается первоисточником, а третья держится только на красивом заголовке Reddit. Хороший результат - агент выбрал проверяемую и новую тему или честно пропустил день. Проверять это надо на реальном реестре и файлах статей, а не по уверенности текста «дедуп сделан».
Второй тест - факты. В дайджесте может быть точная цена, но официальная страница говорит другое. Я бы отдельно проверял, что агент либо привёл ссылку на первоисточник с верной ценой, либо убрал неподтверждённую цифру. Для формальных требований хватает кода: есть дата, проходит сборка, существуют файлы картинок. Для качества первого абзаца и честности выводов уже нужен человек и аккуратно сверенный судья. Смешать всё в один процент «качество статьи» - значит спрятать конкретный брак.
Такой набор полезнее абстрактного рейтинга моделей. Если завтра я сменю модель, у меня будет ответ на практический вопрос: стала ли она реже публиковать дубли и лучше проверять факты именно в моём рабочем процессе? Отдельная история про агентов, прошедших видимые тесты и не починивших баг напоминает: проверочный набор тоже может быть дырявым. Сперва посмотри на реальные ошибки, потом уже оптимизируй балл.
Стоит ли пробовать сейчас
Да, если у тебя есть повторяемый агентный процесс и хотя бы несколько сохранённых ошибок. Обнови Claude Code, открой проект, вызови /claude-api build-eval и дай инструменту реальные примеры. Посмотри на каждый выбранный случай и на логи, которые он собирается читать. Утверди критерии, вручную перепроверь спорные оценки и только потом запускай /claude-api hillclimb с чётко ограниченным списком допустимых изменений.
Если продукта ещё нет и ошибок пока не накопилось, начни с ручного списка сценариев: что агент должен сделать, что ему делать запрещено и каким фактом это подтверждается. У Anthropic есть большой инженерный разбор про построение оценок и отдельная документация по кодовым и модельным проверкам. Никакой дорогой платформы для первого теста не требуется. Гораздо труднее честно записать, что в твоей задаче считается успехом.
Мой вывод: новая команда экономит время на сборке и сравнении тестов, но не отменяет работу редактора проверок. Сначала реальные случаи, потом судья, потом оптимизация. Поменяешь порядок - получишь автоматическую машину для улучшения отчётов. Я бы предпочёл машину для улучшения агента.
Источники
- Anthropic / claude.dev: Automating eval design and hillclimbing with Claude
- Anthropic Engineering: Demystifying evals for AI agents
- Claude Platform Docs: Define success criteria and build evaluations
- Hamel Husain: Claude’s new auto eval tool - независимый тест
- Hamel Husain и Shreya Shankar: Evals Skills for Coding Agents
- LangSmith: Evaluation concepts
- Braintrust: Evaluate systematically