1 сентября 2026 г.
SQLite выучил git: что умеет DoltLite и как его попробовать

DoltLite - это форк SQLite, который умеет то же, что git: ветвиться, коммитить изменения таблиц, показывать диффы и вливать ветки обратно через мерж. 31 августа DoltHub объявил бету версии 0.50.0: формат хранения зафиксирован, а SQL-совместимость проверена почти миллионом тестов. Ставится одной командой pip install doltlite. Подвох один - запись стала медленнее.
История вышла 31 августа, и в ней два слоя. Первый: встраиваемая база данных, самая распространённая на планете, получила версионирование данных. Второй: почти весь этот форк написали ИИ-агенты, порядка двух тысяч пул-реквестов. Разбираю оба - что это даёт тебе на практике и во что обойдётся.
Что это такое
SQLite хранит таблицы в файле, и файл этот непрозрачен: открыл базу, удалил строку, закрыл - и всё, строки больше нет, истории не осталось. DoltLite заменяет внутренний слой хранения так, что каждое изменение данных можно закоммитить, а любое состояние базы - восстановить. Документация Dolt формулирует это коротко: git версионирует файлы, Dolt версионирует таблицы.
DoltHub - компания, которая с 2019 года делает Dolt, MySQL-совместимую базу с git-семантикой, и хостинг DoltHub для шаринга датасетов. DoltLite - их третий продукт в этой линейке, и технически он любопытнее старших: вместо того чтобы писать свой SQL-движок поверх версионируемого хранилища, как в Dolt, они взяли готовый движок SQLite и подменили у него только слой хранения. Парсер, анализатор, оптимизатор - стоковые. Ниже слоя B-деревьев стоит prolly tree - контентно-адресуемое дерево, то же семейство структур, на которых держатся git и IPFS.
Проект запустили в марте 2026, и пять месяцев формат хранения менялся двенадцать раз. Бета объявлена тогда, когда формат держится стабильным уже 57 релизов подряд, больше трёх месяцев. Для встраиваемой базы это важнее фич: файл, который не откроется следующей версией, - не база, а мина.
Зачем базе данных ветки
Проще на сценариях, потому что абстракция «git для таблиц» сама по себе звучит как решение в поисках проблемы.
Первый сценарий - эксперименты над данными. Твоя программа что-то считает по таблице: пересортировала прайс, прогнала скрипт чистки, залила новый датасет. С обычным SQLite каждый такой шаг - точка невозврата, если заранее не скопировал файл. С DoltLite делаешь ветку, экспериментируешь, смотришь дифф и либо вливаешь ветку, либо удаляешь.
Второй - ревью данных. Изменения таблиц коммитятся как код, значит к ним применим тот же процесс: увидел дифф до и после, обсудил, принял или откатил. Для команд, где в базу руками лазают и аналитики, и скрипты, это способ увидеть, кто что поменял, не поднимая аудит-логи.
Третий - страховка от агентов. ИИ-агент, которому дали доступ к базе, меняет данные быстро и без сомнений. Когда изменения лежат в коммитах, ошибка агента - это revert, а не восстановление из бэкапа. DoltHub прямо делал DoltLite под это: их графический Workbench умеет режим agent mode, а функция dolt_reset('--hard') описана в документации как способ откатить самодеятельность агента к последнему коммиту. Я недавно разбирал историю, где агент снёс 700 ГБ разработчику - вот тут подробности, и версионированная база ровно про этот класс аварий.
Четвёртый - синхронизация. У DoltLite есть push, pull и clone: базу можно клонировать с ремоута или синхронизировать между устройствами через DoltHub. На Hacker News самый восторженный комментарий был именно об этом: разработчик local-first приложения, где данные синкаются между устройствами, увидел в этом готовый слой синхронизации.
Как это устроено внутри
Коротко о механике, потому что она объясняет и возможности, и ограничения.
Обычный SQLite раскладывает таблицы по страницам и собирает их в B-дерево. DoltLite вместо этого строит prolly tree: содержимое базы режется на чанки, у каждого чанка считается хеш, и хеши складываются в дерево. Адрес ячейки зависит от её содержимого, поэтому одинаковые данные у двух людей дают одинаковое дерево. Отсюда и трюки: дифф двух веток - это сравнение деревьев, мерж - трёхстороннее слияние на уровне строк, а clone передаёт только те чанки, которых у тебя нет, как объекты в git.
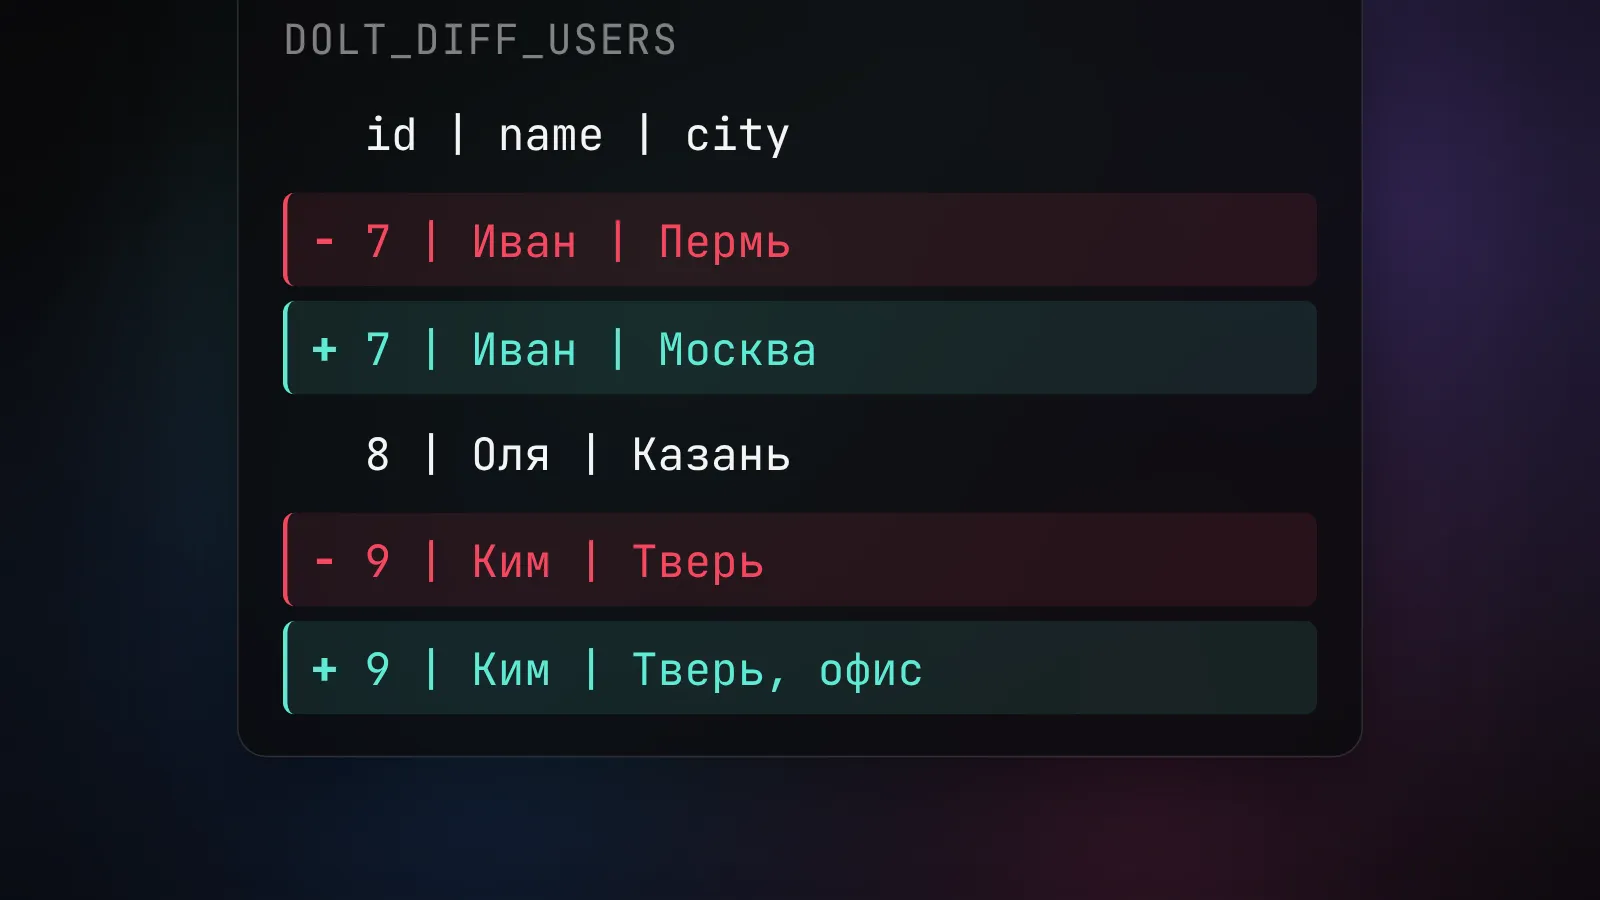
Дифф доступен и из SQL: для каждой таблицы генерируется виртуальная таблица dolt_diff_users, в ней строки были-стали. Мерж - трёхсторонний, на уровне строк: изменения, которые трогали разные строки, сливаются автоматически, и это большинство случаев. Конфликт - когда две ветки поменяли одну и ту же строку.
И тут отличие от старшего Dolt, которое стоит знать заранее: конфликт в DoltLite не переживает транзакцию. Разрешить его нужно внутри той же транзакции, где ты запустил мерж - увидеть конфликт, решить руками, закоммитить. Оставить «разберусь потом» не получится. Зато и полуслитых состояний в базе не остаётся: мерж либо прошёл, либо ветка там же, где была.
Как поставить
Бета версии 0.50.0, лицензия Apache 2.0, так что попробовать можно бесплатно и без регистрации.
Самый быстрый путь - биндинги. Для Python: pip install doltlite. Для Node или Bun: npm install @dolthub/doltlite. Есть ещё Ruby, PHP, .NET, Rust, WASM, Swift и Android-сборка - редкий для молодых проектов охват платформ.
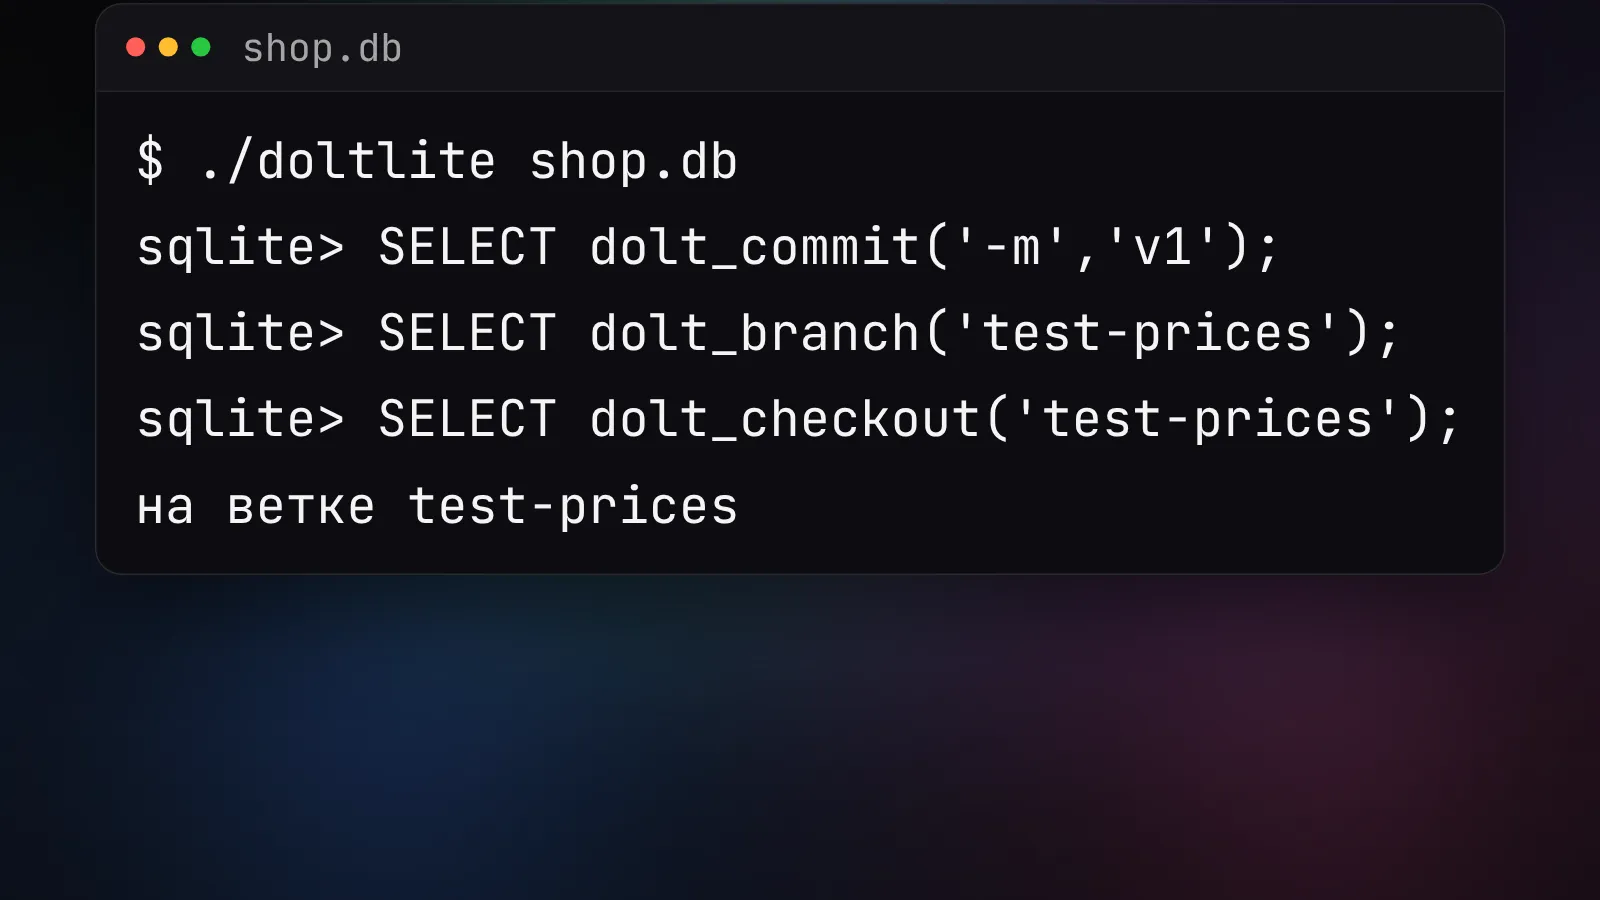
Отдельные бинарники лежат в релизах на GitHub: macOS ARM, Linux x86_64 и ARM, Windows. После установки ./doltlite shop.db открывает файл базы, дальше - обычный SQL. Все git-команды живут прямо в SQL как функции с префиксом dolt_, отдельного CLI-слоя в стиле dolt add нет - ты в той же консоли, где делаешь SELECT:
-- настроить автора коммитов
SELECT dolt_config('user.name', 'Андрей');

-- закоммитить текущее состояние таблиц
SELECT dolt_add('-A');
SELECT dolt_commit('-m', 'база поставщиков v1');

-- ветка и переход на неё
SELECT dolt_branch('test-prices');
SELECT dolt_checkout('test-prices');

-- что изменилось и история
SELECT * FROM dolt_status;
SELECT * FROM dolt_log('main..test-prices');
Ветку можно открыть прямо при подключении к файлу: ./doltlite shop.db@test-prices - и все соединения в этой сессии работают с веткой, не трогая main. Для файлов обычного SQLite движок определяет формат и открывает их как есть, но версионирование работает только для баз формата DoltLite.
Подвохи беты
Теперь честная часть, без которой обзор такого инструмента был бы рекламой.
Совместимость. По замерам самих разработчиков, DoltLite проходит 100% sqllogictest - это 5,8 миллиона запросов, - и 99,46% из 892 тысяч приёмочных тестов самого SQLite. Оставшиеся полпроцента, около 4,8 тысячи расхождений, задокументированы: таблицы на rowid, поведение чанков против страниц, отсутствие WAL. Для встраиваемой базы такие цифры серьёзные, но это цифры тестов, а не десяти лет продакшена у миллиарда устройств, как у SQLite.
Скорость. Чтение почти не пострадало: в памяти на 10% медленнее, при работе с файлом - паритет. Запись дороже: в памяти на 60% медленнее, при батченной записи в файл - на 10%. Самый болезненный случай - мелкие одиночные записи в режиме автокоммита: около 400 микросекунд против 125 у SQLite, то есть втрое медленнее. Разработчики прямо рекомендуют собирать записи в батчи и публикуют ночные замеры производительности в открытом виде.
Ограничения формата. Нет WAL и journal-файлов. Один постоянный писатель: конкурентные записи получают SQLITE_BUSY. Мерж конфликтов не переживает транзакцию. Cherry-pick работает с одиночными коммитами, stash нет.
И реакция сообщества. Тред на Hacker News собрал 48 баллов и 33 комментария, и скепсиса там заметно больше, чем восторга. Главные возражения: «зачем доверять данные базе, написанной агентами» и «главный продукт базы данных - валидация, а не экзотические структуры». Кто-то резонно замечает, что скопировать файл SQLite - тоже способ сделать «ветку». Это справедливые вопросы к любой молодой базе, и лучший ответ на них - те самые открытые тесты и ночные замеры: проверяй, а не верь.
Две тысячи пул-реквестов от агентов
Вторая часть истории - как эту базу написали.
DoltHub собирал DoltLite как пет-проект для обкатки Gas Town, оркестратора ИИ-агентов Стива Йегге, который дошёл до версии 1.0 весной 2026. По словам разработчиков, форк потребовал примерно две тысячи пул-реквестов, и сделала их команда агентов - люди ставили задачи и ревьюили результат. Модели не названы, но факт остаётся фактом: версионированный форк SQLite с переносимым форматом и миллионами пройденных тестов - это уже не генерация скриптов по промпту, а инженерный проект, исполненный агентами.
Симметрия тут красивая. Инструмент, который страхует данные от ошибок агентов, сам построен агентами - и сам опирается на git-механику пул-реквестов, которая делает такую работу возможной. Это тот же сдвиг, о котором я писал в разборе spec-driven development: когда исполнитель - агент, ценность смещается от набора кода к артефактам, которые можно проверить, - спека, тесты, коммиты, диффы.
Кому пробовать
Если ты делаешь локальный инструмент, пет-проект, датасет для RAG-экспериментов или скрипт, который мутирует таблицы и хотелось бы иметь кнопку «назад» - DoltLite ставится за минуту и решает это сегодня. Встраиваемый формат без сервера и порога входа, плюс бонус для ИИ-задач: расширение векторного поиска vec1 встроено, и векторные таблицы версионируются наравне с обычными - можно коммитить состояния эмбеддингов и откатывать пересборки.
Если у тебя продакшен с высокой нагрузкой на запись, несколькими писателями или строгие требования к проверенным годами зависимостям - рано. Следи за проектом, погоняй на копии данных и вернись, когда он выйдет из беты.
Мой прогноз: версионирование данных - та же история, что и версионирование кода. Git когда-то был «зачем мне это, у меня и так работало», а сейчас ветка без истории изменений - маркер небрежности. С данными пока так же, но агенты, которые ломают таблицы быстрее, чем человек успевает заметить, сильно ускорят этот переход.