8 октября 2026 г.
Claude Haiku 5.5: когда новая дешёвая модель дорожает в пять раз
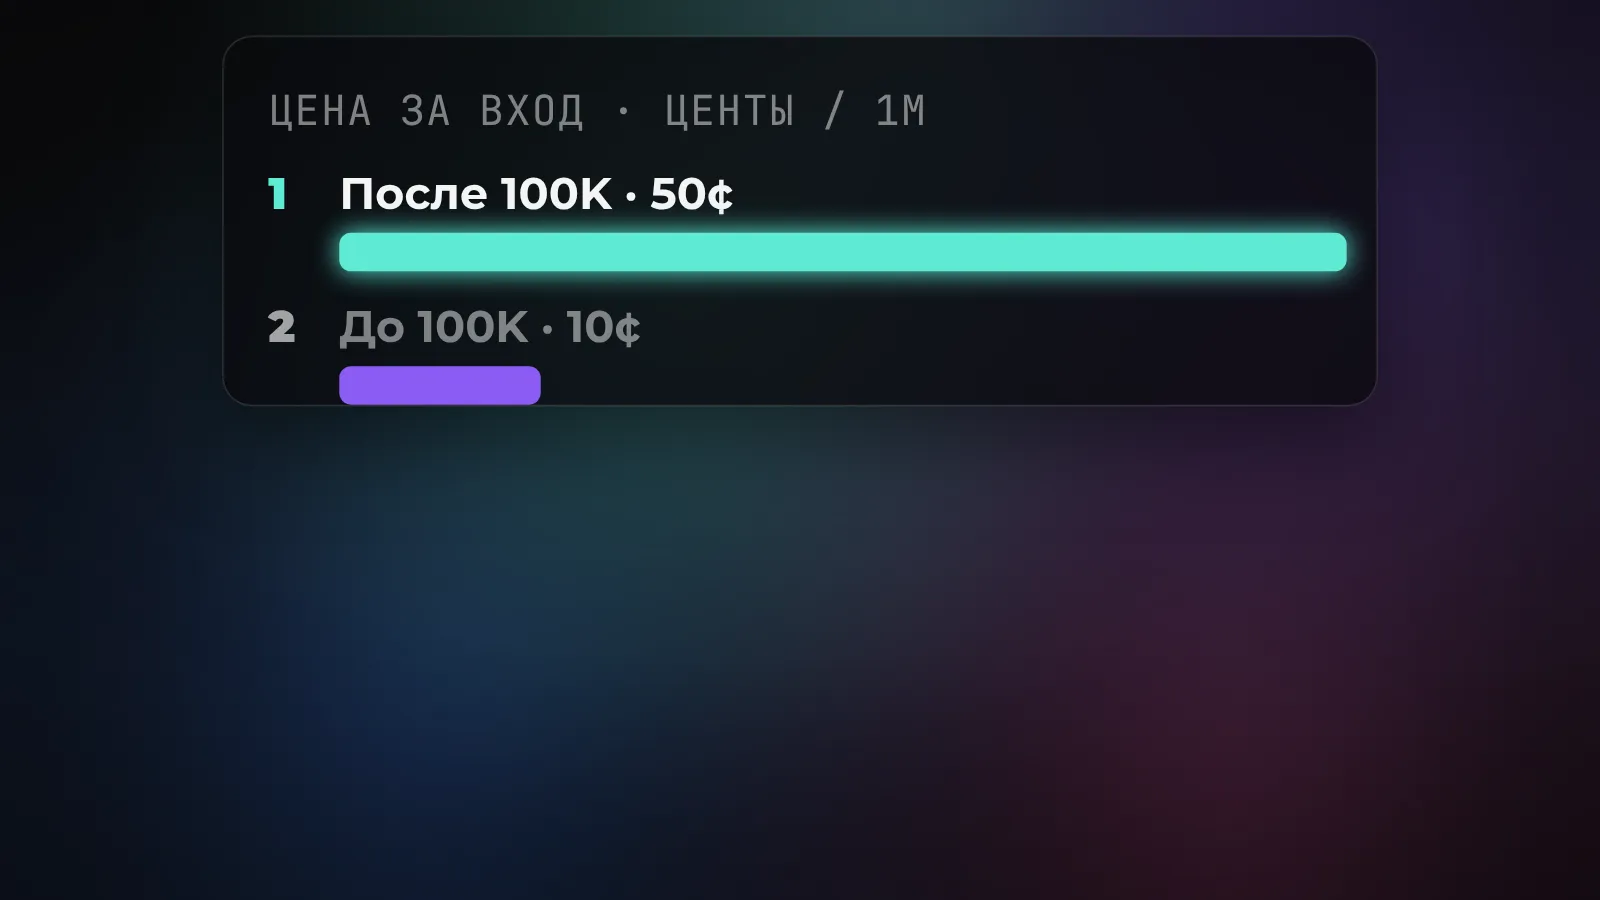

Claude Haiku 5.5 - новая компактная модель Anthropic для массовых коротких задач. В API миллион входных токенов стоит от $0,10, выходных - от $0,50. Но если один запрос превышает 100 тысяч токенов, ставки становятся в пять раз выше. Для классификации писем это выгодно; для длинной агентной сессии сначала считай стоимость всей задачи, а не цену в рекламной таблице.
Вышла модель 7 октября. Вокруг уже спорят: одни видят наконец доступную Claude для потока задач, другие получили неожиданный счёт на длинном контексте. Меня здесь интересует граница между этими сценариями. Разберу прайс по строкам, покажу, как попробовать модель, и объясню, где в собственном пайплайне она окупится.
Что именно вышло
Haiku - младшая модель семейства Claude. Её берут, когда запросов много, а ждать тяжёлую модель ради каждой мелочи жалко. Например, входящее письмо надо отнести к одной из категорий, извлечь номер заказа и передать дальше. Здесь не нужен большой литературный ответ. Зато важны скорость и предсказуемая стоимость тысяч вызовов.
Anthropic представила Haiku 5.5 7 октября 2026 года. Компания предлагает её для классификации, извлечения данных, маршрутизации запросов и работы младшим агентом рядом с Sonnet или Opus. В Claude API идентификатор модели - claude-haiku-5-5. По официальной карточке, доступное окно контекста составляет миллион токенов, предел обычного ответа - 128 тысяч. На вход она принимает текст и изображения, на выход даёт текст. Открытых весов нет: поставить Haiku дома как локальную модель нельзя.
Важная новинка для семейства Haiku - регулируемые усилия, effort. Модель сама решает, сколько рассуждать, а ты задаёшь уровень. По умолчанию в API и Claude Code стоит medium; для простых массовых задач в документации предлагают проверить low. Высокие уровни могут удлинить ответ и увеличить расход токенов. Я бы не переключал весь рабочий поток на max только потому, что название звучит внушительно.
Сколько стоит короткий запрос и длинный
У Haiku 5.5 два прайса. Граница определяется длиной одного промпта в конкретном запросе, а не числом токенов за день или размером всей папки проекта. По официальному тарифу Claude Platform, для промпта до 100 тысяч токенов и после этого порога ставки такие:
| За миллион токенов | До 100 тыс. в промпте | Свыше 100 тыс. в промпте |
|---|---|---|
| Вход | $0,10 | $0,50 |
| Выход | $0,50 | $2,50 |
| Чтение из кэша | $0,01 | $0,05 |
| Запись в кэш на пять минут | $0,125 | $0,625 |
Это ставки за все токены запроса соответствующего типа, когда промпт попал в дорогой диапазон, а не надбавка только на кусочек после стотысячной отметки. Кэш уменьшает цену повторно используемого префикса, но сам не отменяет порог. И здесь уже интересно: у Sonnet 5.5 стандартная ставка действует на всё заявленное окно контекста, а у младшей Haiku на длинной сессии включается отдельный тариф.
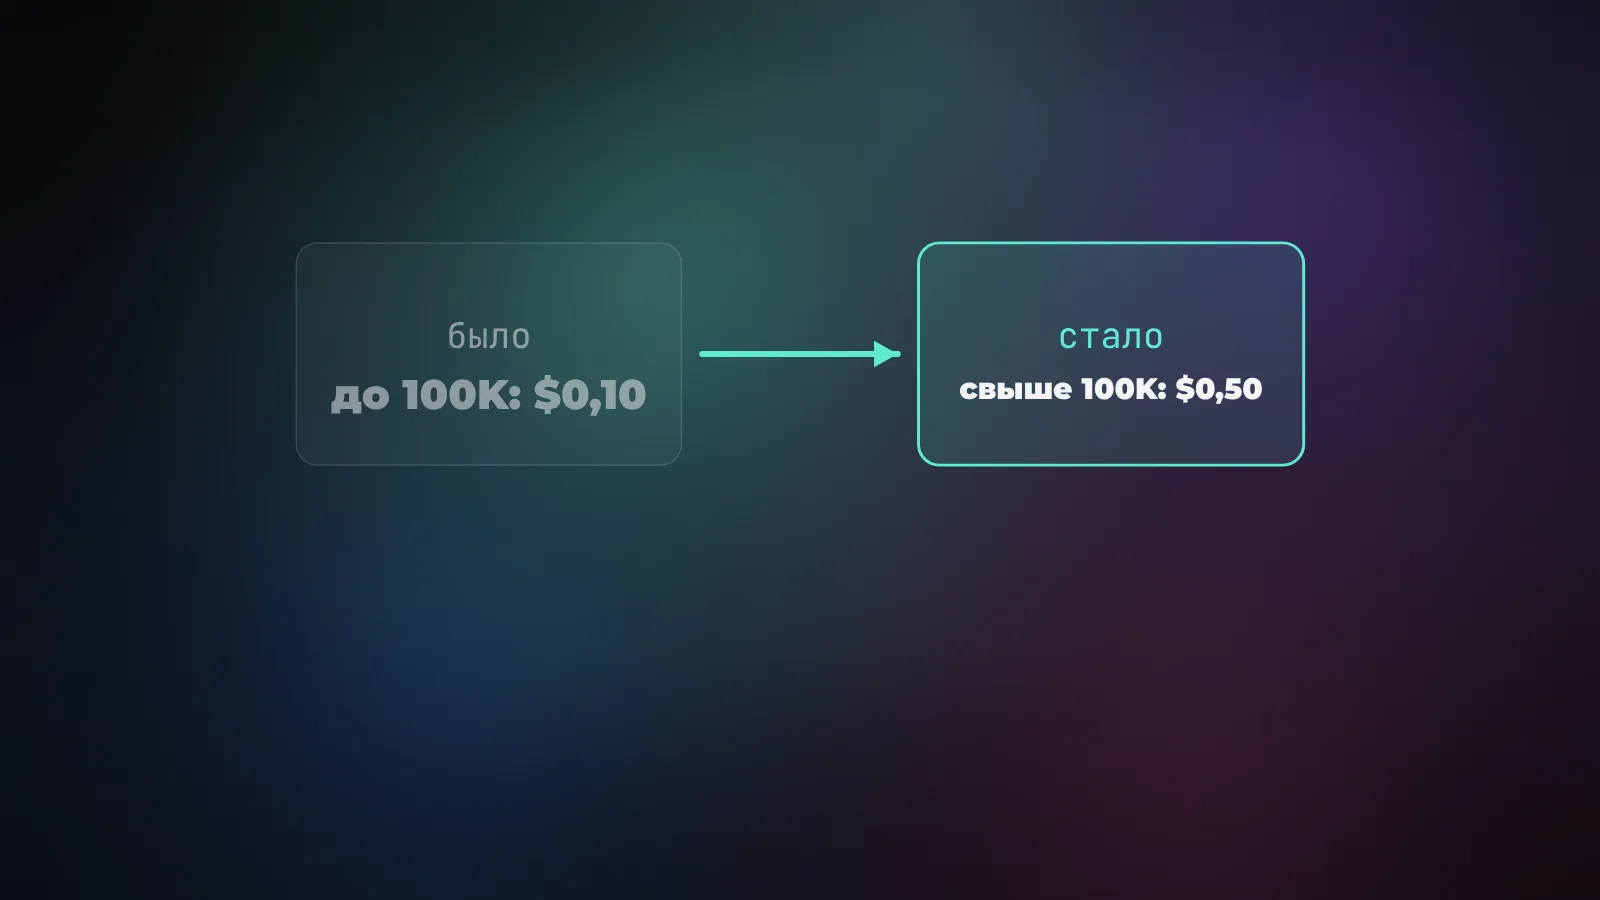
Anthropic пишет, что на коротких запросах ставка за токен упала на 90% относительно Haiku 4.5, на длинных - на 50%. Это сравнение прайсов, а не обещание такой же скидки на твою задачу. Смена токенизатора делает тот же текст примерно на 30% длиннее в токенах; сам объём рассуждения тоже зависит от режима effort. Заявленные компанией примерно 75% экономии в среднем нельзя механически переносить на свою очередь тикетов.
Почему миллион токенов контекста не означает дешёвый миллион
Окно в миллион токенов отвечает на вопрос «сколько модель вообще способна получить за вызов». Прайс отвечает на другой вопрос: «сколько стоит вызов, когда история выросла». У агента каждый следующий шаг часто снова отправляет прежнюю переписку, результаты инструментов и новые инструкции. Промпт становится длиннее даже тогда, когда твоя исходная просьба помещалась в одно предложение.
Представь обработчик обращений. Один клиент пишет короткое письмо, модель относит его к «оплате» и возвращает номер заказа. Контекст маленький, цена низкая, время отклика приятно короткое. А теперь дай той же модели репозиторий, длинную переписку об ошибке и право десятки раз читать файлы. После каждого хода история снова идёт на вход. Тот же дешёвый тариф может перестать действовать на следующих вызовах. Поэтому одну модель нельзя выбирать сразу для обоих сценариев по первой строке прайса.
Автор свежего опыта на Reddit сравнил Haiku 5.5 с GPT-6 Luna на генерации трёхмерной пагоды и получил оценку расходов $24,96 против $1,96 в эквиваленте API. Он использовал режим xhigh через стороннюю оболочку и подписки, а не опубликовал воспроизводимый биллинг двух одинаковых API-прогонов. Промпты и ход работы полностью не предоставлены. Так что «Haiku всегда в двенадцать раз дороже» из этого не следует. Зато официальная пятикратная смена тарифа после порога реальна, и она объясняет, почему такой результат вообще возможен.
Ещё одна ловушка: при длинной задаче можно сэкономить на ставке, но потерять на повторных попытках. Если модель дважды ищет файл, которого не нашла с первого раза, счётчик токенов растёт, а задача стоит на месте. Здесь полезнее посмотреть на первичные проверки будущих пользователей модели. AlphaSense прогнала 400 собственных запросов к документам: по её оценке, качество выросло с 0,76 до 0,84 относительно Haiku 4.5. Эти цифры опубликовала Anthropic со слов инженера AlphaSense. У компании восемь миллионов подобных вызовов в неделю, так что разницу в стоимости ей есть где замечать. Но тест чтения документов ничего не доказывает об автономном исправлении сложного кода.
Где я бы её попробовал
Начал бы с очереди коротких входящих: классификация писем, извлечение полей из документов, первичная сортировка обращений. Задача должна иметь понятный эталонный ответ. Например, у тебя есть несколько десятков уже размеченных писем: модель определяет категорию, а скрипт сравнивает результат с ручной разметкой. Кроме точности записывай долю отказов, время и токены на весь прогон.
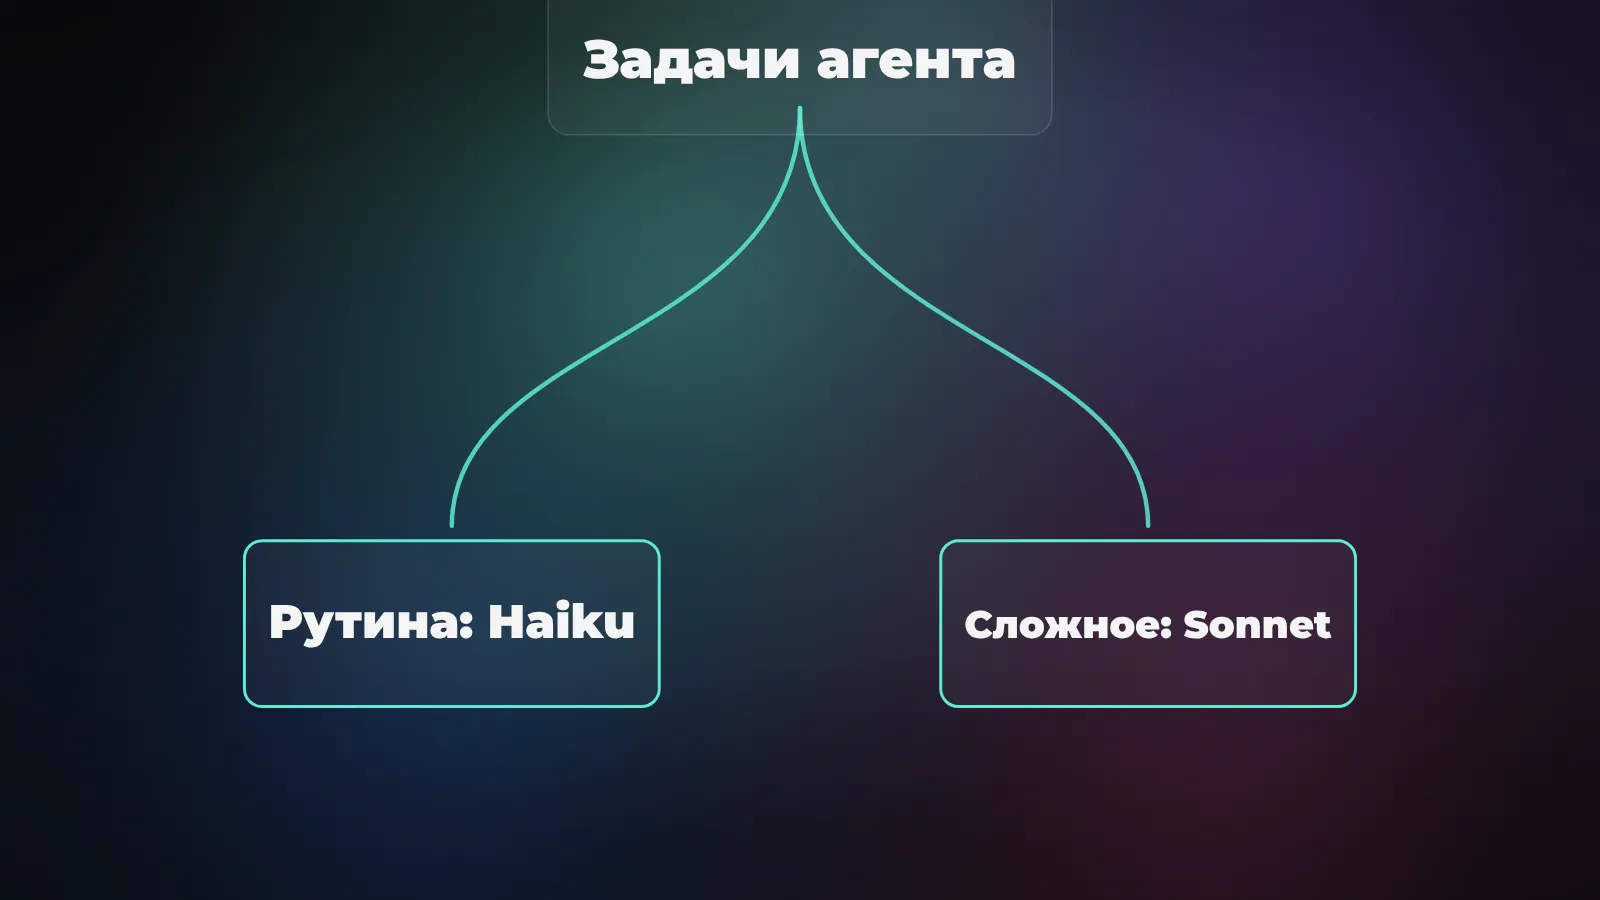
В агентной системе я бы отдал Haiku ограниченную подзадачу: разобрать найденную страницу и вернуть четыре поля, составить краткую сводку результата инструмента, выбрать, кому передать тикет. Главному агенту остаются план, проверка фактов и право менять данные. Так история младшей модели не растёт вместе со всем проектом. Это следует из разделения работы, а не из магической настройки биллинга.
Но дешевизна сама по себе не заменяет проверки. В собственном наборе задач Asana увидела сокращение задержки выполнения более чем на 30% относительно модели, которой уже пользуется. Инженер HubSpot сообщает о 92,8% в проверке CRM-задач, среднее по трём прогонам; там же Haiku быстрее остальных кандидатов находила неоднозначные устаревшие записи. Обе оценки приведены в анонсе Anthropic как комментарии самих компаний. Наборы закрыты, воспроизвести их по опубликованному тексту нельзя. Я бы не считал ни 30%, ни 92,8% прогнозом для твоей базы клиентов. Заведи свои размеченные примеры и сравни с ними.
Независимые пробы дают более скромный ориентир. DataCamp прогнал 24 счёта: обе версии Haiku приняли все решения верно, а прогон 5.5 стоил $0,0098 против $0,25 для 4.5. Но у старой модели был большой бюджет рассуждений, так что приписывать всю экономию новому тарифу нельзя. Саймон Уиллисон проверил разные уровни effort на одной задаче: low ответил за семь секунд, max потратил пять минут и девять секунд. Один рисунок и 24 счёта не заменят проверку твоего потока, зато показывают, почему настройки и длину задачи надо фиксировать до сравнения.
Как попробовать и что проверить при переходе
Самый прямой путь для разработчика - открыть Claude Platform, выбрать Haiku 5.5 в Playground, дать ей десяток своих типичных запросов и сохранить результаты. Для API в параметре model указывай claude-haiku-5-5; менять железо или скачивать веса не требуется. Через Claude Code модель тоже доступна в линейке, но цена API за токены и лимиты подписки - разные способы оплаты: не переноси долларовые расчёты API на тариф Pro или Max. Для работы из России отдельно учитывай ограничения доступа Anthropic; наличие модели в списке само по себе не решает вопрос аккаунта и оплаты.
Если у тебя уже крутится код на Haiku 4.5, одной замены имени модели мало. Руководство по миграции Anthropic требует заново посчитать токены тем же промптом, убрать старый budget_tokens в пользу адаптивного thinking и effort, пересмотреть max_tokens. Нестандартные temperature, top_p или top_k способны дать ошибку 400. Если клиент считает, что первый блок ответа всегда текст, он может споткнуться о блок рассуждений. Тут тестирование важнее красивой таблицы бенчмарков.
Как я бы принимал решение
Для короткого повторяемого потока Haiku 5.5 стоит протестировать первой: тариф низкий, скорость высокая, результат легко сравнить с эталоном. Для многоходового кодинг-агента я бы сравнил её с Sonnet на полностью завершённой задаче, а не на одном ответе. Записал бы количество удачных работ, общую цену, задержку и число ручных исправлений. Если история часто переваливает за 100 тысяч токенов, обрати внимание на дорогой диапазон ещё до внедрения.
Сам релиз мне нравится тем, что делает мелкие операции заметно доступнее. Но порог меняет привычную формулу «младшая модель = дешёвый агент». Дешёвой здесь получается конкретная работа в конкретных границах. Назови задачу, поставь ей пределы и измерь итоговый счёт. Тогда новинка либо действительно сэкономит деньги, либо быстро покажет, где ей тесно.
Источники
- Anthropic: анонс Claude Haiku 5.5 и сравнение тарифов
- Claude Platform: характеристики и идентификатор модели
- Claude Platform: правила тарификации длинного контекста
- Claude Platform: переход с Haiku 4.5 на 5.5
- Anthropic: первичные оценки Asana, HubSpot и AlphaSense в анонсе модели
- DataCamp: собственный тест Haiku 4.5 и 5.5 на 24 счетах
- Саймон Уиллисон: сравнение режимов усилий на одном промпте
- Reddit: авторское сравнение с Luna в длинной агентной задаче