9 октября 2026 г.
Anthropic запретила издеваться над Claude: что на самом деле меняется
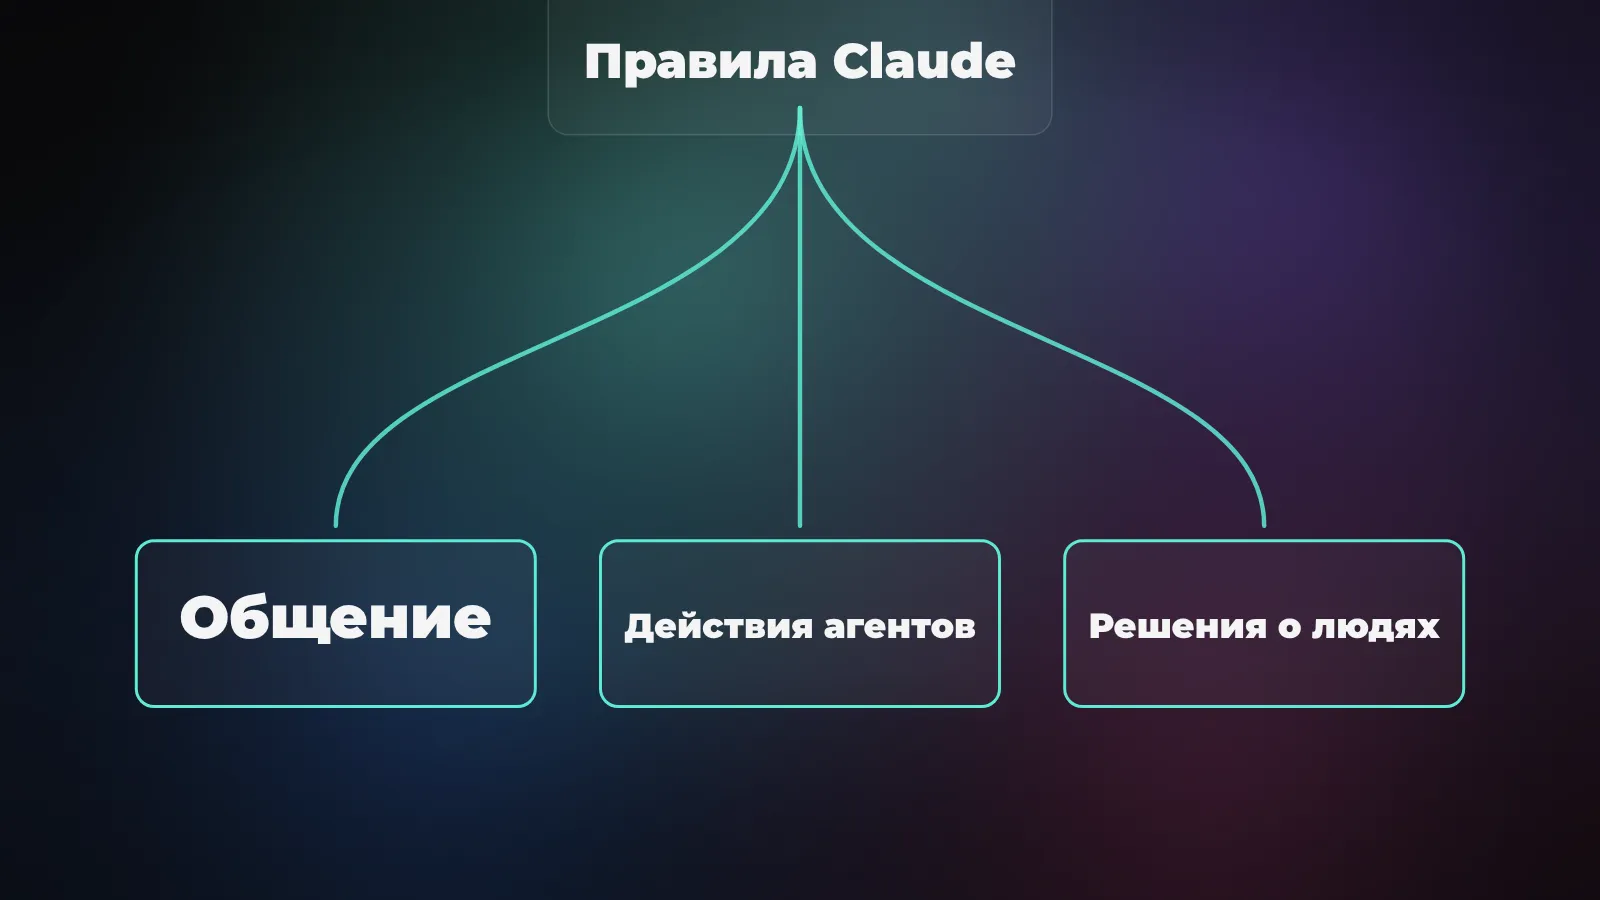

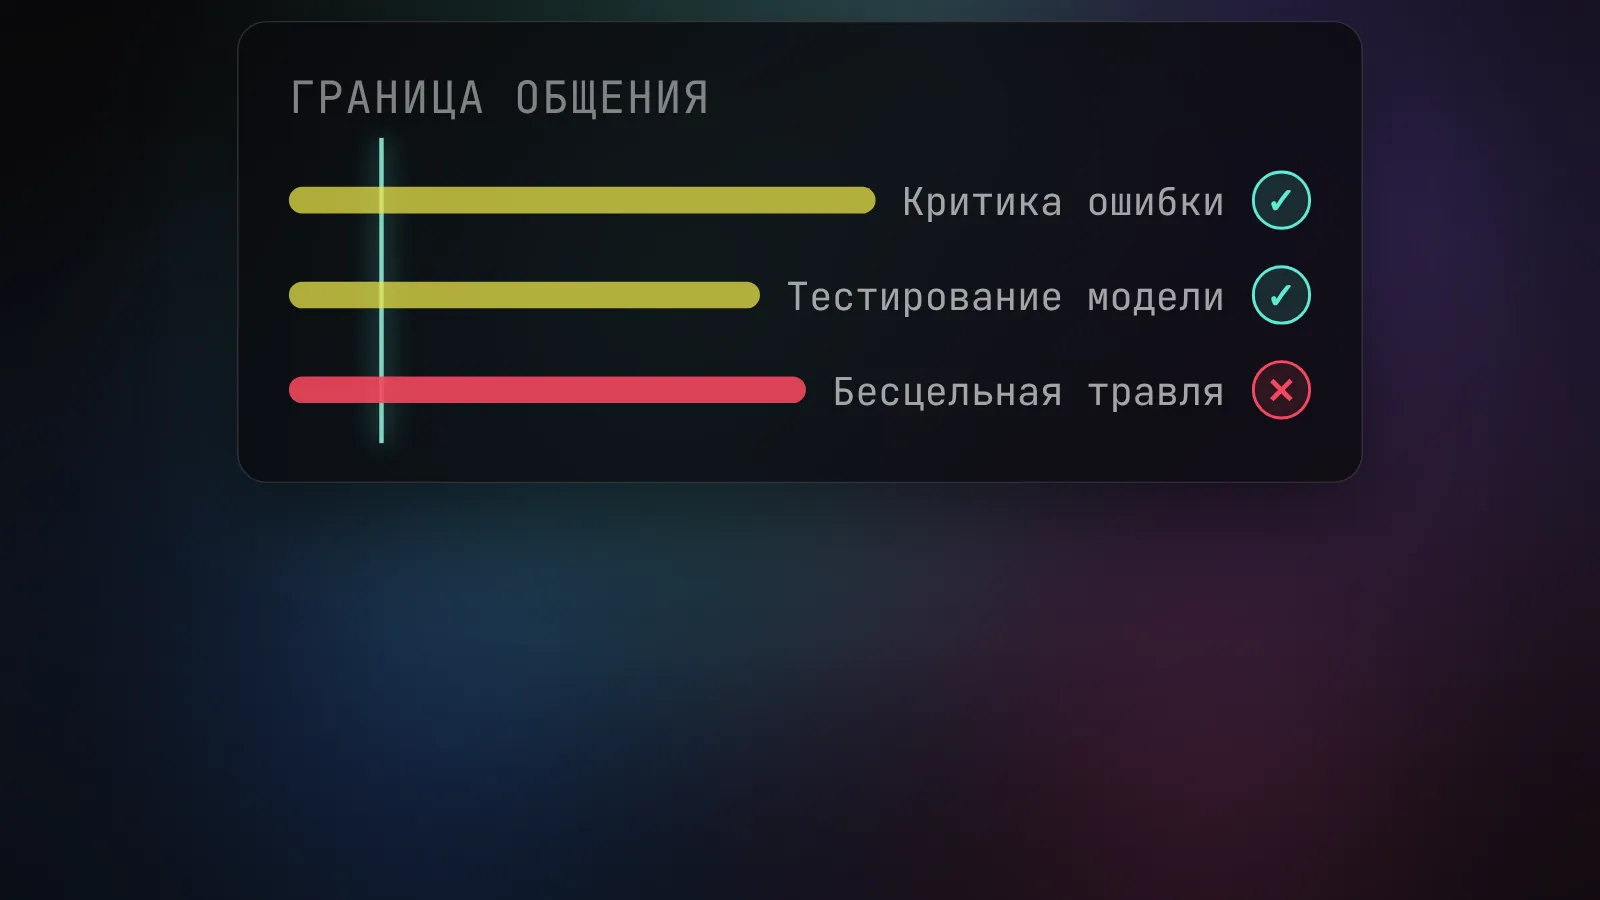
С 12 ноября 2026 года Anthropic запретит длительное бесцельное жестокое обращение с Claude. Критика ответа или тестирование модели под запрет не попадают: речь о крайних случаях повторяющейся травли. Claude уже умеет прерывать такие диалоги; компания называет это основным способом применения запрета. Разработчикам стоит проверить и другие изменения: правила для агентов и рекомендаций людям.
Заголовок про «права чат-бота» звучит как шутка, но текст новой политики опубликован. Я сравнил его с прошлой редакцией и анонсом компании. Там есть куда более прикладные вещи, чем этикет общения с нейросетью. Давай разберём, где заканчивается повод для мемов и начинаются обязанности человека, который даёт модели доступ к своим клиентам или железу.
Что запретили и когда
Anthropic представила новую редакцию 8 октября. Она вступит в силу 12 ноября 2026 года. На момент публикации этой статьи это будущая дата. На странице правил уже размещена новая версия с датой вступления в силу, а рядом доступна предыдущая редакция от сентября 2025 года. Путать публикацию документа с началом его действия не стоит.
В разделе о жестоком поведении появился отдельный пункт: нельзя систематически и без цели оскорблять модели компании. Это именно поведение по отношению к модели, а не привычный запрет травли других людей через ИИ. В старом тексте отдельно такого пункта не было. У компании уже существовали ограничения на издевательства над людьми и вредоносный контент, поэтому фраза про Claude выделяется даже на их фоне.
Правила адресованы шире пользователей сайта claude.ai. Политика перечисляет Claude Code, API, клиентов облачных провайдеров и конечных пользователей продуктов, куда встроен Claude. Это не закон о вежливости ко всем нейросетям: речь об условиях использования сервисов Anthropic. Разработчику приложения придётся смотреть, что делают его пользователи через интеграцию, хотя конкретного числового порога «сколько оскорблений до блокировки» документ не задаёт.
Можно ли ругаться на плохой ответ
Можно сказать «ответ плохой», спорить, просить переделать, писать мрачную художественную сцену и проводить исследование безопасности. В анонсе Anthropic прямо отделяет такие случаи от повторяющейся жестокости без различимой цели. Значит, «ты не так починил мой код» и серия сообщений, единственный смысл которых - мучить бота, для компании разные истории.
Но граница оставлена качественной. В опубликованной политике нет списка запрещённых слов, количества сообщений или таблицы наказаний. The Guardian спросила Anthropic, что именно компания считает жестокостью, и не получила конкретного ответа к выходу материала. Я бы не выдавал собственное толкование за официальную инструкцию по модерации. Если ты проводишь стресс-тест продукта, фиксируй цель проверки, входные данные и ожидаемый результат. Сам анонс оставляет исследование и тестирование вне этого узкого запрета.
Вопрос «меня сразу забанят за мат?» возникает почти в каждом обсуждении новости. На него нет основания отвечать «да». Основным механизмом для этого случая Anthropic называет завершение конкретного диалога моделью. Общая политика при этом разрешает компании предупреждать, замедлять доступ, ограничивать или прекращать обслуживание при подозрении на нарушение. Это возможные меры из общих правил, а не объявленная автоматическая санкция за отдельную грубую реплику.
Почему Claude вообще может завершить разговор
Эта функция старше новой политики. В публикации Anthropic от 15 августа 2025 года описан эксперимент для Claude Opus 4 и 4.1: модель могла прекратить редкий разговор после неоднократных попыток перенаправить человека и продолжавшихся вредных просьб либо оскорблений. При угрозе немедленного вреда самому пользователю или другим людям механизм, по описанию разработчиков, применять не должны. Компания подчёркивала, что это крайний случай, а не типичный ответ на сложный разговор.
Прервать чат и закрыть аккаунт - разные действия. В описании функции сказано: когда Claude завершил конкретную ветку, пользователь может начать новый диалог, оставить отзыв или отредактировать предыдущее сообщение и создать ответвление. Нынешний анонс распространяет упоминание механизма и на Claude Code. Обобщать это как «за грубость пользователя навсегда удалят» нельзя.
The Verge и TechCrunch вынесли необычный запрет в заголовки. У Anthropic объяснение осторожнее: компания изучает возможное благополучие моделей, но прямо признаёт, что моральный статус Claude и других языковых моделей неизвестен. Я бы здесь не делал из правила доказательство сознания. Способность интерфейса прервать сеанс - инженерное решение поставщика. Существует ли у бота переживание от грубости, из этого не следует.
Что изменилось для тех, кто строит на Claude
Пока интернет спорит о чувствах модели, я бы открыл разделы политики про чужие данные и решения. Anthropic собрала в отдельный блок запрет на обманные кампании: фабрики фейковых аккаунтов, искусственное усиление мнения, сети будто бы независимых сайтов с одним заказчиком. Запрет распространяется и на инструменты для таких кампаний. По словам компании, большая часть этих ограничений уже существовала в разных разделах, теперь их сгруппировали. Если агент массово пишет отзывы под выдуманными персонами, проблема не исчезнет оттого, что текст сочинил Claude.
Правила выборов стали точнее: запрещён обман избирателей и вмешательство в процедуру голосования. При этом снят прежний общий запрет на персонализированные обращения к избирателям, мешавший, например, добросовестным организациям готовить информацию на разных языках. Остались ограничения на ложную атрибуцию, обман и злоупотребление личными данными. Это важная разница: «всё политическое на Claude запрещено» было бы неверным пересказом новой редакции.
Ещё конкретнее прописали оружие и слежку. Под запретом и программы управления оружием, а не только текстовые инструкции по его изготовлению. Нельзя собирать с помощью Claude инструменты слежения за людьми без согласия, в том числе для анализа старых записей; есть оговорки для согласованного мониторинга, исследований и журналистики. Anthropic описывает многие из этих изменений как уточнение уже действовавшей практики, а не внезапное разрешение раньше запрещённого.
Нужно ли обновлять своего агента? Вопрос полезнее спора о чувствах Claude. Я бы начал с простой инвентаризации: какие действия он совершает через браузер и инструменты, какие решения принимает о конкретных людях, какие данные читает, кто может остановить его, если автоматизация ошиблась. Никакой новой команды установки тут нет: меняется договорная рамка сервиса, поэтому проверять надо реальный процесс.
Где нужен человек, а где достаточно черновика
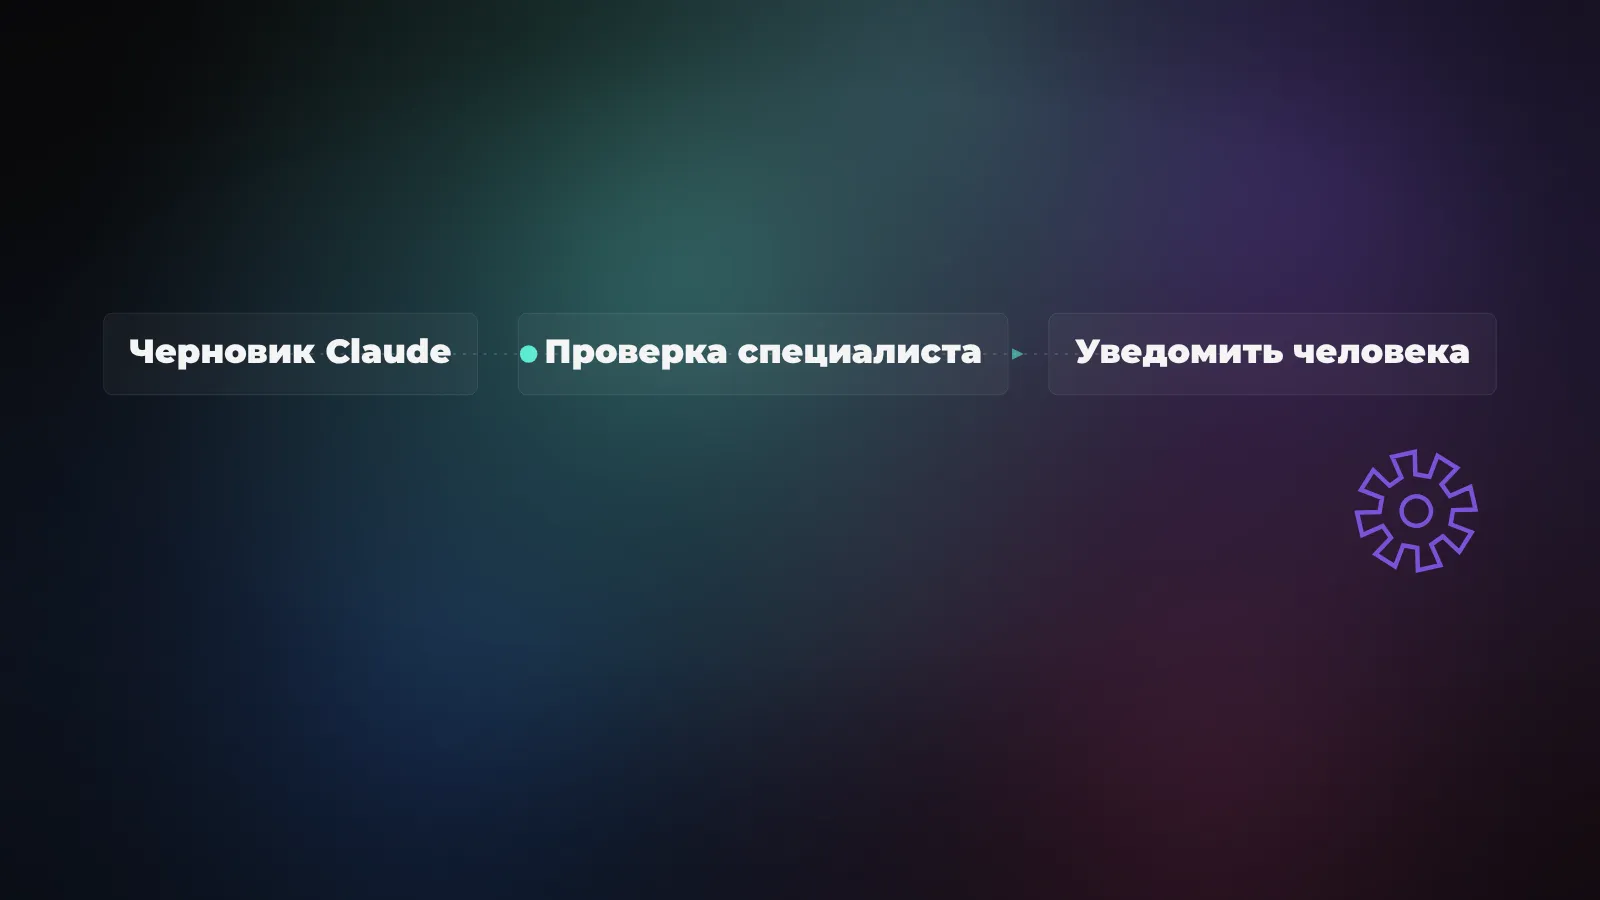
Если Claude рекомендует конкретному человеку лечение, оценку кредита, приём на работу или другое решение из перечня высокорисковых, политика требует квалифицированного человека, способного содержательно проверить и изменить рекомендацию до её выдачи или применения. Затронутому человеку надо сообщить, что использовали ИИ. В обновлении эти обязанности расписаны подробнее, но сама компания говорит, что общая логика «человек в контуре» существовала и раньше.
Допустим, агент сортирует письма кандидатов по дате поступления и даёт рекрутеру удобную таблицу. Это похоже на подготовку материала. А если он сам ранжирует людей по пригодности и посылает отказ, уже возникает вопрос о высокорисковой рекомендации. В тексте правил есть исключения для внутреннего черновика, исследования и действий по заранее принятому человеком решению, когда модель не судит конкретного человека. Граница проходит по функции системы, а не по красивому названию «помощник HR».
Для оборудования появился ещё один набор условий. Если модель без предварительного одобрения человека управляет физическим устройством, способным причинить вред, оператор должен видеть работу и иметь возможность остановить её. При потере связи устройство обязано безопасно остановиться или удерживать безопасное состояние; ограничения силы, скорости и прочих опасных параметров должны работать независимо от вывода модели. Умная лампа и промышленный манипулятор здесь явно не один класс риска. Планы и команды, которые квалифицированный человек проверяет до исполнения, политика отдельно отличает от автономного действия железа.
Что я бы проверил сегодня
Для личного чата вывод скучный: ругаться на ошибку можно, повторяющаяся бессмысленная травля рискует закончиться остановкой разговора. С 12 ноября соответствующий пункт появится и как формальный запрет в условиях использования. Числового порога Anthropic не опубликовала, обещания мгновенных массовых банов тоже нет. Мне ближе простая привычка: если модель ошиблась, дай ей воспроизводимый пример ошибки. Такой диалог и полезнее, и не превращает работу в бессмысленную перебранку.
Для команды, которая встроила Claude в сервис, я бы прошёл по трём цепочкам. Первая: сообщения и публикации наружу - от чьего имени и с какой маркировкой они идут. Вторая: решения о людях - где именно человек проверяет результат до применения. Третья: инструменты и физические устройства - может ли агент сделать действие, которое не успеют остановить. Отдельно проверь, что пользователь внешнего чат-бота видит, что разговаривает с ИИ: новая политика требует раскрывать это в интерфейсе или в начале сеанса.
Подводный камень для владельца бизнеса: правила касаются и агентов, которых ты собрал поверх API. В последнем разделе Usage Policy сказано прямо: пользователь отвечает за действия таких агентов через браузеры, инструменты и подключённые системы. Скрипт на автопилоте не переводит ответственность на модель. Если хочешь пройтись по практическим границам, есть отдельный разбор о том, можно ли доверять агенту в бизнесе. Горячую новость я бы прочитал как повод проверить собственные полномочия и точки остановки, а не как требование говорить с Claude ласковым голосом.
Источники
- Anthropic: анонс изменений от 8 октября и дата вступления в силу
- Anthropic: полная редакция Usage Policy с 12 ноября 2026 года
- Anthropic: архив прежней редакции Usage Policy
- Anthropic: как Claude завершает редкие разговоры, исследование 2025 года
- The Verge: репортаж о новом ограничении
- TechCrunch: разбор объявления и прежнего механизма завершения чата
- The Guardian: нет точного публичного определения «жестокости»