10 сентября 2026 г.
Языковую модель обучили с нуля за $998: что это значит

Инженер Юго Верньес обучил языковую модель на 3,8 миллиарда параметров полностью с нуля за $998 и выложил все чеки: железо, данные, время, каждое решение. Семь лет назад обучение GPT-2 стоило десятки тысяч долларов. Это не значит, что дома собирается ChatGPT - но регион между «игрушкой на ноутбуке» и «нужна целая лаборатория» стал доступен обычному инженеру.
Я разберу этот отчёт по частям: что именно сделали, много ли это по меркам моделей, куда утекла тысяча долларов и почему такое вообще стало возможно только сейчас. И главное - что из этого следует для тебя, если ты строишь что-то на ИИ, а не пишешь научные статьи.
Что именно сделали
Одна модель, 3,848 миллиарда параметров, обучена с чистого листа - не дообучена поверх чужой, а именно с нуля. Считалось всё на восьми видеокартах NVIDIA B200, взятых в аренду в облаке. Обучение заняло 43 часа реального времени, модель прошла через 65,3 миллиарда токенов текста. Итоговый счёт за вычисления - $998.
Архитектура - обычная по нынешним меркам, в стиле Llama: RMSNorm, RoPE, GQA (24 головы внимания на запрос и 8 на ключи-значения), relu²-блоки вместо привычных, QK-нормализация. Никакой экзотики, всё это описано в открытых работах. Данные - открытый датасет NVIDIA Nemotron-ClimbMix, токенизатор от старого доброго GPT-2.
Важная деталь: это базовая модель. Она умеет продолжать текст и решать задачки на понимание, но это не отполированный чат-бот в духе ChatGPT. До состояния «поговорить» её ещё надо доводить отдельными этапами, которые в эту тысячу долларов не входят.
CORE 0.384 - это много или мало
Качество мерили по бенчмарку CORE. Это не один тест, а агрегат из 22 задач на понимание языка (там и HellaSwag, и ARC) из набора DCLM, который собирали Стэнфорд, Apple и ещё два десятка институтов. Проще говоря, CORE - это усреднённая оценка, насколько модель «соображает» на широком наборе заданий. Чем ближе к единице, тем лучше.
Наша модель набрала 0.384. Чтобы понять масштаб: GPT-2 на 1,5 миллиарда параметров - та самая, которую OpenAI в 2019 году сначала побоялась выкладывать целиком - даёт по этому же бенчмарку 0.2565. То есть модель за тысячу долларов уверенно обходит легенду семилетней давности.
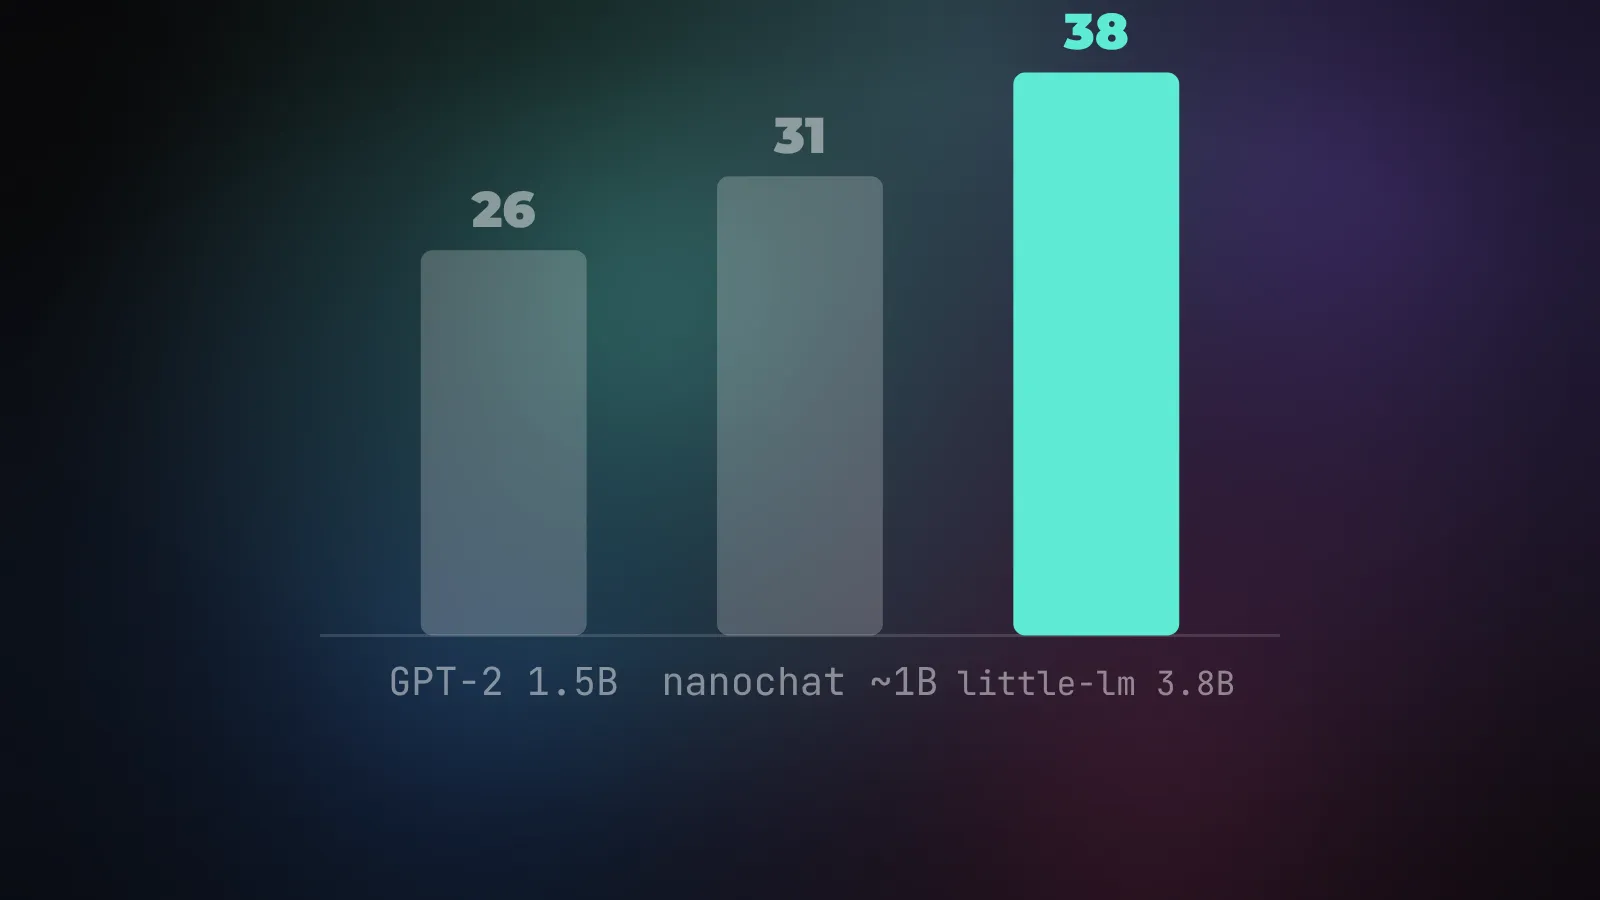
Для сравнения из той же весовой категории: nanochat - учебный проект Андрея Карпаты, «лучший ChatGPT за $100» - на модели около 1 миллиарда параметров и восьми H100 даёт CORE примерно 0.310 тоже за сумму порядка тысячи долларов. Наша модель крупнее и вытягивает выше. Разброс небольшой, но он показывает: за одни и те же деньги результат уже зависит от того, насколько аккуратно ты собрал рецепт.
Куда ушла тысяча долларов
Почти весь счёт - это аренда видеокарт. Восемь B200 в облаке, 43 часа, и вот твои $998. Никаких зарплат, лицензий и своего дата-центра. Данные бесплатные и открытые, код - тоже открытые наработки сообщества. Отсюда и вся экономика: платишь только за часы на чужом железе.
Дальше начинается инженерия, которая позволила уложиться в бюджет, а не спалить в три раза больше. Автор перечисляет решения честно, и почти каждое - это способ выжать больше токенов в секунду из тех же карт:
- FP8-вычисления вместо более тяжёлых форматов - плюс 33% к скорости.
- relu²-блоки вместо привычных gated-MLP - два умножения матриц вместо трёх.
- Слитая функция потерь, чтобы не хранить в памяти гигантский тензор логитов целиком.
- Оптимизатор Muon для матриц - сходится лучше, чем один AdamW.
- Трапециевидное расписание скорости обучения вместо косинусного - модель продолжает учиться и на последней половине пути.
- Короткий контекст на обучении - 1024 токена вместо 2048, чтобы каждый шаг считался быстрее.
Почему это стало возможно только сейчас
В 2019 году обучение GPT-2 обошлось примерно в $43 000. Спустя семь лет сопоставимую по бенчмарку модель делают за тысячу с небольшим - это примерно в сорок раз дешевле. И дело не только в том, что железо подешевело.
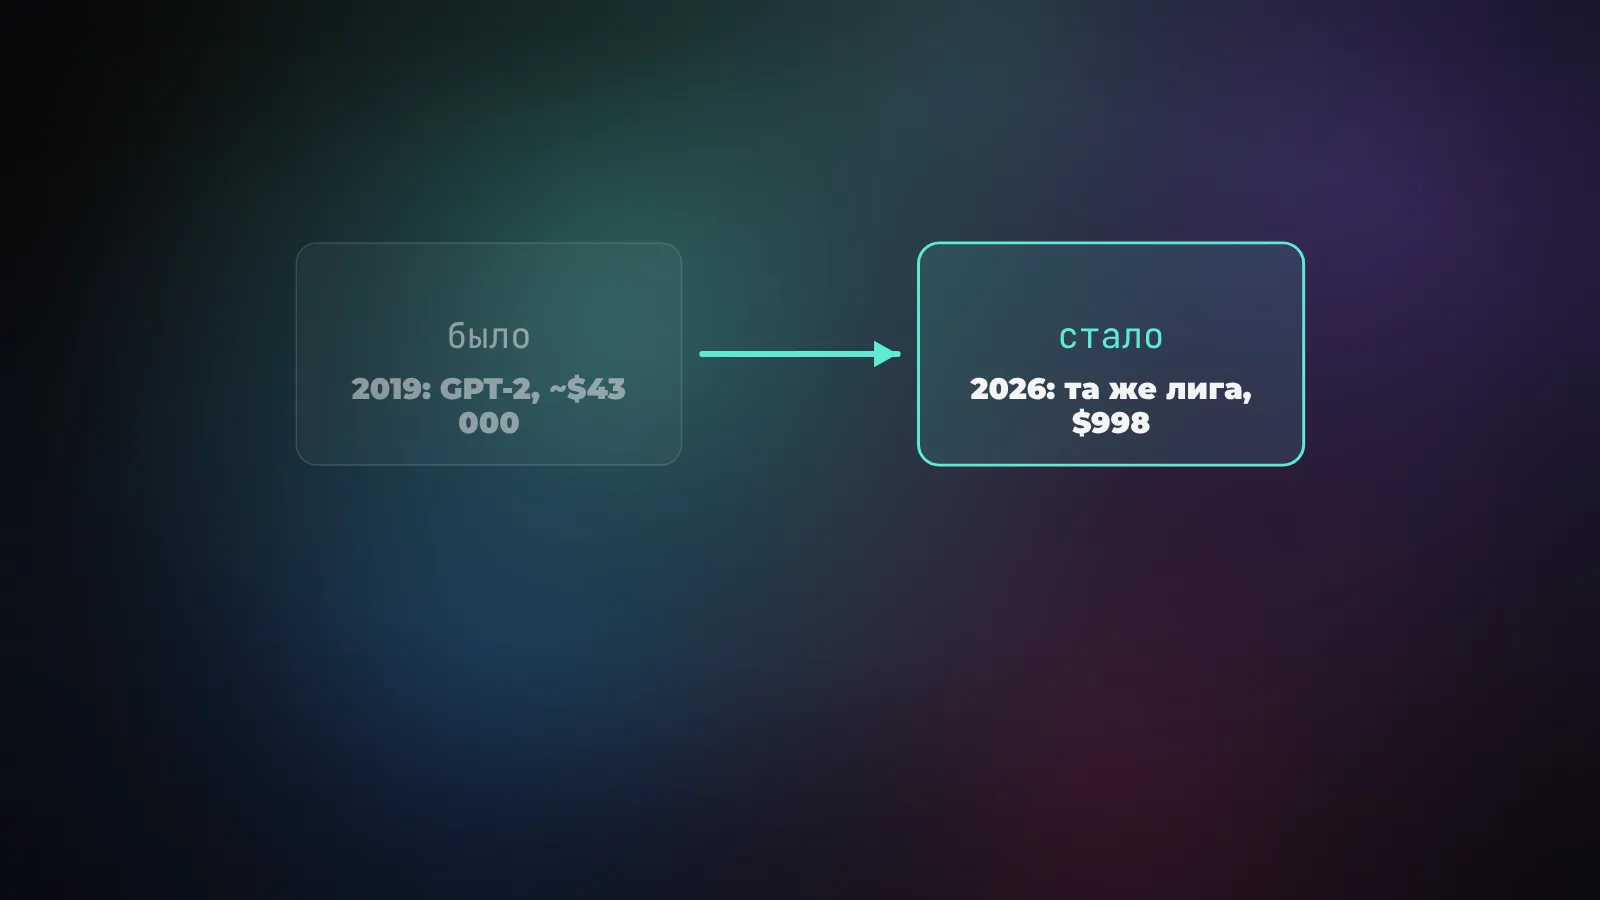
Сложились сразу несколько вещей. Видеокарты стали в разы быстрее на ватт и на доллар. Появились открытые рецепты - те самые FP8, Muon, современные архитектурные приёмы, которые раньше жили только внутри лабораторий, а теперь лежат в открытых репозиториях. И, что важнее всего, стали доступны чистые датасеты вроде DCLM и ClimbMix: на хороших данных модель учится тому же самому за куда меньшее число токенов.
Сам автор сформулировал это точнее всего: «Где-то между игрушечным nanoGPT и полноценной исследовательской лабораторией есть большая, плохо описанная область». Именно в неё за последние пару лет и провалилась цена входа. Раньше про обучение своей модели с нуля даже думать не стоило без гранта или инвестора. Сейчас это выходные и цена хорошего смартфона.
Что такая модель умеет и чего не умеет
Давай честно, чтобы ни у кого не было иллюзий. Базовая модель на 3,8 миллиарда параметров с CORE 0.384 - это не замена ChatGPT, Claude или даже приличной открытой модели вроде Qwen. Она не будет писать за тебя код, вести длинные диалоги и держать сложные инструкции. По уму она где-то на уровне 2019 года, просто собрана дёшево и быстро.
Зато она реально твоя. Ты знаешь про неё всё: на каких данных обучена, как устроена, что внутри. Её можно дообучать под узкую задачу, разбирать по косточкам, ставить эксперименты - без облака, подписки и чужих правил. Для обучения, исследований и специфических нишевых применений это ценно именно потому, что модель прозрачная и управляемая.
Что из этого следует для тебя
Главный вывод не про то, что все побегут обучать модели. Побегут единицы. Вывод в другом: планка «сделать самому» падает быстрее, чем кажется. То, что вчера требовало лабораторию, сегодня делает один человек за выходные, а завтра будет ещё дешевле.
Для тех, кто строит на ИИ, это меняет расчёт. Своя маленькая модель под узкую, повторяющуюся задачу перестаёт быть фантастикой - в каких-то случаях это уже дешевле и предсказуемее, чем годами платить за API. А ещё это отличный способ наконец понять, как эти модели устроены изнутри: пока не собрал сам, всё кажется магией. И чем ниже цена входа, тем меньше причин оставлять это понимание другим.
Не бросайся обучать модель с нуля завтра - для большинства задач это лишнее. Но держи в голове: регион между «игрушкой» и «лабораторией» открыт, и цена в нём падает на порядок каждые несколько лет. Тот, кто это понимает раньше других, получает фору.