16 ноября 2026 г.
Qwen4-Max: как попробовать новую модель и сколько стоит её API

Qwen4-Max - новая облачная модель Alibaba для текста, изображений и длинных агентных задач. Попробовать её можно через сервисы Qwen или API QwenCloud; скачать именно Max и запустить дома пока нельзя. Если выбираешь модель для работы, начни с одного контрольного задания и сравни полный счёт. Красивые цифры о стоимости задачи из анонса пока принадлежат самому разработчику.
Поводом стал сегодняшний релиз и американский тренд по запросу «qwen4». Но мне интереснее практическая часть: в анонсе Alibaba рядом стоят дешёвый кэшированный вход и обещание снизить стоимость задачи. Легко прочитать это как «любая работа стала дешёвой». Там есть существенная оговорка.
Что именно вышло
Alibaba объявила Qwen4-Max 16 ноября 2026 года. Это флагманская мультимодальная модель: принимает текст и изображения, понимает видео, отвечает текстом. В карточке QwenCloud отдельно перечислены вызовы инструментов, структурированный вывод и поиск. То есть она годится для кода, анализа документов и агентных цепочек, а не только для разговора в чате.
В анонсе фигурируют QwenCloud с Token Plan и API, а также QwenWork и QwenStudio. Это разные способы доступа, и условия для учётной записи могут различаться. Я бы начал с доступного тебе интерфейса Qwen, если хочу просто оценить ответы; для интеграции в приложение нужна платформа с ключом API. Доступность конкретного сервиса и методы оплаты лучше проверять в своём регионе непосредственно перед регистрацией: новость о глобальном релизе сама по себе не обещает одинаковую регистрацию из каждой страны.
Самый частый подвох уже в названии. Qwen4-Max сейчас описана как облачная модель. Alibaba обещает позже выпустить меньшие модели семейства Qwen4 с открытыми весами. Это обещание о других моделях, а не ссылка на загрузку Max. Если тебе нужен локальный запуск без облака, общий обзор Qwen поможет сориентироваться в семействе, но не превращает нынешний Max в файл для Ollama.
Что означают триллионы параметров
У Qwen4-Max 2,4 триллиона параметров всего, но на один токен активируются 71 миллиард. Механизм называется Mixture-of-Experts: система направляет конкретный фрагмент запроса к части большой модели. Всю сеть хранить и обслуживать всё равно нужно; активное число относится к вычислению в одном шаге, а не к объёму скачиваемого файла. Поэтому вывод «поместится на обычный ноутбук, ведь работает только часть» был бы ошибкой.
Alibaba говорит, что обновила не один изолированный блок, а компоненты архитектуры, включая внимание, остаточные связи и представления токенов. По словам компании, при том же общем масштабе Qwen3.8-Max активная часть стала меньше, а результаты улучшились. Проверить это по одному красивому ответу модели нельзя: нужны одинаковые задания, инструменты и бюджет для обеих версий. С архитектурой полезно разобраться, чтобы не путать скорость инференса с «размером мозга», но для покупателя API важнее реальная стоимость завершённой работы.
Контекст в модельной карточке обозначен как 1 миллион токенов; максимальный ввод указан чуть ниже этой круглой цифры, отдельно оговорены лимиты вывода и режима размышления. Это потолок интерфейса, а не гарантия точного ответа по книге длиной в миллион токенов. Я бы всё равно давал модели конкретные страницы или фрагменты с проверяемыми ссылками на документы вместо выгрузки целой базы «на всякий случай».
Сколько реально стоит API
Для выбранного в карточке QwenCloud региона Singapore указаны $1,50 за миллион обычных входных токенов и $4,50 за миллион выходных. В анонсе встречается куда более эффектное $0,075 за миллион входных, но только при попадании в implicit cache. Это повторно используемый префикс запроса, а не тариф для каждого нового текста. Если отправлять каждый раз уникальные большие документы, считать все входящие токены по кэш-цене нельзя.
Возьмём условный вызов: 100 тысяч входных токенов и 20 тысяч выходных. При обычном входе и без других опций по опубликованной ставке счёт будет меньше четверти доллара. Если весь вход удовлетворит условиям дешёвого кэш-чтения, он будет меньше одной десятой доллара. Это две границы иллюстрации, не обещание счёта за твою сессию. В реальности часть префикса может не попасть в кэш, а действия агента порождают дополнительные запросы. У QwenCloud отдельно тарифицируется создание явного кэша, поэтому проверяй детальный счёт, прежде чем строить экономику продукта на одном рекламном числе.
Alibaba утверждает, что в её собственном Work360 при режиме High effort Qwen4-Max тратит на 35% меньше токенов и снижает среднюю стоимость задачи примерно на 60% относительно Qwen3.8-Max. Тест, как пишет компания, охватывает 721 профессиональную область. Я не видел независимого воспроизведения Work360 на своих рабочих запросах. Эти проценты нельзя механически переносить на написание твоих писем, программ или анализ таблиц. Важно и то, что «стоимость задачи» включает поведение модели, а не только цену миллиона токенов.
Как попробовать без смены всей системы
Если нужен ответ в чате, сначала проверь наличие Qwen4-Max в доступном тебе интерфейсе из перечня Alibaba. Подготовь вопрос с исходным документом и критериями проверки: например, извлечь из счёта позиции, итог и указать строки, где сумма не сходится. Дай этот же документ старой модели и сравни найденные расхождения вручную. В публичный сервис не стоит отправлять клиентские документы без права на такую передачу.
Для разработчика есть конкретный маршрут. В официальном быстром старте приведены OpenAI-совместимый клиент, ID модели qwen4-max, переменная окружения DASHSCOPE_API_KEY и адрес API для Singapore: https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1. Создай ключ в том же регионе, что и адрес API; выбор региона в консоли сам по себе не меняет URL в твоём коде. Сначала настрой ограничение расходов, затем сделай один короткий запрос и проверь, что ответ пришёл от ожидаемой модели.
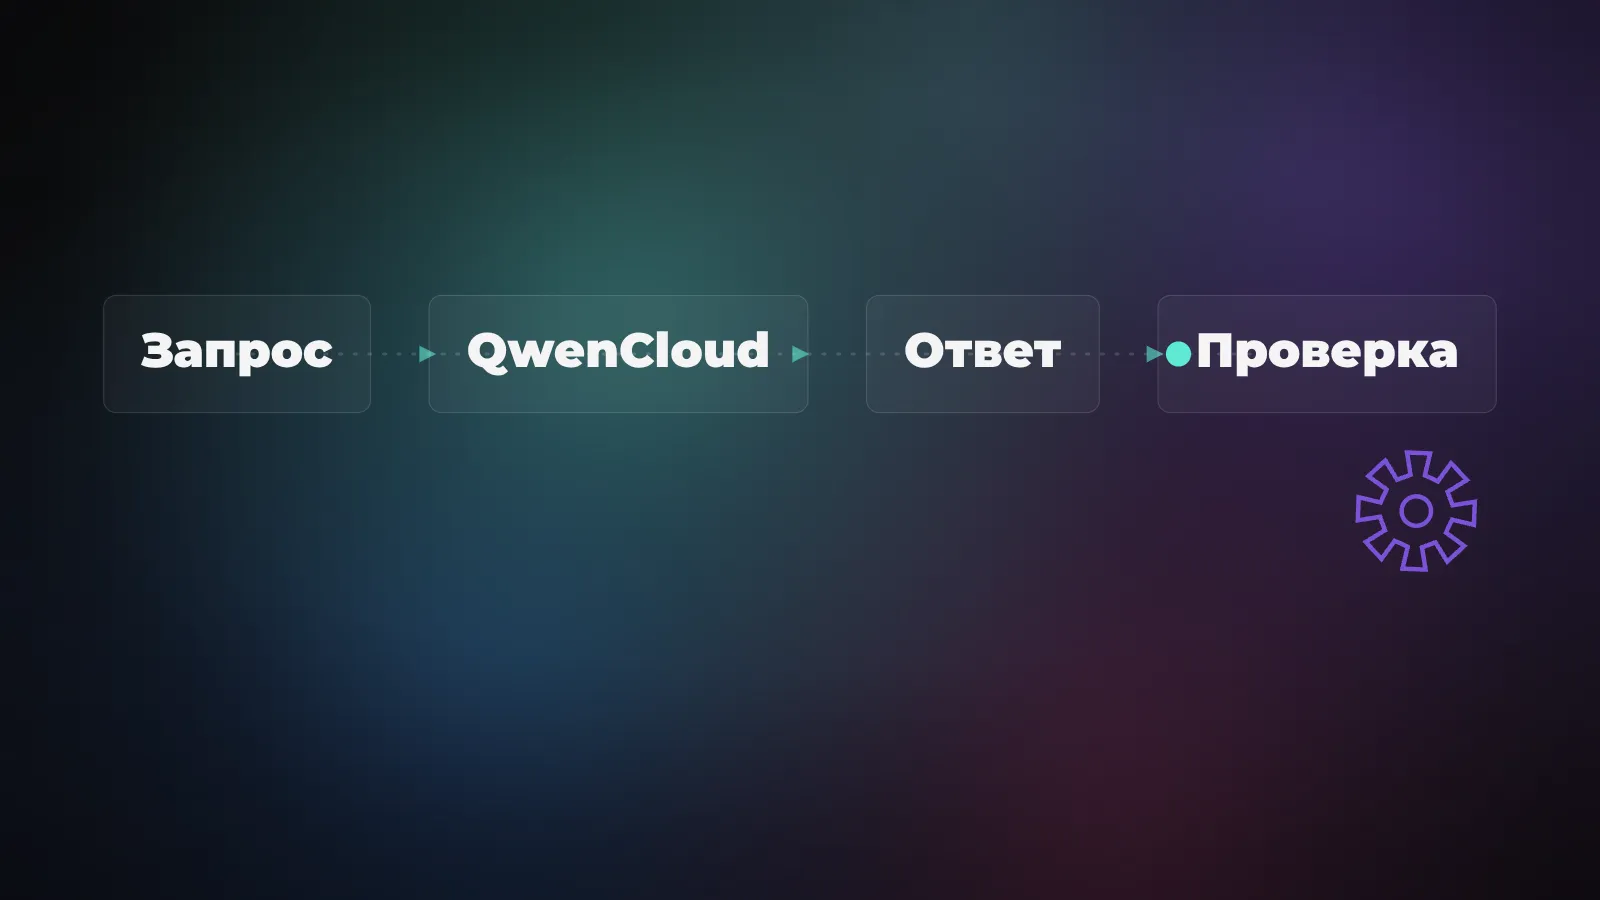
Я здесь не исполнял платные вызовы Qwen4-Max и не буду показывать придуманный «мой тест». Проверку лучше делать на своей понятной задаче. Для кода это может быть небольшой баг с тестом; для работы с документом - таблица, где ты заранее знаешь правильную сумму и место ошибки. Сохрани одинаковые исходные данные и инструменты для сравниваемых моделей. Иначе можно принять эффект лучшей подсказки или внешнего поиска за эффект новой модели.
Чему верить в сравнительных тестах
В собственном анонсе Alibaba приводит места в рейтингах, профессиональные задачи и промышленный пример сокращения времени подготовки программы для обработки детали. Это демонстрации разработчика на отобранных условиях. Их можно использовать как повод для собственного теста, но нельзя выдавать за обещание такого же результата в твоей компании. Особенно если в цепочке есть реальные станки, документы или деньги.
Есть и отдельный взгляд: Artificial Analysis опубликовала измерения Qwen4 Max. На момент проверки модель получила 43 балла по их Intelligence Index; их расчётная стоимость задачи составила $3,27. Это их набор тестов и расход токенов, а не средняя цена любой твоей задачи. Показатель контекста у них записан как 984 тысячи токенов, у QwenCloud - округлённый миллион; перед длинным запросом ориентируйся на действующие ограничения своего API, а не на маркетинговую запись.
Меня в таких сравнениях прежде всего интересует, что именно оценивали. Два сервиса могут дать одной и той же модели разные инструменты: одному разрешён поиск, другому - только голый ответ. Тогда таблица сравнивает уже не одну модель, а целые рабочие связки. Попроси обе системы решить один и тот же пример, сохрани исходный текст и проверь конкретный результат. Для кода - запускаются ли тесты и не появились ли побочные правки. Для документов - откуда взято каждое важное число. Для агентного процесса - сколько было попыток и не совершены ли действия без согласования. На маленькой выборке нельзя объявить победителя вообще, зато можно обнаружить проблему, которая тебе обойдётся дороже любого тарифа.
И ещё я бы разделял тест качества и тест экономики. Первый отвечает, можно ли доверить результату выбранную задачу; второй - сколько стоят все повторные попытки при приемлемом качестве. Когда сравниваешь прайс из карточки модели с чужим рейтингом, это два разных измерения. Сводить их в одно «цена/ум» удобно для заголовка, но решение о миграции лучше принимать по своим логам.
Мой вывод приземлённый: Qwen4-Max стоит проверить, если ты уже сравниваешь облачные модели для сложных задач и умеешь измерить расход на полный сценарий. Начать проще с контрольного примера, затем посмотреть на счёт и ошибки. Если твою обычную работу решает более дешёвая модель, новости о триллионах параметров не требуют срочной миграции.