28 августа 2026 г.
Почему у нейросети 51 миллиард параметров памяти, а «думает» она шестью
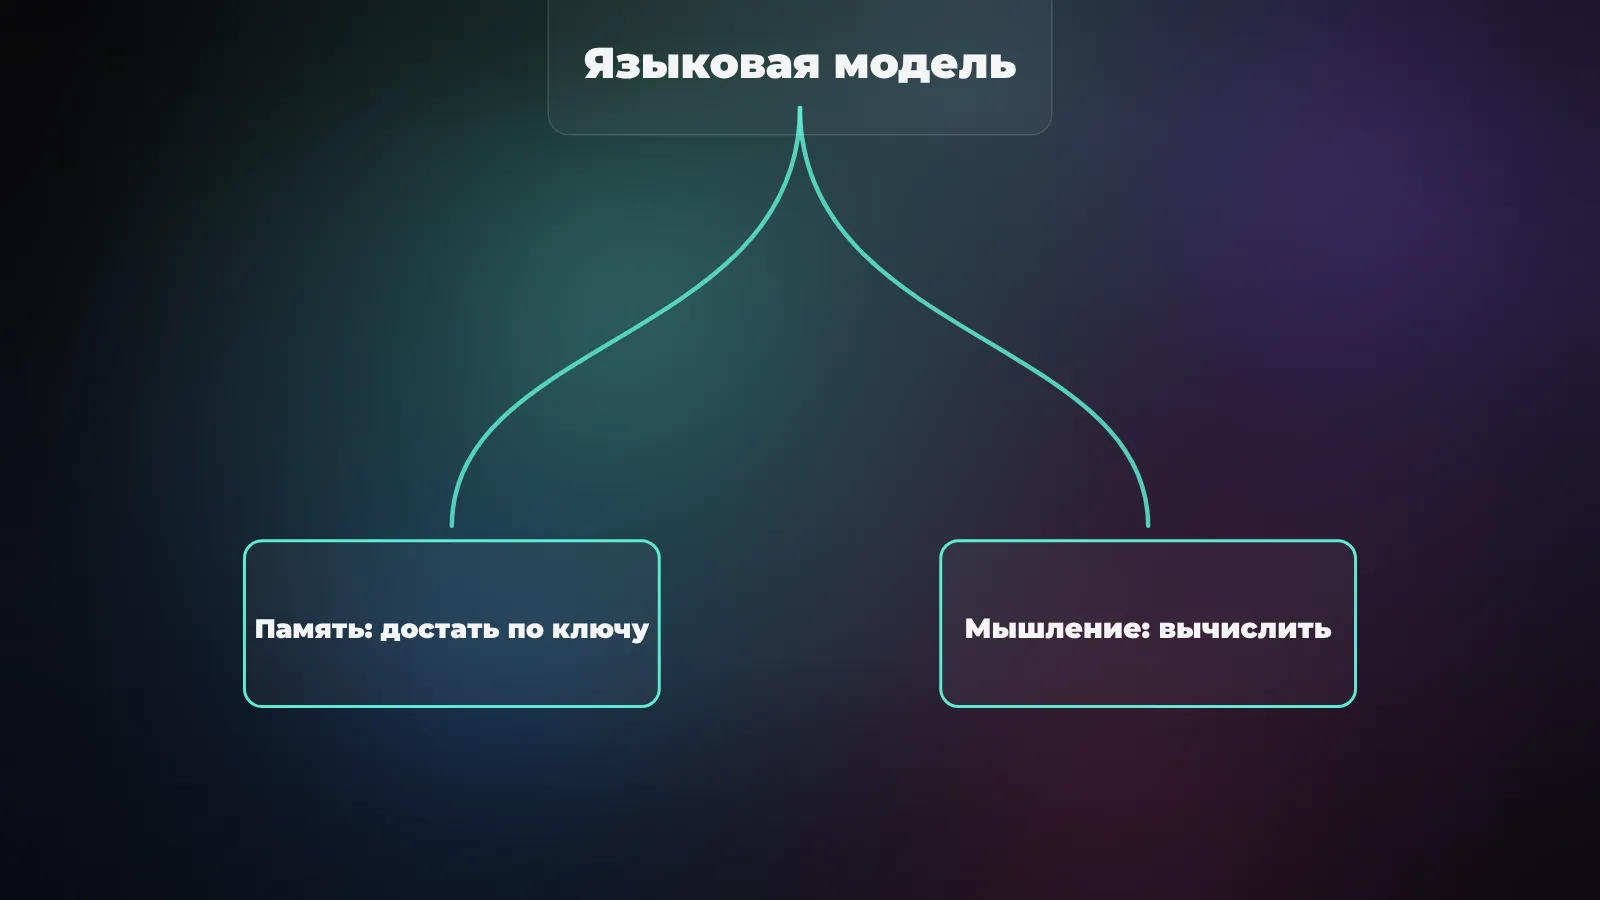

Современные нейросети перестали держать все знания «в голове». Часть параметров - как пишутся имена, шаблонные обороты, устойчивые словосочетания - выносят в отдельную таблицу-память: модель не пересчитывает их каждый раз, а достаёт готовыми по ключу за один шаг, без вычислений. Поэтому у модели могут быть десятки миллиардов параметров, а работать на каждый ответ будет лишь малая их часть.
Звучит абстрактно, но за этим стоит практический сдвиг. Он объясняет, почему свежие открытые модели заявляют гигантские размеры, но не требуют столько же видеопамяти, - и заодно хоронит популярный миф, будто теперь терабайтную модель можно гонять дома прямо с диска. Разберём по порядку: что это за память, откуда взялась идея и что она реально меняет для того, кто запускает модели локально.
Что нейросеть считает заново каждый раз
Внутри языковой модели есть два типа слоёв. Слои внимания решают, какие слова в тексте связаны между собой. А между ними стоят полносвязные слои (feed-forward) - и именно они делают бо́льшую часть чёрной работы.
Ещё в 2021 году исследователи Мор Гева и коллеги показали простую вещь: эти полносвязные слои по сути работают как память формата «ключ - значение». Нижние слои ловят поверхностные, почти механические паттерны - как пишется слово, какое продолжение у устойчивой фразы. Верхние - смысловые. То есть заметная часть глубины сети уходит не на рассуждение, а на пересборку статических фактов, которые в принципе не меняются.
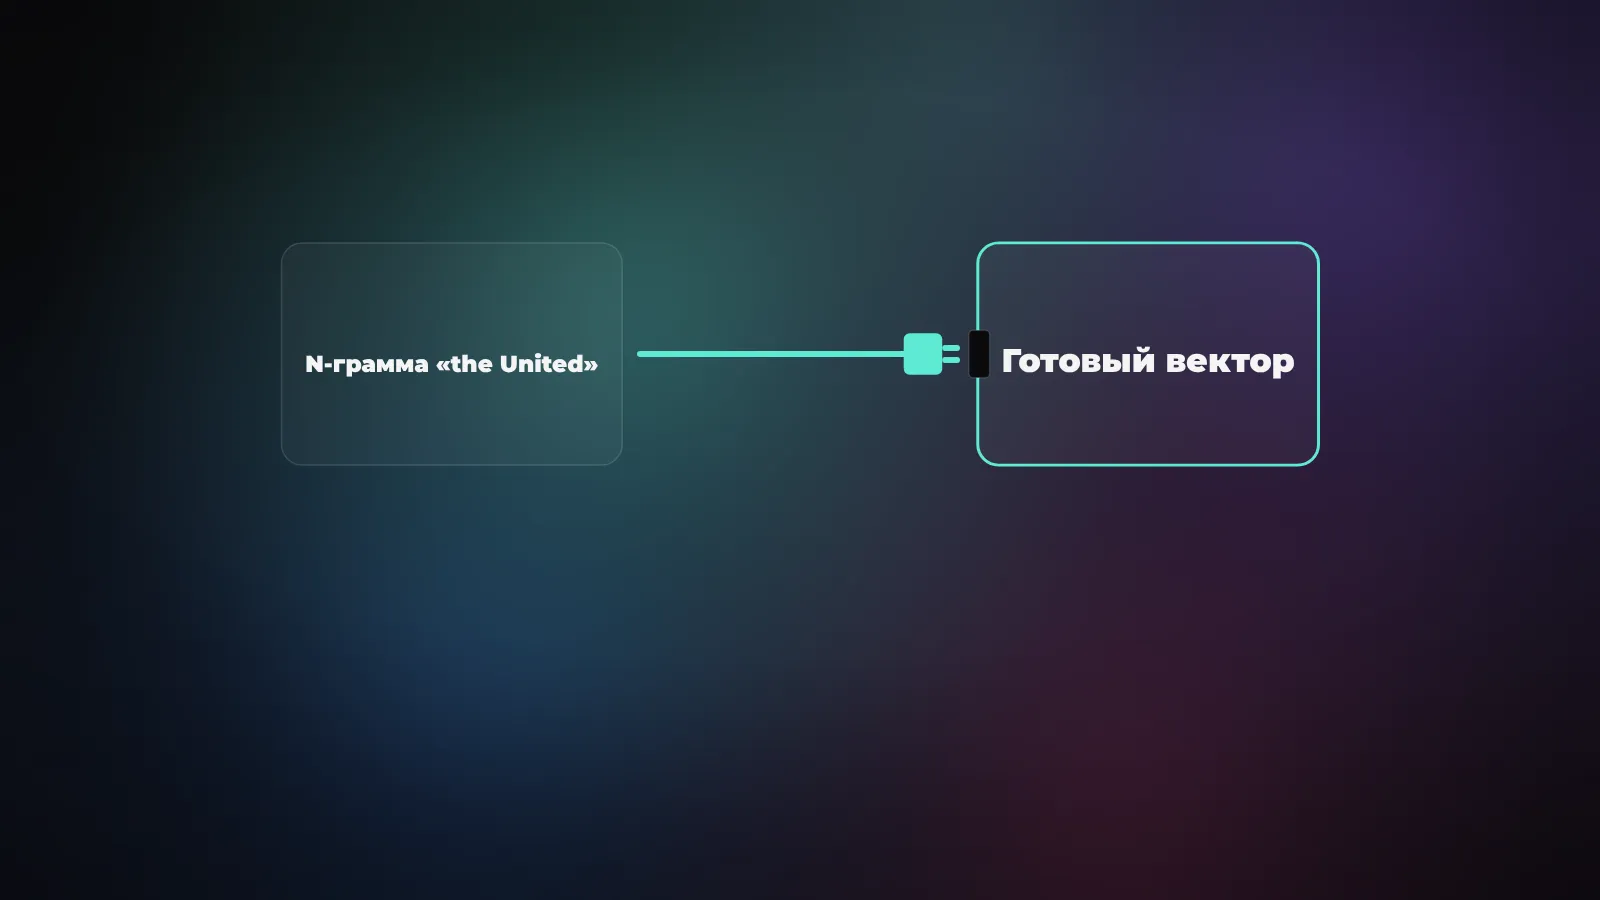
Пример из обсуждения этой архитектуры. Когда модель видит «the United», она с высокой вероятностью достраивает «States». Это не мышление - это зубрёжка. Но сеть каждый раз честно прогоняет эти токены через свои вычислительные слои, тратя на очевидное ровно те же ресурсы, что на сложную логику.
Память как таблица: достать вместо того, чтобы вычислять
Отсюда родилась идея: раз статику всё равно надо помнить, зачем её вычислять? Положим её в отдельную таблицу и будем доставать по индексу.
Это и есть memory layers - слои-память. В декабре 2024 года команда Meta FAIR выпустила работу «Memory Layers at Scale»: они добавили модели обучаемую таблицу «ключ - значение», куда складываются те самые статические знания. Читается такая таблица по индексу - как из словаря. Ты не перемножаешь матрицы, ты просто берёшь нужную строку. Никаких дополнительных вычислений (FLOPs) при этом не прибавляется, только память.
Ключ к строке можно строить хитрее, чем по одному слову. Ещё в 2019 году Гийом Лампль и коллеги предложили product-key memory: ключ собирается из двух под-ключей, и это позволяет держать до миллиарда ячеек памяти при почти нулевых накладных расходах. Результат тогда был показательный: модель на 12 слоёв с такой памятью обошла обычный трансформер на 24 слоя и работала вдвое быстрее.
Engram: приёму дали имя
В начале 2026 года команда DeepSeek оформила эту линию в отдельный приём и назвала его Engram (по нейробиологическому термину «энграмма» - след памяти в мозге). В их работе память индексируется не по одному токену, а по N-грамме - последним двум-трём токенам. «New York» получает свой вектор, «the United» - свой. Хэшируешь N-грамму, достаёшь вектор, отдаёшь его в сеть. Константное время, ноль вычислений.
Главная мысль DeepSeek - это новая ось разреженности. Раньше модели экономили одним способом: смесью экспертов (MoE), когда из большого пула «экспертов» на каждый токен включается лишь несколько. Engram добавляет второй способ: вынести статические знания в дешёвую по вычислению память. И дальше встаёт вопрос баланса - сколько параметров отдать под живое вычисление, а сколько под таблицу-память. У этого баланса даже нашли оптимум.
Свой Engram DeepSeek масштабировала до 27 миллиардов параметров и сравнивала честно - с моделью-смесью экспертов при равном числе параметров и равных вычислениях. По их замерам, память-таблица заметно вытягивает именно фактологию и поиск нужного куска в длинном контексте. Это, к слову, ровно то, что показала и Meta годом раньше: прирост сильнее всего заметен на фактических задачах.
«51 миллиард памяти, а думает шестью» - это не фокус
Теперь понятно, откуда берутся странные на вид цифры у новых открытых моделей. Возьмём Qwen3.8-Flash-Next, вышедшую в конце августа 2026. По данным разработчиков и первых обзоров, у неё около 125 миллиардов параметров всего, из них примерно 51 миллиард - тот самый N-граммный слой-память, а активно на каждый токен работает лишь около 6 миллиардов.
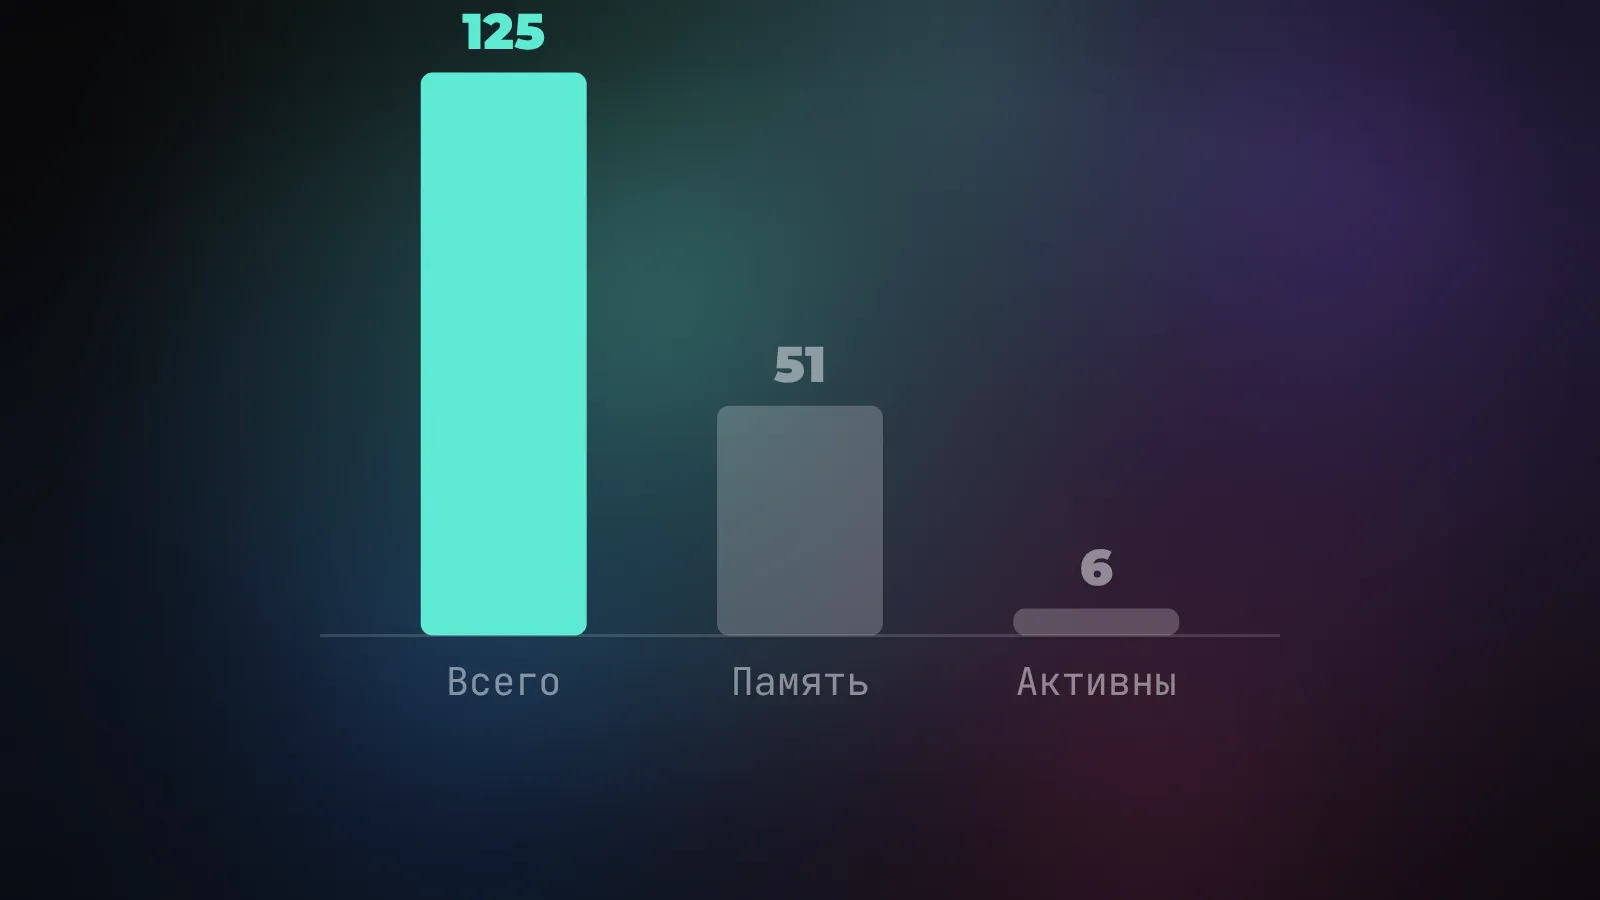
Разберём, что это значит. 6 миллиардов - это активное вычисление: внимание плюс включённые на этот токен эксперты. 51 миллиард памяти и остальной пул экспертов физически хранятся, но в расчёте каждого токена не участвуют - из них берут по индексу маленький кусочек. Отсюда и парадокс: по размеру модель солидная, а по нагрузке на каждый ответ - лёгкая.
Аналогия со смесью экспертов тут точная. У Qwen3-Next-80B-A3B в названии зашита та же логика: 80 миллиардов всего, 3 активны (A3B - «Active 3B»). Роутер выбирает несколько экспертов из сотен, остальные ждут своей очереди. Память-таблица - продолжение той же идеи, только вместо экспертов там готовые векторы фактов.
Нет, терабайтную модель с SSD ты не запустишь
Вокруг этого сразу пополз миф: раз память дешёвая и лежит отдельно, значит, можно выгрузить её на SSD и крутить дома хоть модель на триллион параметров. Тут надо честно разделить.
Активные веса - внимание и включённые эксперты - читаются на каждом токене. Их random-access с диска упрётся в скорость SSD и убьёт производительность. Гонять активную часть модели с диска по-прежнему медленно, и это никуда не делось.
А вот слой-память - другое дело. Он разрежённый: на токен из него читается крошечный кусок, буквально единицы килобайт. Именно поэтому его реально выгрузить из видеопамяти. Qwen, например, кладёт свой 51-миллиардный N-граммный слой не в дефицитную GPU-память, а в обычную системную RAM. Энтузиасты в обсуждениях сборок пошли дальше и показали, что при аккуратной реализации таблицу можно держать даже на быстром NVMe почти без потери скорости - потому что читать с неё нужно мало.
Вывод трезвый: «запустить всё что угодно с диска» - неправда для активных весов. Но именно память - та часть, которую действительно можно вынести из видеопамяти. Это не «терабайтная модель на домашнем ПК», это «модель влезает в меньший объём VRAM, потому что половина её веса лежит в другом месте».
Что это меняет для локального запуска
Практический смысл в трёх вещах.
Первое - меньше видеопамяти под активную часть. Дефицитный ресурс дома - это VRAM. Если половина параметров модели ушла в системную RAM или на диск, под то, что реально считается, нужно меньше видеокарты. Для домашней сборки это прямая экономия.
Второе - дешевле по вычислению при том же качестве. Память отдаёт факты бесплатно по FLOPs, поэтому те же знания обходятся сети в меньшее число операций. Модель с памятью может тягаться с более «тяжёлой» плотной моделью, оставаясь легче в работе.
Третье, на перспективу - знания становятся отдельным, редактируемым слоем. Если факт живёт в строке таблицы, его теоретически можно точечно поправить или обновить, не переучивая всю сеть. Пока это больше направление, чем готовая кнопка, но направление важное: сегодня, чтобы обновить знания модели, её приходится дообучать целиком.
Стоит ли ждать этого дома
Если коротко - это не разовый трюк одной модели, а оформившийся приём, у которого уже есть и научный фундамент (Meta, DeepSeek, работы 2019-2024 годов), и первые крупные продуктовые применения. Логика простая и правильная: не заставляй сеть каждый раз вычислять то, что можно просто запомнить и достать.
Для практики вывод такой. Смотри на активное число параметров, а не на общий размер - оно честнее говорит, потянет ли модель твоё железо. И не верь заголовкам про «триллион параметров на ноутбуке»: с диска дёшево едет только память-таблица, а не то, чем модель реально думает. Зато именно за счёт этой таблицы модели вроде Qwen и начинают влезать туда, куда их размер, казалось бы, влезать не должен - и вот это уже не миф, а то, что можно скачать и попробовать самому.
Источники: Meta FAIR, «Memory Layers at Scale» (arXiv 2412.09764); Lample et al., «Large Memory Layers with Product Keys», NeurIPS 2019 (arXiv 1907.05242); Geva et al., «Transformer Feed-Forward Layers Are Key-Value Memories», EMNLP 2021 (arXiv 2012.14913); DeepSeek, «Conditional Memory via Scalable Lookup» / Engram (arXiv 2601.07372); карточка модели Qwen3.8-Flash-Next и обзоры (the-decoder, LMSYS), обсуждения GGUF-сборок Unsloth.