15 августа 2026 г.
Фильтры безопасности ИИ держатся на английском - смени язык, и они отваливаются
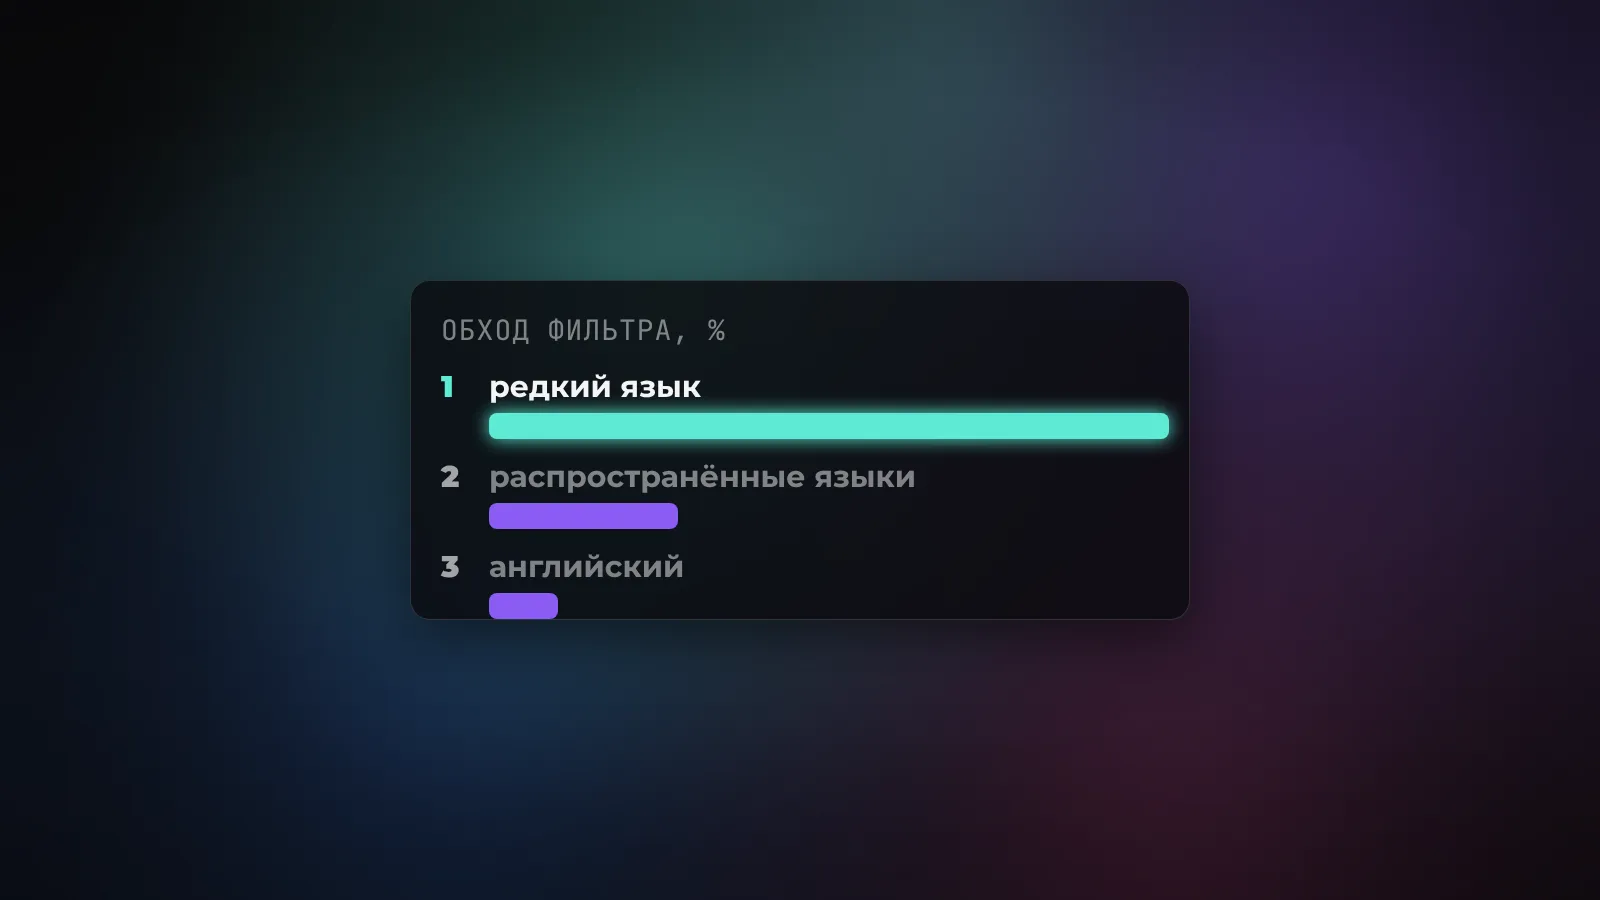

Фильтры безопасности ИИ держатся почти целиком на английском - переведи опасный запрос на редкий язык, и модель отвечает по существу там, где по-английски отказала бы, с успехом до 79%. Не потому что модель стала добрее, а потому что тормоз безопасности почти не натаскан на другие языки.
Касается не только исследователей джейлбрейков - это касается и любого, кто строит продукт на ИИ и думает, что встроенная защита работает одинаково для всех пользователей. Она не работает одинаково. Разбираюсь, что тут установленный факт, что свежие данные, и что с этим делать на практике.
Что вообще происходит
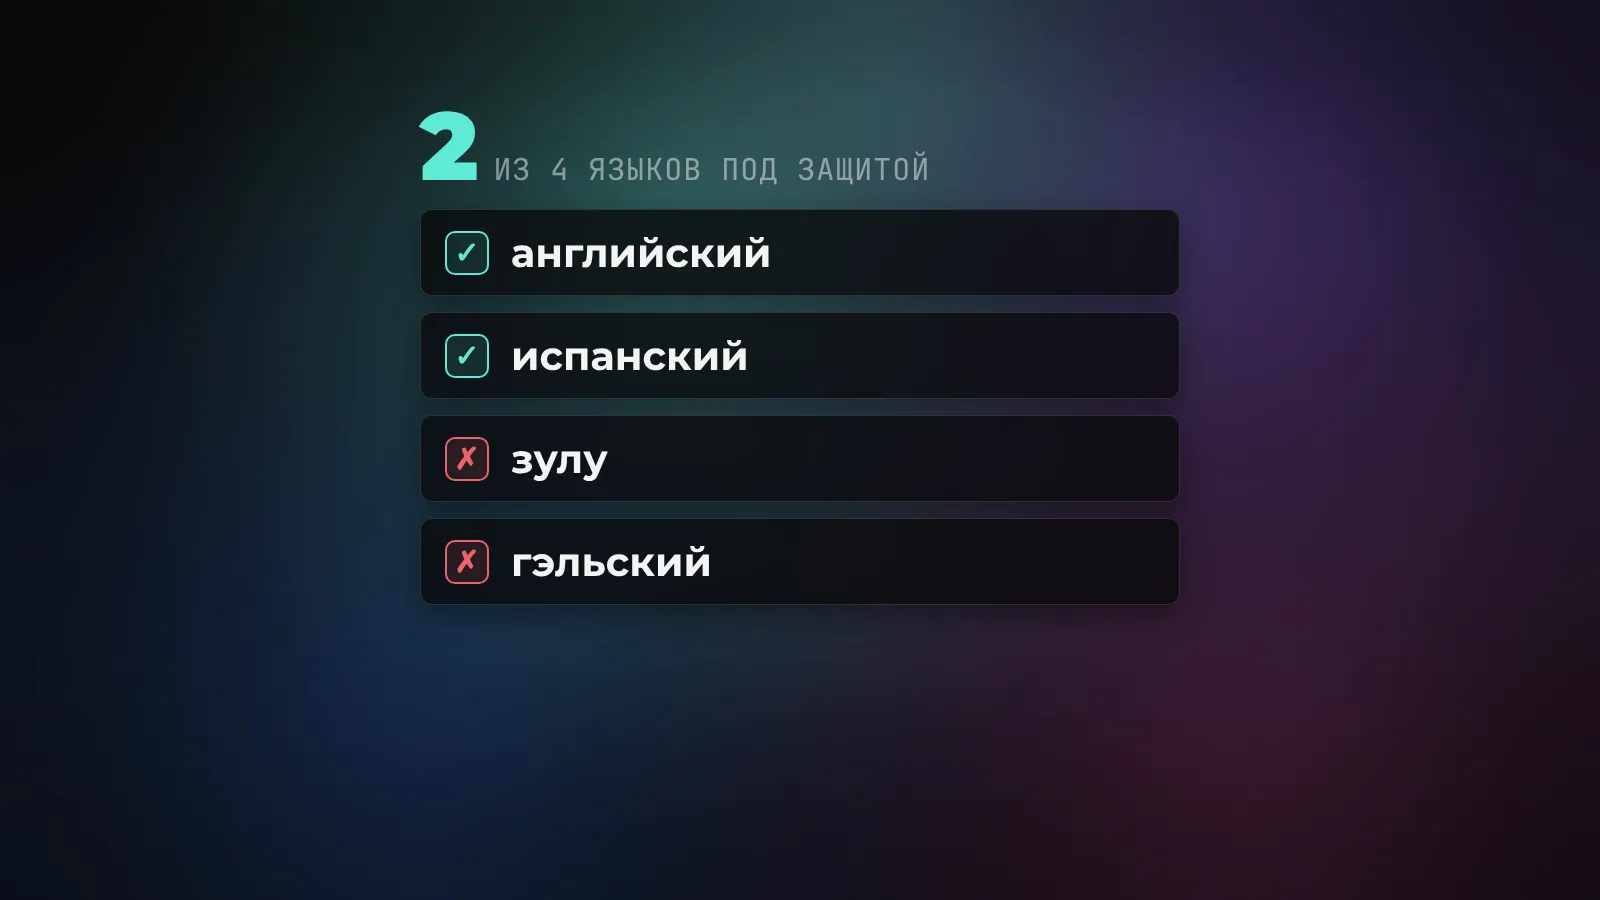
Ещё в 2023 году исследователи из Brown University показали неприятную вещь. Они брали запросы, которые GPT-4 гарантированно отклоняет по-английски, переводили их на низкоресурсные языки - вроде зулу или шотландского гэльского - и скармливали модели. Результат: модель включалась в опасный запрос и выдавала пригодный к делу ответ примерно в 79% случаев на стандартном наборе вредных промптов.
Для сравнения: на английском и других распространённых языках тот же набор запросов пробивал защиту в разы реже. То есть дело не в самих запросах, а именно в языке-обёртке. Ты не ломаешь модель хитрым промптом - ты просто говоришь с ней на языке, которого её служба безопасности толком не знает.
Тема не осталась разовым экспериментом. Появился отдельный бенчмарк MultiJail, где вредные запросы вручную перевели на десяток языков, чтобы измерять эту дыру системно. И вывод везде один: чем реже язык встречается в обучающих данных, тем слабее на нём защита.
Почему тормоз стоит только на английском
Чтобы понять, откуда дыра, надо посмотреть, как модели вообще учат отказывать. Базовая модель после предобучения одинаково охотно ответит и на безобидный, и на опасный вопрос - она просто продолжает текст. Отказываться её учат отдельно, на этапе выравнивания: показывают примеры вредных запросов и правильную реакцию, потом дошлифовывают через обратную связь от людей.
И вот здесь зарыта проблема. Эти обучающие примеры - подавляющим большинством на английском. Люди-разметчики, которые оценивают ответы, тоже в основном англоязычные. Сами правила безопасности и системные промпты компании пишут по-английски. В итоге модель заучивает связку "опасный смысл - отказ" в первую очередь на английской формулировке. Тот же смысл на суахили для неё - это уже другое статистическое соседство, где связки с отказом почти не выстроено.
Получается перекос: языковых знаний у модели много и на редких языках - она вполне понимает опасный запрос на зулу и способна дать по нему развёрнутый ответ. А вот знаний о том, что на такой запрос надо отказать, на этом языке почти нет. Понимание опережает безопасность. Это и есть корень дыры.
Что показали свежие исследования 2026 года
В 2025-2026 годах вышла первая большая работа, которая системно проверила не только атаки, но и защиты сразу на многих языках - десять языков, шесть моделей, два бенчмарка. Пара выводов оттуда отрезвляет.
Первый: методы защиты, которые придумывают против джейлбрейков, неплохо переносятся между разными моделями, но плохо переносятся между языками. То есть защиту откатали и показали, что она работает - но проверяли на английском, а на другом языке та же защита проседает. Дыру латают там, где светло, а не там, где потеряли.
Второй вывод контринтуитивный. В обычных, не атакующих запросах распространённые языки ведут себя безопаснее - там модель аккуратнее. Но под целенаправленной атакой именно эти языки иногда оказываются уязвимее. Хорошее владение языком не гарантирует хорошую защиту на нём: одно про способности модели, другое про то, чему её отдельно учили в плане безопасности, и эти две вещи разъезжаются.
Почему это касается тебя, даже если ты не ломаешь модели
Тут легко отмахнуться: ну обходят фильтры энтузиасты, мне-то что. А касается это напрямую любого, кто ставит ИИ внутрь своего продукта.
Смотри, где вылезает. Ты делаешь чат-бота поддержки, ассистента или агента на базе облачной модели. Твоя аудитория пишет по-русски - а русский, при всей распространённости, для англоцентричной защиты далеко не английский. Значит, вредный или манипулятивный запрос, который модель зарубила бы на английском, у тебя может пройти. Твой красивый "безопасный по умолчанию" ассистент безопасен ровно настолько, насколько защита модели дотянулась до твоего языка.
Второй сценарий - модерация. Многие ставят ИИ фильтровать пользовательский контент: отсеивать оскорбления, спам, опасные инструкции. Если этот фильтр натаскан в основном на английский, то мусор на других языках проезжает мимо. Злоумышленнику даже язык менять не надо - он и так пишет на языке, который твой фильтр разбирает хуже.
Третий, тихий - утечка через агентов. Чем больше ты даёшь ИИ-агенту прав (ходить в интернет, дёргать инструменты, работать с данными), тем дороже стоит любой пробой его безопасности. А самый дешёвый способ пробоя, как выяснилось, - просто сменить язык. Для агента в бизнесе это не абстрактный риск, а конкретная брешь в периметре.
Что с этим реально делать
Хорошая новость: чинится это не магией, и часть защиты можно навесить самому, не дожидаясь, пока вендор закроет дыру.
Первое и главное - не считай встроенный отказ модели своей единственной линией обороны. Он полезен, но это не забор, а низкая изгородь, местами вообще без досок. Свой продукт защищай своим слоем, а не только надеждой на вендора.
Второе - поставь отдельную проверку ответа. В исследованиях 2026 года неплохо себя показали простые приёмы: модель просят перепроверить собственный ответ на безопасность отдельным шагом, плюс сверху вешают лёгкий классификатор, который умеет ловить опасное на нескольких языках, а не только на английском. Это дешевле, чем переучивать всю модель, и заметно поднимает планку.
Третье - тестируй продукт на тех языках, на которых реально сидит твоя аудитория. Если пользователи пишут по-русски, а ты гонял тесты безопасности только на английском, ты проверял не свой продукт. Прогони свои же опасные и пограничные кейсы через перевод и посмотри, что проходит.
Что это значит на практике
Вывод у меня простой и не про панику. Безопасность больших моделей - это не единое ровное поле, а лоскутное одеяло, плотно сшитое на английском и с большими прорехами на всём остальном. Пока вендоры это латают - а они латают, вон уже выходят подходы к кросс-языковой модерации и совместной защите, - ответственность за твой продукт лежит на тебе.
Если ты просто пользуешься ИИ для своих задач - код, тексты, автоматизации - тебе тут бояться нечего, живи как жил. Но если ты строишь на ИИ сервис для других людей, особенно на языке, отличном от английского, прими как данность: встроенная защита у тебя дырявая, и латать эти дыры - твоя работа, а не чужая. Проверь свой периметр на своём языке, добавь собственный слой модерации, и не полагайся на то, что модель "и так всё зарубит". На твоём языке - не факт.