15 сентября 2026 г.
Computer use: ИИ сам водит мышкой по твоему экрану
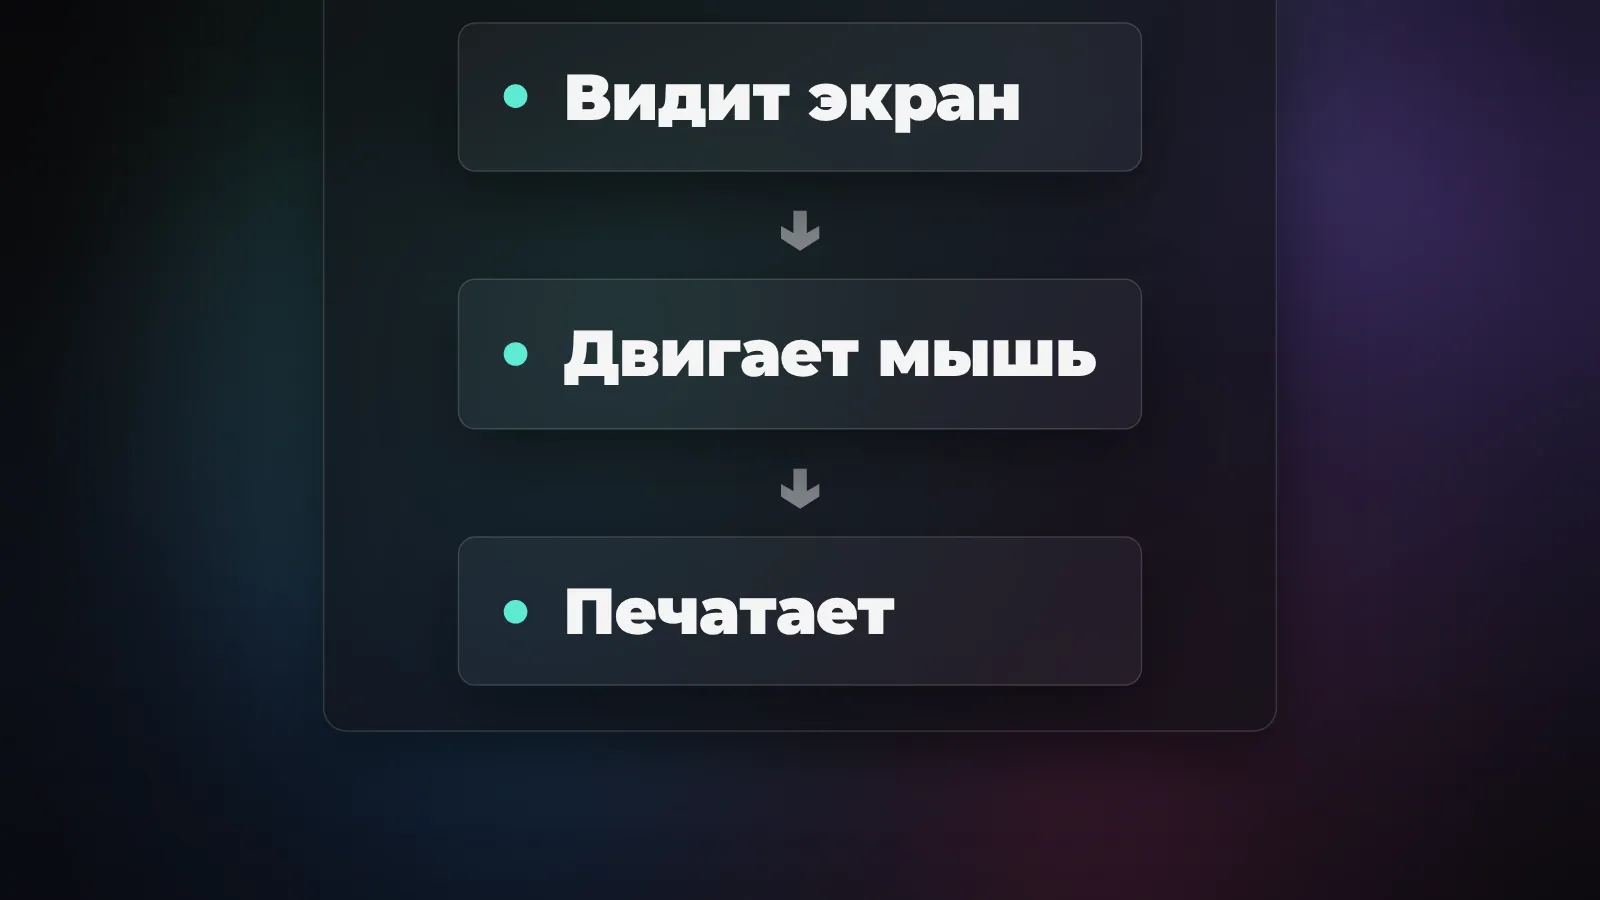

Computer use - это когда ИИ-агент смотрит на скриншот твоего экрана, сам двигает мышкой, кликает и печатает вместо тебя. Работает по циклу: снял экран, решил что нажать, нажал, снял снова. На коротких задачах уже сносно, на длинных пока рассыпается. Попробовать можно прямо из Claude Code на Mac.
Тема всплыла не на пустом месте. Пару недель подряд в ленте мелькают ролики, где человек говорит агенту «протыкай мой интерфейс сам» - и тот реально открывает приложение, жмёт кнопки, ловит ошибку на экране и правит её. Причём без тяжёлых фреймворков: хватает обычного кодинг-агента и одного скилла. Разберём, что там под капотом, где это уже работает, а где пока обещание.
Что это такое человеческим языком
Обычная нейросеть живёт в окне чата: ты пишешь текст, она отвечает текстом. Computer use ломает эту стенку. Модель получает три новые способности: видеть экран через скриншот, двигать мышью (клик, перетаскивание, наведение) и печатать на клавиатуре (текст и горячие клавиши). То есть агент работает с компьютером ровно так, как это делаешь ты: глазами и руками, а не через специальный API.
Зачем, если есть MCP-серверы и обычные команды в терминале? Затем, что до кучи программ иначе не дотянуться. У native-приложения на Mac, у симулятора iPhone, у железной панели управления или у проприетарного софта часто нет ни API, ни командной строки. Единственный вход туда - глазами по экрану и мышкой по кнопкам. Computer use как раз закрывает этот последний метр.
Как устроен цикл «скриншот - действие - скриншот»
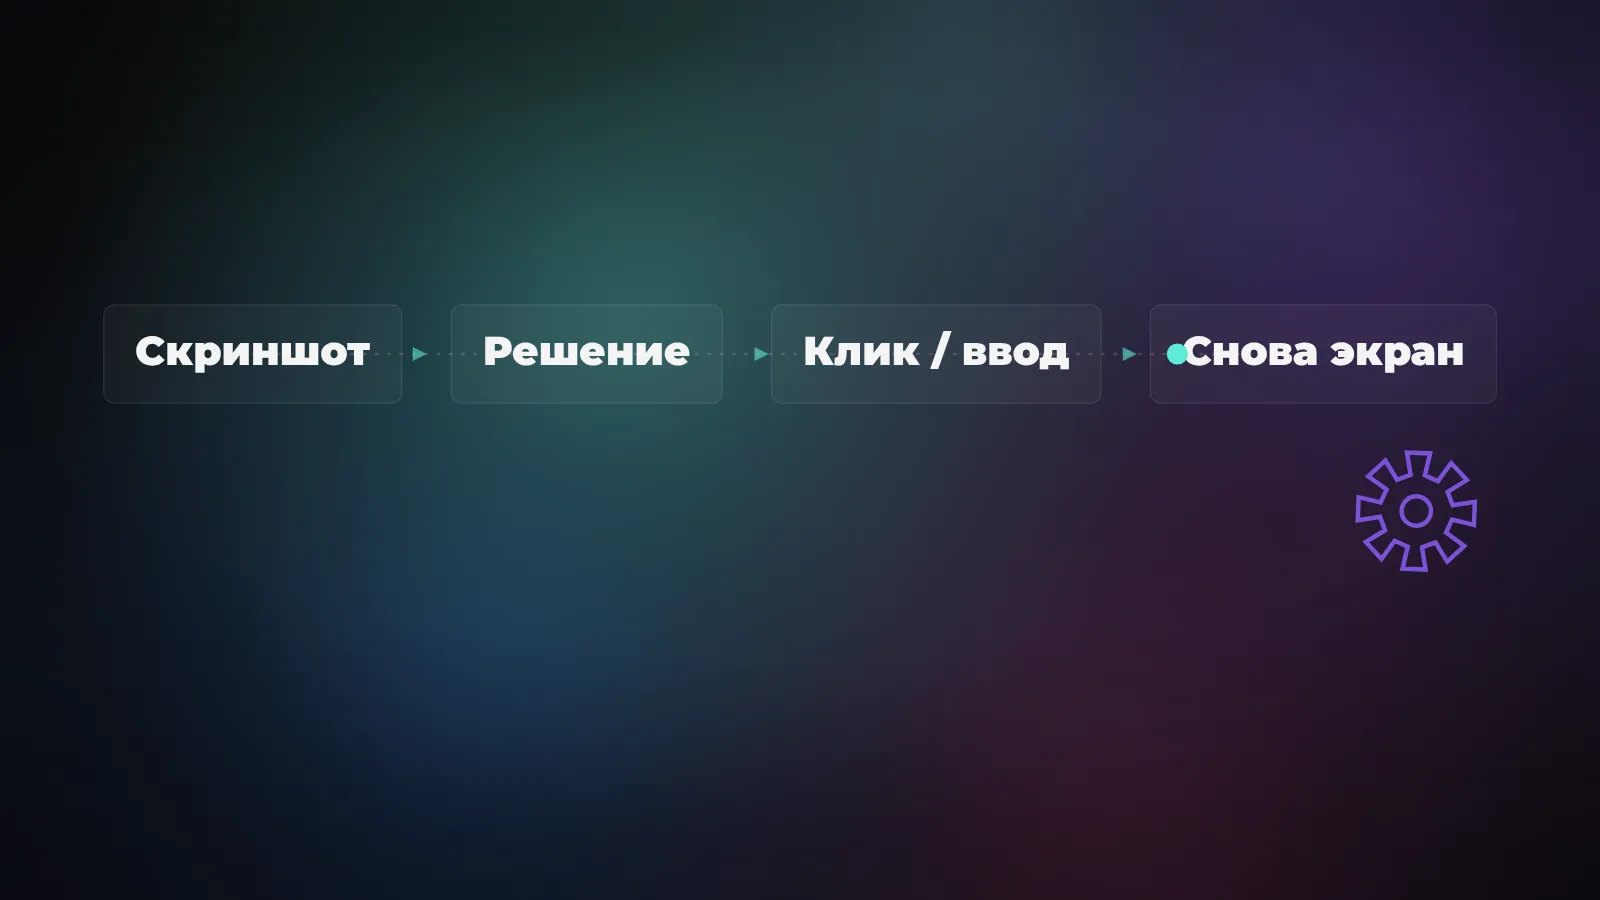
Внутри всё держится на простой петле. Агент делает снимок экрана, разглядывает его своим зрением - находит кнопки, читает текст, понимает, какое открыто окно. Дальше решает, что сделать, и выполняет одно действие: клик, ввод текста, нажатие сочетания клавиш. Потом снимает экран заново, чтобы увидеть результат, и всё повторяется по кругу.
Ключевой момент здесь - самопроверка. Кликнул не туда - на следующем скриншоте видит, что открылось не то, и исправляется. Именно эта способность ловить свои же промахи и делает подход рабочим на живых задачах, а не только в лаборатории. Простое дело обычно укладывается в 5-15 таких шагов, сложный многоходовый сценарий может забрать 30 и больше.
Отсюда сразу видно узкое место. Каждый шаг - это отдельный скриншот, который улетает в модель как картинка, плюс раунд рассуждения. Поэтому computer use медленный и прожорливый по токенам: там, где скрипт щёлкнул бы задачу мгновенно, агент честно смотрит-думает-жмёт десятки раз. Правило простое: если до программы можно дотянуться через API, MCP или командную строку - надо идти туда, а экран трогать только когда другого входа нет.
Кто уже это умеет
Первым громко зашла Anthropic со своим инструментом computer use для Claude. Следом OpenAI выкатил Operator (под капотом - Computer-Using Agent, CUA): агент живёт в облаке, водит в основном по браузеру, доступ сначала дали Pro-подписчикам в США через operator.chatgpt.com. Плюс вырос целый пласт open-source обвязок, которые дают ту же петлю на своих моделях.
Свежий сдвиг в том, что модели наконец стали достаточно зоркими, чтобы петля работала без громоздкой инфраструктуры. Раньше под computer use городили отдельный стек с сервером и проводкой. Теперь хватает лёгкого скилла, который умеет одно: снять скриншот встроенной командой системы и отдать его агенту. Дальше кодинг-агент сам смотрит и жмёт. Поэтому в лентах и появились ролики «собрал управление компьютером за вечер» - порог входа реально упал.
Насколько это надёжно на самом деле
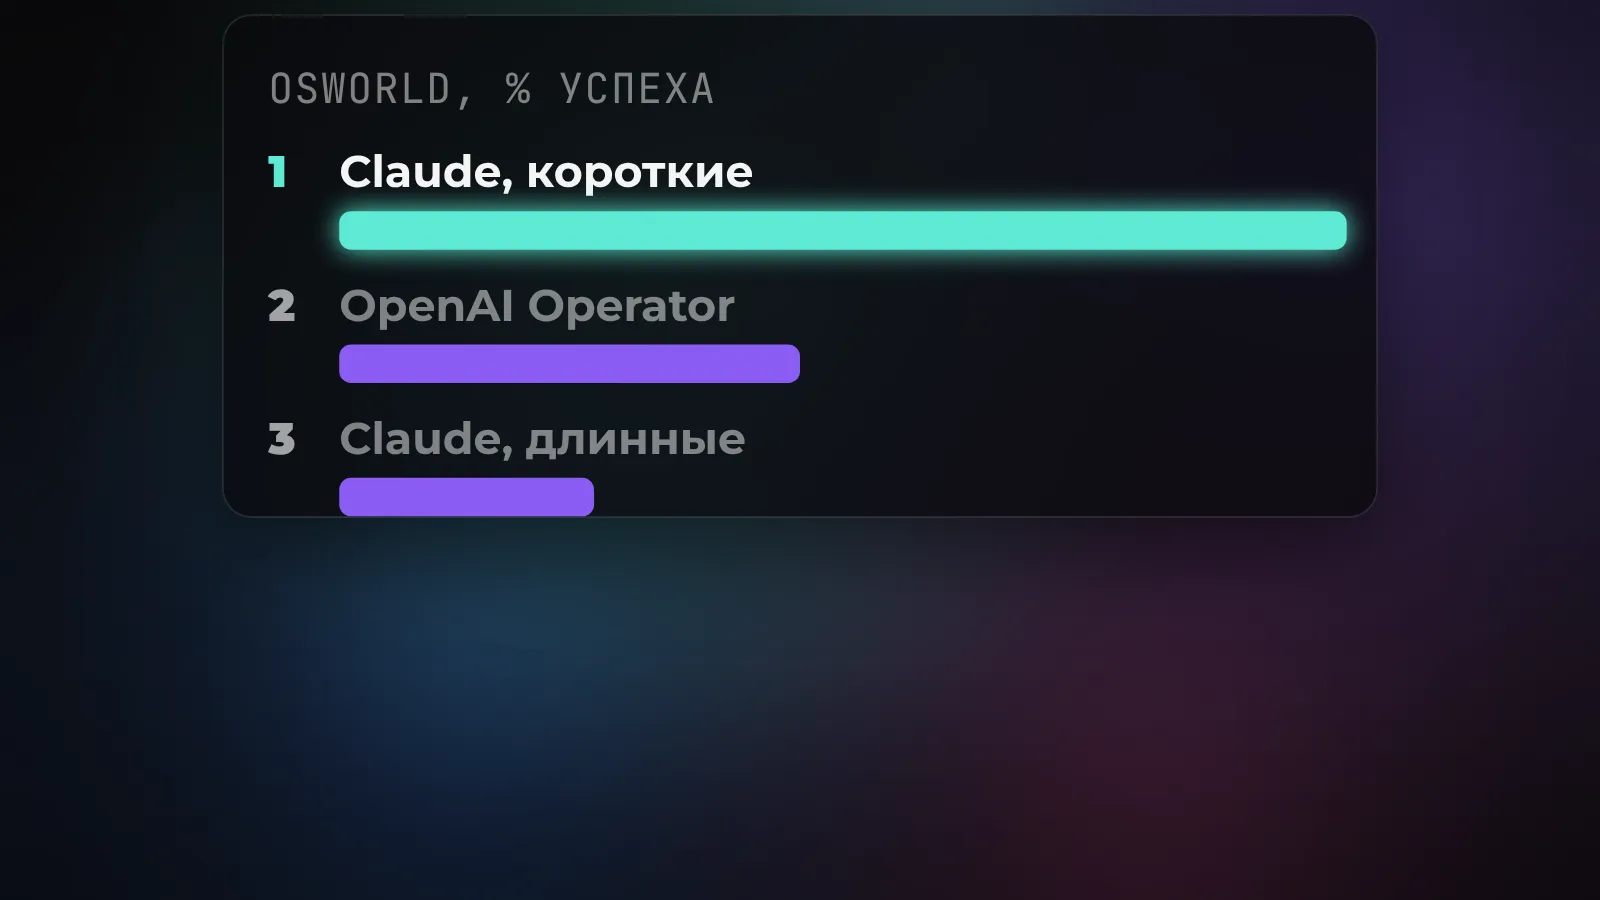
Тут важно не купиться на красивые цифры. Есть бенчмарк OSWorld - он гоняет агентов по настоящим операционкам (Ubuntu, Windows, macOS) на реальных задачах. Топовые модели показывают там уважаемый результат: Claude Opus 4.5 набирает 66,3%, а последний Opus 4.8 на версии OSWorld-Verified дотягивает примерно до 83%. Звучит почти как «готово, можно доверять».
Проблема в том, что задачи за этим числом короткие: одно-два приложения, пара шагов. Как только берут длинные многоходовые сценарии - на версии OSWorld 2.0 тот же Opus 4.8 с максимальным «думанием» падает до 20,6% по строгому зачёту (задача либо целиком сделана, либо нет). Для сравнения, OpenAI-CUA на классическом OSWorld держит 38,1%. Разрыв между «коротко» и «длинно» - это и есть настоящая картина.
Причина честная и понятная. Ошибки в длинной цепочке накапливаются: на каждом шаге небольшой шанс промахнуться, а шагов десятки - и вероятность довести всё до конца тает. Плюс интерфейсы меняются, всплывают неожиданные окна, съезжает вёрстка. Вывод для практики: короткие, проверяемые задачи под присмотром человека - надёжны; длинные автономные прогоны без надзора - пока лотерея. Балл на бенчмарке не обещает такой же надёжности на твоём собственном рабочем процессе.
Как попробовать самому
Самый быстрый путь без возни - из Claude Code на Mac. Это research preview, нужна подписка Pro или Max и живая интерактивная сессия (в фоновом режиме с флагом -p не заработает). Порядок такой:
- В сессии Claude Code открой меню командой
/mcpи найди встроенный серверcomputer-use- по умолчанию он выключен. - Включи его. Настройка запоминается для проекта, так что делаешь это один раз.
- При первой попытке macOS попросит два разрешения: «Универсальный доступ» (чтобы кликать и печатать) и «Запись экрана» (чтобы видеть картинку). Выдай оба. После записи экрана Claude Code, возможно, придётся перезапустить.
Дальше просто просишь по-человечески: «собери приложение, запусти и прощёлкай все вкладки, заскриншоть, если что-то падает». Агент соберёт проект, откроет окно, потыкает кнопки и вернёт отчёт.
Второй путь, если хочется поиграть в песочнице, а не на своей машине, - официальное демо Anthropic. Это готовый Docker-контейнер с Linux-десктопом внутри, поднимается меньше чем за десять минут даже без опыта с Docker. Агент там водит по изолированному рабочему столу, а не по твоему.
Что можно поручать, а что рано
По уму сегодня это удобнее всего для разработки и тестов. Собрать native-приложение и самому прощёлкать каждую кнопку перед тем, как ты его откроешь. Прогнать сквозной UI-тест: агент проходит регистрацию и скриншотит каждый шаг, без Playwright и тестовой обвязки. Воспроизвести визуальный баг - «модалка обрезается на узком окне»: агент ужимает окно, ловит поломку, снимает её и лезет в CSS. Погонять сценарий в симуляторе iPhone без написания XCTest.
А вот длинную неконтролируемую автоматизацию бизнес-рутины поручать рано. «Зайди в три системы, перенеси данные, оформи и отправь» на десятки шагов - ровно тот случай, где ошибки накапливаются и результат непредсказуем. Пока это ассистент под присмотром, а не автопилот, которому отдают руль на всю ночь.
Безопасность: почему это опаснее обычного чата
Обычный чат живёт в песочнице: максимум напишет тебе глупость. Computer use работает на твоём реальном рабочем столе и с теми приложениями, что ты разрешил. Граница доверия смещается, и это надо понимать заранее.
Разработчики встроили несколько предохранителей. Агент контролирует только те приложения, которые ты одобрил в текущей сессии, - разрешение живёт до её конца. Программы с широким доступом помечаются отдельно: терминал и IDE приравнены к доступу в командную строку, Finder может читать и писать любые файлы, «Системные настройки» меняют настройки машины - об этом предупреждают до того, как ты нажмёшь «Разрешить». Твоё окно терминала исключено из скриншотов, чтобы текст из твоей же сессии не подсунулся модели как команда. Есть глобальный Esc: он мгновенно останавливает управление откуда угодно, и это нажатие «съедается», чтобы вредная инструкция с экрана не смогла им закрыть диалог. И работает единовременно только одна сессия - через файл-замок.
Отдельная беда - инъекция промпта прямо с экрана. Если на странице или в окне спрятана инструкция «сделай то-то», модель может прочитать её как задачу. Anthropic гоняет проверку каждого действия на такие подставы и, если что-то выглядит подозрительно, ставит паузу и просит подтверждения. Но полностью проблему это не снимает: разрешая агенту водить по экрану, ты доверяешь ему ровно столько, сколько может натворить сам, кликая по этим кнопкам.
Стоит ли оно тебе сейчас
Если ты пишешь код или тестируешь интерфейсы - да, пробуй уже сегодня: собрать-запустить-прощёлкать в одном разговоре с агентом экономит кучу переключений. Если ждёшь автопилот, который молча ведёт твою операционку сутками, - ещё рано, короткие задачи под присмотром это потолок на сейчас. Технология из разряда «посмотреть и приручить заранее»: она дозревает быстро, и когда длинные сценарии перестанут рассыпаться, выиграет тот, кто уже понимает, как с ней обращаться.