13 ноября 2026 г.
ComfyUI ускорила локальные LLM: откуда взялось удвоение скорости

ComfyUI ускорила локальную генерацию текста на моделях Qwen3.x: в замерах команды тот же Qwen3.5 9B на RTX 5090 вырос со 106 до 219 токенов в секунду. Для пробы обнови ComfyUI до версии с новым движком, открой шаблон TextGenerate и оставь MTP в режиме auto. Удвоение не гарантировано на каждой видеокарте и задаче.
Я обычно связываю ComfyUI с картинками: узлы, модели, генерация, бесконечные провода между ними. Но внутри этого графа уже живёт и языковая модель. Она может прочитать фотографию, описать её и переписать промпт для следующего узла. Поэтому инженерный разбор команды Comfy Org интереснее очередного объявления «стало быстрее»: здесь показано, где именно простаивала видеокарта и за счёт чего её удалось загрузить иначе.
Что ускорилось и почему цифры разные
Речь о встроенной генерации текста в ComfyUI, в первую очередь на семействе Qwen3.x. Это не новый вес модели и не обновление облачного API. Команда переписала горячий участок локального вывода текста; изменения доступны в релизе ComfyUI v0.45.0. В заметке приведены результаты на конкретных карточках и задачах, а не обещание всем пользователям.
Самый яркий пример - Qwen3.5 9B на RTX 5090: авторы измерили 106 токенов в секунду до изменений и 219 после. На RTX 5080 с той же моделью указаны 91 и 129 токенов в секунду. Отдельный тест с Qwen3.8 27B, описывающей изображение размером 1536×1536, дал 55 и 122 токена в секунду на RTX 5090. Все эти числа - собственные замеры разработчиков ComfyUI; я не запускал их повторно на своём железе.
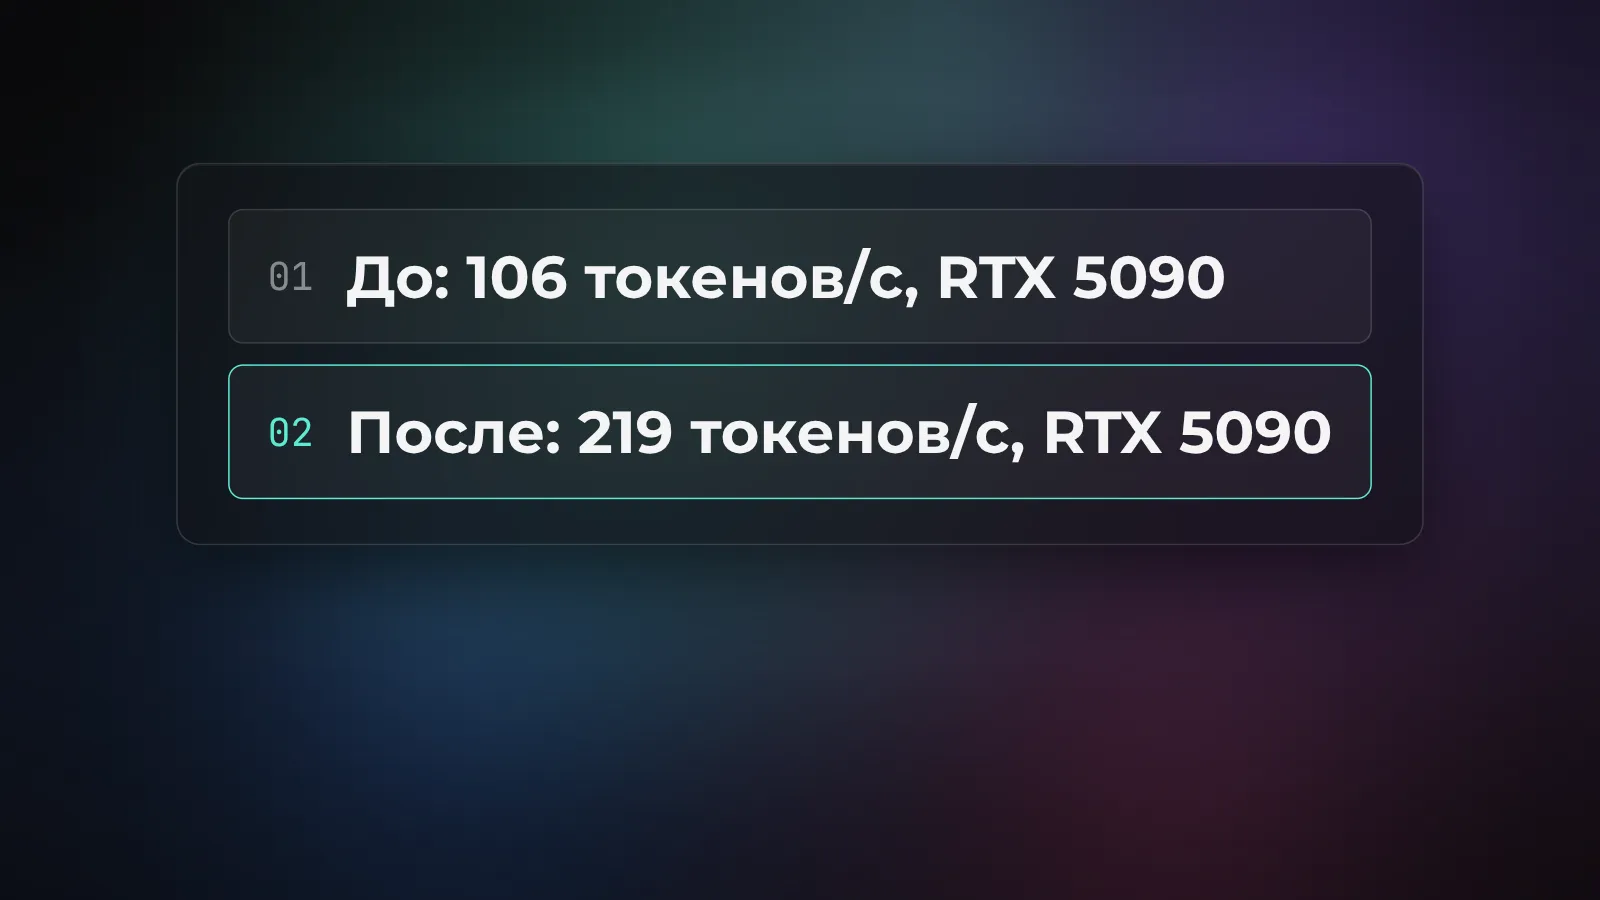
Не стоит перемножать эти числа на скорость всей картинки. Токены в секунду измеряют фазу вывода текста. Загрузка весов, обработка входного изображения, генерация самого изображения и сохранение результата занимают своё время. Если текстовый узел - малая часть рабочего процесса, готовая картинка не появится вдвое раньше. А если ты пакетно описываешь сотни файлов локальной моделью, ускорение этого узла уже может быть заметно.
Почему генерация текста упиралась в память
Когда модель пишет ответ, следующий токен зависит от уже написанного. В обычном одиночном графе ComfyUI ей нужно снова проходить через веса модели ради каждого шага. Представь длинный справочник, который видеокарта перечитывает ради одного следующего слова. В разборе архитектуры ComfyUI объясняют: для небольшой пачки токенов вычислений относительно мало, а чтение весов из видеопамяти обходится дорого.
Это отличается от генерации изображения. Там вычисления над изображением можно выполнять параллельно по множеству элементов; текст на выходе в основном растёт последовательно. Поэтому совет «поставь видеокарту мощнее по вычислениям» сам по себе не объясняет, почему генерация отдельной фразы ускорится. Важны пропускная способность памяти и способ раскладки весов. Если же модель не помещается в видеопамять и часто выгружает данные, ситуация будет ещё менее похожа на красивые числа из заметки.
Авторы изменили обработку линейных слоёв: веса и их масштабы теперь расположены ближе к порядку чтения ядром, меньше лишних обращений к памяти. Добавили объединение соседних операций и улучшили обработку внимания. Формулировка звучит сухо, но смысл практичный: пока устройство гоняет данные туда-сюда, оно не пишет следующий фрагмент ответа. Оптимизация экономит именно эти поездки. Это инженерная работа под конкретный способ исполнения модели, а не универсальное ускорение всякой нейросети в системе.
Что такое MTP без магии
Второй источник выигрыша - Multi-Token Prediction. У совместимых моделей есть небольшая дополнительная часть, которая предлагает несколько следующих токенов. Основная модель проверяет кандидатов пачкой. Если догадка совпала с тем, что она сама выбрала бы, токен принимается и отдельный полный проход ради него не нужен. Общий принцип спекулятивного декодирования описан в научной работе; конкретную реализацию и её цифры в ComfyUI объясняют сами разработчики.
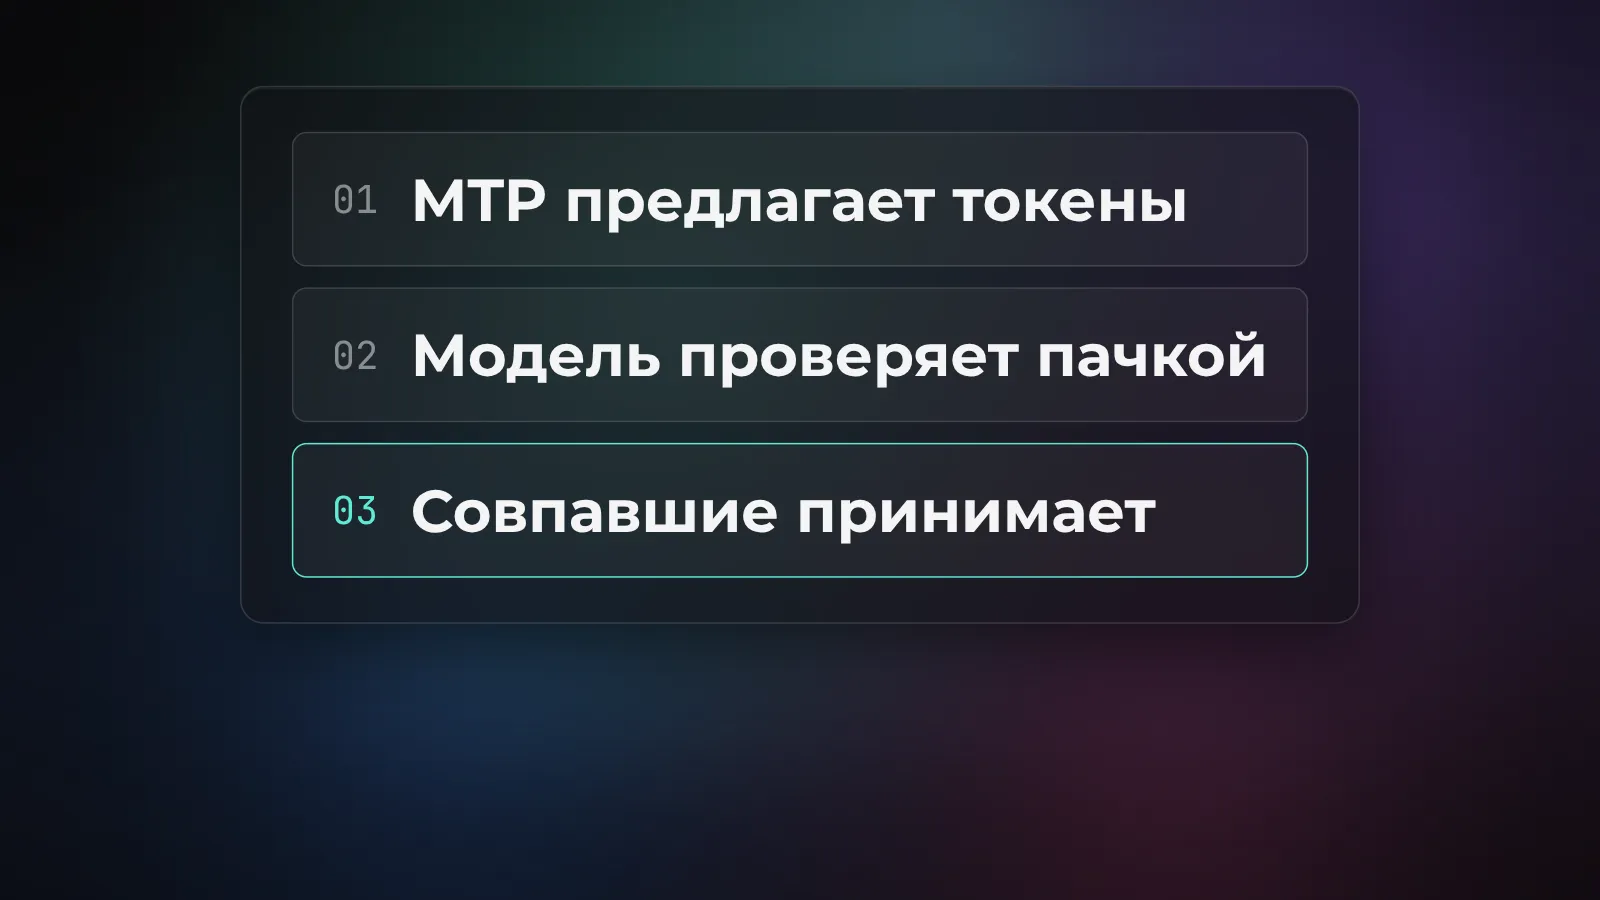
Раньше в ComfyUI предложения шли одной цепочкой: если первое звено ошиблось, вся ветка после него пропадала зря. Теперь описанный командой алгоритм держит рядом и запасные варианты. Представь черновик фразы, где сразу приготовлены ещё два возможных начала. Проверка пачки может принять правильную ветку без нового чтения всех весов для каждой попытки.
Режим auto подстраивает форму этой маленькой ветки по ходу генерации. Предсказуемые продолжения текста выгоднее проверять глубокой цепочкой, более вариативные - несколькими кандидатами на одном шаге. Но если предложения часто не подходят, на подготовку и проверку уходит время, а выигрыш падает. Вот почему «до двух раз» нельзя переносить на любой русский промпт, длинную инструкцию или другой чекпойнт. Речь о скорости генерации при определённых условиях, а не о том, что у модели вдруг прибавилось ума.
Как попробовать без рискованной переустановки
Сначала посмотри, какая версия ComfyUI у тебя запущена, и сохрани рабочий граф. Официальная инструкция обновления различает Desktop, Portable и ручную установку. В Desktop обновление самой программы и ядра ComfyUI - разные действия: ядро обновляется через Manage и вкладку Update. У Windows Portable свои скрипты в папке update. При установке из Git нужны обновление кода и зависимостей в собственном виртуальном окружении, затем перезапуск. Не надо запускать чужой установщик поверх рабочего проекта просто ради теста скорости.
После обновления открой официальный шаблон Qwen3.5 в библиотеке Workflow Templates. Документация описывает встроенный узел TextGenerate: он принимает текстовую инструкцию и, если нужно, изображение. Готовые веса Qwen3.5 кладутся в каталог models/text_encoders установленной копии ComfyUI. Если шаблон просит отсутствующую модель, сначала проверь имя файла и этот каталог; загрузка чужого «ускорителя» через случайный custom node для официального шаблона не требуется.
В заметке Comfy Org советуют оставить параметр mtp узла Text Generate в режиме auto. Это хороший исходный вариант для совместимой модели. Не нужно угадывать вручную глубину дерева ради красивого скриншота. Если результат кажется странным, сначала убедись, что загружен подходящий чекпойнт, а не облачный узел другого провайдера, и что версия ядра действительно обновлена.
Какое железо нужно и во что это обойдётся
Тут легко обещать лишнего. Официальный гайд по Qwen3.5 предлагает несколько размеров весов: файл 2B bf16 занимает примерно 4,5 ГБ, есть средний вариант 4B, файл 9B bf16 - около 19 ГБ. Есть и официальный вариант 9B W4A8, чей файл занимает примерно 7,34 ГБ по карточке хранилища. Это размеры файлов, а не готовая инструкция «покупай видеокарту ровно на столько же памяти».
Кроме весов во время работы нужна память под внутреннее состояние, контекст, входную картинку и другие узлы графа. Если одновременно открыт генератор изображений, его требования тоже никуда не исчезают. Я бы начал с меньшего официального варианта и своего реального задания, а не покупал железо под один опубликованный результат на RTX 5090. Ошибка нехватки памяти - повод уменьшить модель или граф, а не доказательство, что новая версия сломана.
За локальные токены не приходит отдельный счёт по API, но электричество, время и видеокарта стоят денег. ComfyUI полезна здесь тем, что языковая модель уже встроена в граф с изображением: описание, проверка и следующий промпт могут оставаться в одном локальном процессе. Для одного короткого ответа в день настройка может оказаться хлопотнее облачного чата. Для потока изображений, которые нужно подписать или разложить по темам, сокращение ожидания у текстового узла интереснее. Это оценка сценариев, не обещание конкретной экономии.
Где ускорение заканчивается
Обновление работает на уровне движка, поэтому авторы говорят о поддержке NVIDIA и AMD на Windows и Linux. Но опубликованные детальные замеры в инженерной заметке относятся к конкретным NVIDIA-картам и Qwen-моделям. У меня нет проверенного числа для твоей AMD, другой квантизации или Mac. Если ты используешь ComfyUI только для диффузионной генерации без TextGenerate, новость почти ничего не меняет в твоей повседневной скорости.
В заметке также описан отдельный необязательный режим внимания Comfy-Kitchen, который сокращает расход памяти под KV-cache и ускоряет обработку длинного входа в определённых сценариях. Это уже дополнительная настройка, а не обязательное условие нового MTP. Я бы не включал экспериментальные флаги вслепую: сначала проверил базовый граф после обычного обновления, затем менял по одному параметру и смотрел, что стало с временем и свободной видеопамятью.
Главный вывод у меня такой: обновлять ComfyUI ради ускорения текста имеет смысл, если внутри твоего графа действительно работает локальная Qwen3.x. Посмотри на время именно этого шага до и после, затем оцени весь граф. Число «219 токенов в секунду» хорошо показывает, что сделали инженеры, но ответ на вопрос «стало ли быстрее у меня» даёт только твой собственный замер.