12 ноября 2026 г.
Clairic от Cloudflare: как доставать поля из документов без длинного ответа ИИ

Clairic - модель Cloudflare для извлечения конкретных полей из текста и изображений. Ты задаёшь названия и типы полей, а получаешь суммы, даты или имена вместе с оценкой уверенности. Для обработки счетов это может быть дешевле обычного чата, но правильный формат ответа не гарантирует правильную сумму. Проверку перед оплатой всё равно оставляй человеку.
Мне этот инструмент интересен не как очередной «ИИ для документов». В обычном сценарии мы просим большую модель прочитать счёт, написать JSON, а потом отдельно разбираемся, не придумала ли она номер заказа или не потеряла ли строку доставки. У Clairic другой интерфейс: сначала задаёшь форму результата, потом передаёшь материал. Разберу, где это сокращает работу и где красивому ответу лучше не верить.
Что вышло и почему это не новость сегодняшнего дня
Cloudflare выпустила Clairic 19 октября 2026 года в статусе preview на Workers AI. В дайджесте новостей тема всплыла снова, но выдавать октябрьский релиз за сегодняшний было бы нечестно. Модель работает в облаке Cloudflare под идентификатором @cf/cloudflare/clairic. Компания обещала открыть веса позже; конкретного срока в анонсе нет. Самому скачать и запустить их сейчас по этому обещанию нельзя.
Название «модель извлечения» звучит скучновато, зато назначение понятное. Если в счёте написаны поставщик, дата и итог, Clairic может вернуть эти значения отдельно, в заданных типах. Если в письме есть условия доставки, можно попросить дату и длительность. Справка Cloudflare чётко разводит три задачи: извлечение значений, выбор решения из готовых вариантов и свободное объяснение текстом. Clairic делает первую. Для выбора «одобрить или отправить бухгалтеру» нужна отдельная логика или модель принятия решений; для письма клиенту - текстовая модель.
Этот разбор посвящён API, а не кнопке «загрузить PDF и получить таблицу». Карточка модели показывает передачу текста и изображений в запросе. Для готового многостраничного PDF понадобится собственный этап чтения документа и сборки входных данных. Я не стал называть Clairic универсальным парсером всех файлов: такой сценарий зависит ещё и от качества предыдущего этапа.
Как она превращает счёт в поля
Запрос состоит из state и fields. Первое - исходный текст или контекст вместе с доступными изображениями. Второе - словарь имён полей, типов и инструкций. Вместо просьбы «напиши хороший JSON» ты указываешь, что invoice_number должен быть текстом, а total - числом. Официальный пример использует именно счёт, сумму с доставкой, дату оплаты и контакты.
У текстового ответа есть span - позиции фрагмента в переданном тексте. Это полезно, если надо показать человеку место, из которого взялся номер счёта. У чисел и дат есть value, оценки confidence и p_null. В официальном примере отсутствующий номер заказа возвращается как null, хотя рядом присутствует догадка guess. Если твой код подхватит догадку вместо value, ты сам превратишь отсутствие данных в вымышленную запись.
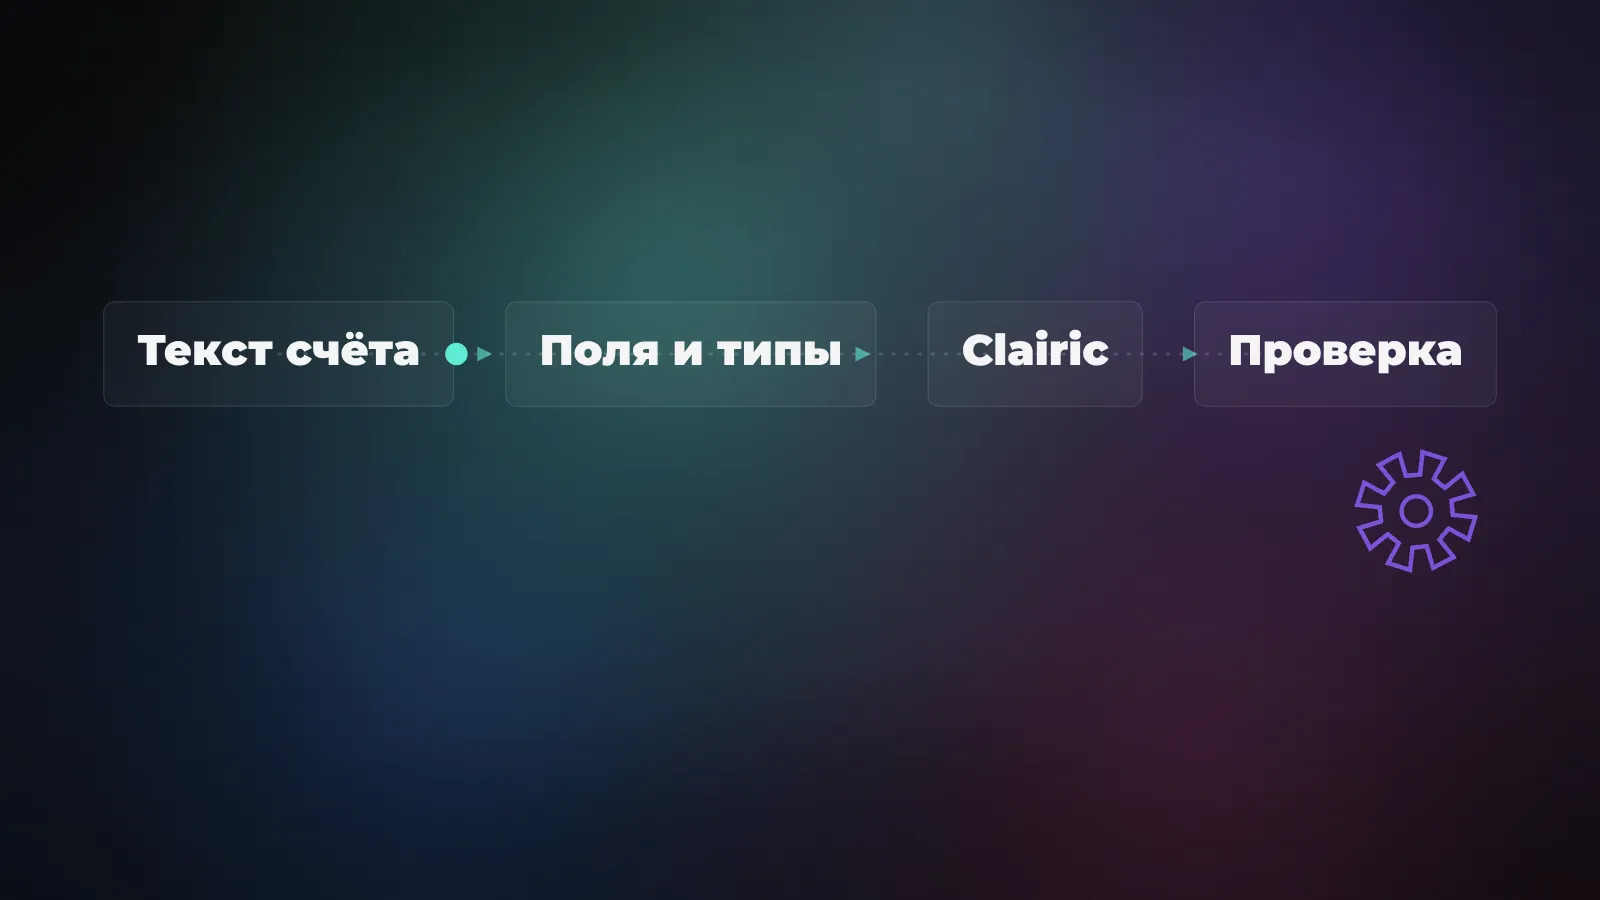
Есть разница между «прочитал» и «посчитал». Печатная сумма берётся из счёта; срок оплаты по дате выставления и условиям платежа нужно вычислить. Прогноз даты фактической оплаты вообще не следует из одного документа. Руководство по extraction-моделям разделяет извлечение, вычисление, оценку и прогноз. Если во входе нет истории платежей, красивая оценка срока остаётся слабой догадкой.
Как попробовать на небольшом примере
Начни с официальной инструкции Cloudflare для Worker и AI binding. Нужен аккаунт Cloudflare и проект Worker; в конфигурации задаётся привязка AI, которая становится доступной приложению как env.AI. Сначала изучи пример без деплоя и убери реальные клиентские данные: при вызове облачной модели их пришлось бы отправить провайдеру. В рабочем проекте отдельно проверь права и стоимость доступа.
Для проверки схемы хватит выдуманной строки «Поставщик Лира. Счёт А-7. Итого 840». Это демонстрационный вход, не результат моего запуска API. Карточка Clairic задаёт форму вызова через env.AI.run. Внутри своего Worker можно подставить такой минимальный запрос:
const result = await env.AI.run("@cf/cloudflare/clairic", {
  model: "clairic",
  state: "Поставщик Лира. Счёт А-7. Итого 840.",
  fields: {
    supplier: { type: "text", instructions: "Имя поставщика" },
    invoice_number: { type: "text", instructions: "Номер счёта" },
    total: { type: "number", instructions: "Сумма к оплате" },
  },
});
return Response.json(result);
Это фрагмент обработчика Worker, а не команда для терминала. Здесь я намеренно не показываю готовый JSON-ответ: платного вызова из этого прогона я не делал. После добавления привязки запусти Worker локально по инструкции Cloudflare, открой выданный адрес и посмотри сырые answers. Локальный сервер всё равно обращается к облачному инференсу; слово «локально» относится к твоему коду, а не к месту работы модели.
Сравни answers.supplier.value и answers.invoice_number.value с исходной строкой. Потом убери номер из state и проверь, как приложение обрабатывает null. На этом этапе часто и обнаруживается настоящая ошибка интеграции: интерфейс выводит guess, записывает пустую строку в базу или принимает число без просмотра исходника. Проверь также вход с двумя суммами - стоимостью товара и суммой с доставкой - и уточни инструкции поля total. Модель знает тип, но не знает твоих правил учёта.
Сколько стоит попытка
Карточка Clairic указывает $0.10 за миллион входных токенов. Cloudflare отдельно пишет, что выходные токены не тарифицируются: модель возвращает поля, а не генерирует ответ слово за словом. Но «цена токена» не равна цене готового бизнес-процесса. Подготовка PDF, загрузка изображений, повторные запросы, ручная проверка и исправление ошибок тоже стоят денег и времени.
В самостоятельном тесте Spydr Clairic обошёлся авторам примерно в $0.62 на тысячу элементов против $6.60 для сравниваемой ими модели Claude. Это не прайс Cloudflare на тысячу любых документов, а результат конкретной задачи с заданной схемой и расходом входа. На длинных сканах или после нескольких проходов итог будет другим. Я бы сначала измерил стоимость полного цикла на своих данных: загрузить, извлечь, сверить и сохранить.
У меня нет отдельного замера Clairic на российских счетах и нет подтверждённой статистики поискового спроса на эту тему. Популярность карточки в дайджесте тут ничего не доказывает. Практический смысл публикации проще: у разработчика появилась ещё одна узкая альтернатива большой текстовой модели для повторяющейся операции.
Где модель ошибается
Хорошо оформленный ответ легко принять за проверенный. Cloudflare сама предупреждает: длинные цепочки расчётов и агрегация множества строк пока ненадёжны, дальние прогнозы уплощаются, а доверительные интервалы могут оказаться слишком узкими на незнакомых данных. Поля типа number не заставляют неверно прочитанную сумму стать правильной. confidence помогает расставить очередность проверки, но не даёт разрешения переводить деньги автоматически.
Spydr проверила Clairic на собственной подборке изображений: в их опыте точность полей на изображениях составила 59% у базовой настройки Clairic против 83% у Claude Sonnet; после дополнительной инструкции и обработки фрагментов у Clairic получилось 63%. Это фэнтезийные карточки и музейные изображения, а не финансовые документы. Результат нельзя переносить на счета, но он хорошо отрезвляет: все ответы разбирались по типам, и при этом часть значений оставалась неверной.
Команда Curiosity отдельно проверила публичную схему и обработку документированного ответа, но прямо пишет, что не измеряла точность на большом массиве реальных документов. Мне нравится такая оговорка больше рекламного «извлечёт всё без ошибок». Для собственного внедрения собери размеченную выборку из своих счетов, отдельно посмотри на плохие сканы и документы без нужного поля. Сверяй ответ с оригиналом, а спорное отправляй на ручной разбор.
Кому это пригодится
Я бы пробовал Clairic там, где каждый день приходят похожие документы и из каждого нужны одни и те же несколько полей: реквизиты для согласования, даты поставки, состав обращения в поддержку. В таком процессе вход и ожидаемый результат можно описать явно, а качество сравнить с размеченными примерами. Для разового длинного исследования, объяснения договора или письма клиенту обычная текстовая модель остаётся ближе к задаче.
Порог входа здесь инженерный. Нужен Worker или вызов REST API, подготовка входных данных и обработка пропусков. Даже если прогнозы модели улучшатся, бизнес-правила и контроль ошибок придётся писать отдельно. Зато можно перестать платить большой модели за многословный ответ там, где тебе нужен один номер счёта и дата.
Вывод у меня приземлённый: возьми несколько обезличенных документов, заранее запиши правильные значения, проверь Clairic на них и сравни стоимость всей обработки с текущим способом. Если реальная точность устраивает, расширяй набор полей постепенно. Пока это preview-сервис Cloudflare, а не обещание, что очередной ИИ сам разберётся с бухгалтерией.