8 сентября 2026 г.
Чем плоха Ollama и чем её заменить для локальных моделей

Ollama - самый простой способ запустить нейросеть у себя на компьютере, но у неё есть реальные болячки. По умолчанию она режет контекст до 2048 токенов и молча теряет остальное, путается в названиях моделей, отстаёт по скорости от движка, на котором сама и работает, и годами не указывала, чей это движок. Разбираю, где это бьёт по делу и чем заменить.
Сразу скажу: я не топлю против Ollama целиком. Одна команда ollama run - и модель крутится, это честно удобно, особенно на старте. Но чем дольше на ней сидишь, тем чаще упираешься в решения, которые приняли за тебя и о которых не предупредили. Ниже - по пунктам, что именно и почему это бьёт по делу.
Что такое Ollama и почему её все ставят
Ollama - это обёртка вокруг llama.cpp, движка для запуска моделей на обычном железе. Она прячет всю возню: скачивание весов, выбор кванта, запуск сервера. Ставишь одну программу, пишешь ollama run qwen3, и через минуту у тебя локальный чат без облака и подписки.
За эту простоту её и любят. Для первого знакомства с локальными моделями - отличная точка входа. Проблемы начинаются, когда ты выходишь за пределы «поболтать с моделью» и тебе важны скорость, длинный контекст или предсказуемость. Тут удобные умолчания оборачиваются граблями.
Контекст 2048: главная ловушка
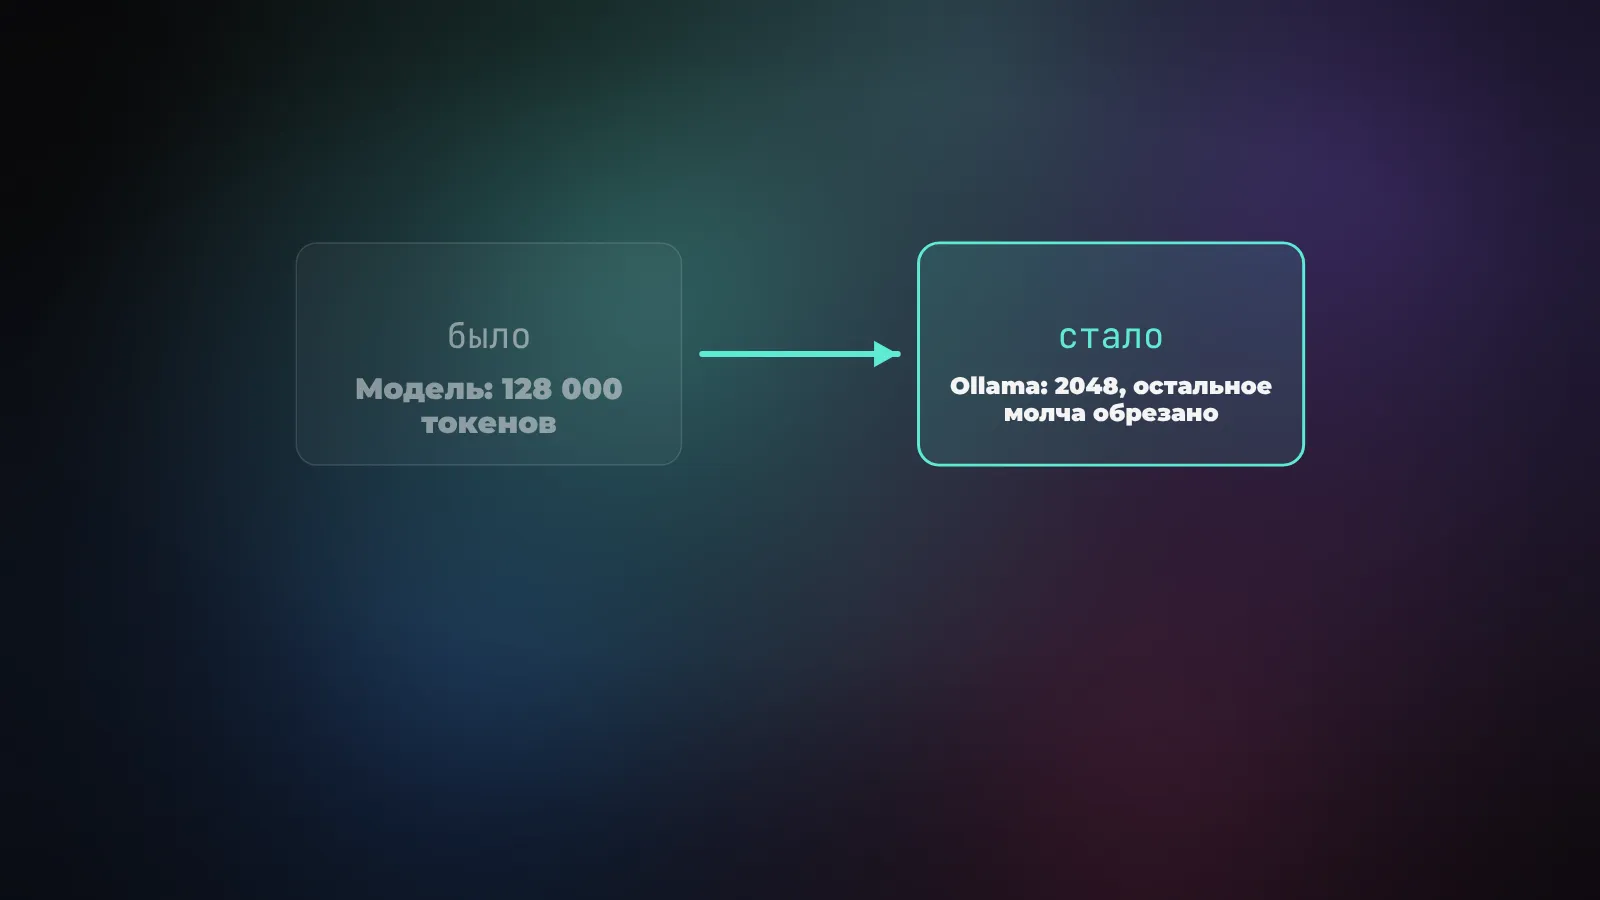
Самая коварная вещь. По умолчанию Ollama даёт модели окно контекста в 2048 токенов - независимо от того, что сама модель умеет держать 128 тысяч и больше. Сделано это ради того, чтобы всё стартовало мгновенно даже на слабом ноутбуке, но цена высокая.
Когда твой диалог, документ или агентный цикл перерастает 2048 токенов, Ollama молча выбрасывает начало. Без ошибки, без предупреждения, без единого намёка, что что-то потерялось. Модель просто перестаёт видеть первую часть разговора и начинает «забывать» то, что ты ей сказал пять сообщений назад. Люди месяцами винят в этом «тупую модель», хотя виноват потолок в настройках.
Путаница в названиях: ты запускаешь не то, что думаешь
Отдельная боль - библиотека моделей. Когда в начале 2025 года вышла DeepSeek-R1, в каталоге Ollama под именем deepseek-r1 лежали не сама большая модель, а её дистилляции - маленькие модели на базе Qwen и Llama, дообученные на ответах R1. Тег deepseek-r1:8b - это дистилляция на 8 миллиардов параметров, а настоящая R1 - это 671 миллиард, совсем другой зверь под тегом :671b.
Куча людей качала 8-миллиардную модель, видела имя «DeepSeek-R1» и искренне думала, что гоняет дома флагман, о котором писали все новости. Потом Ollama ещё и переклеила теги: тот же deepseek-r1:8b в какой-то момент стал указывать уже на другую базовую модель. Имя одно, содержимое разное - проверить, что ты реально запустил, по названию нельзя.
Скорость: llama.cpp быстрее на том же железе
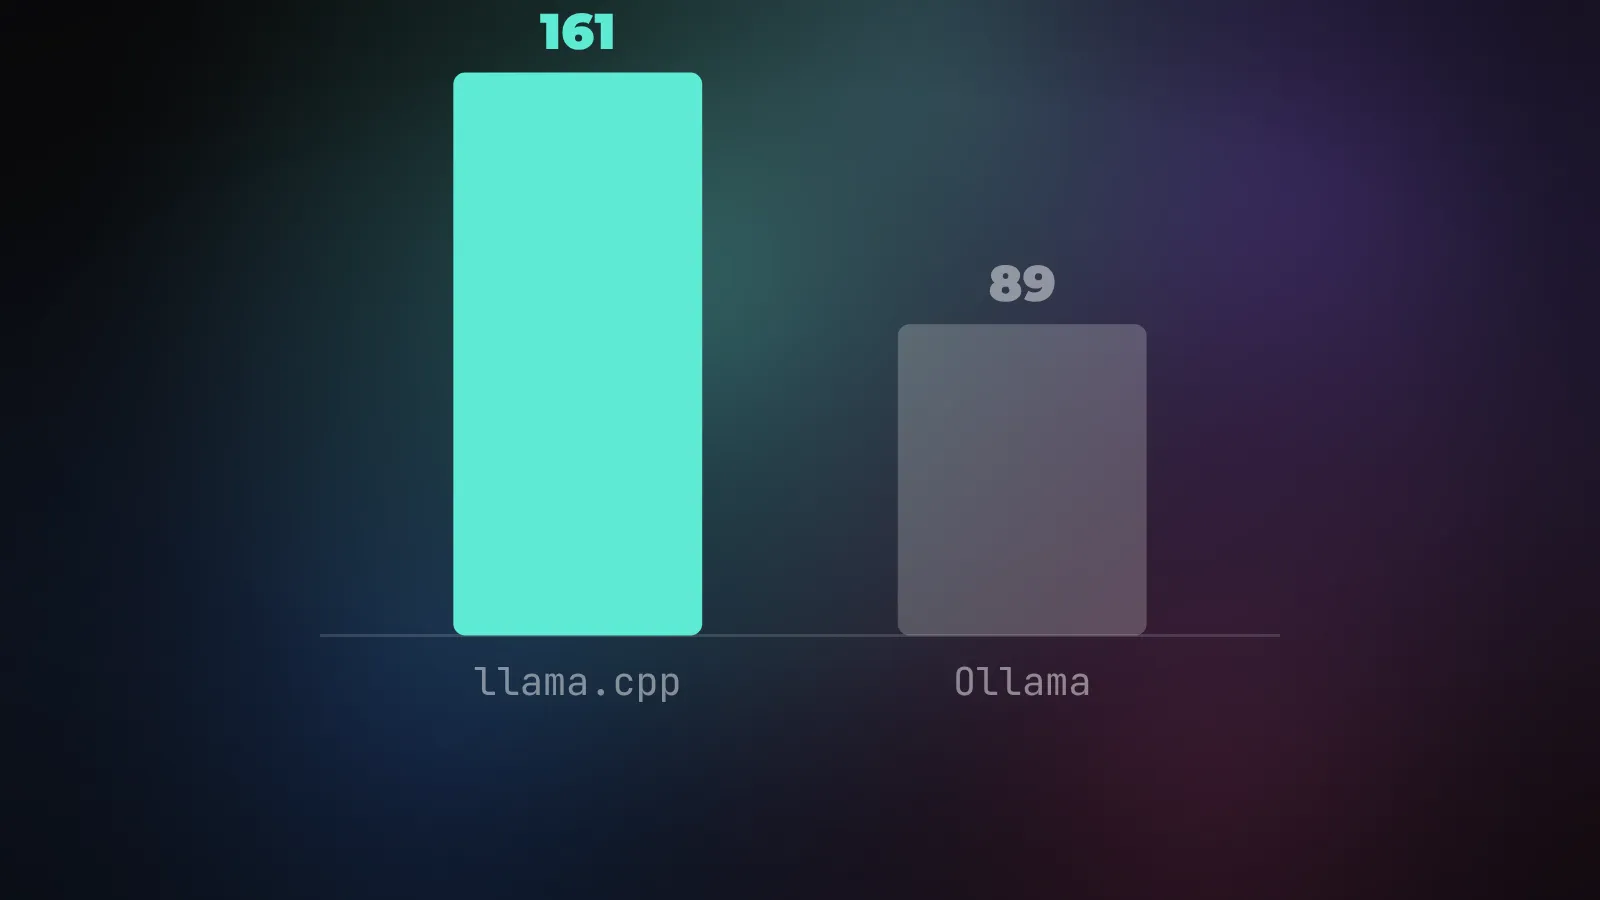
Ollama работает поверх llama.cpp, но со своей прослойкой и своим форком движка. Прослойка не бесплатна. В одном подробном разборе на одном и том же железе с одной и той же моделью llama.cpp выдал 161 токен в секунду против 89 у Ollama - почти в 1,8 раза быстрее. На процессоре без видеокарты разрыв меньше, порядка 30-50 процентов, но он есть всегда.
Причины - лишний слой демона, слабые эвристики выгрузки слоёв на видеокарту и отставший форк движка. Ollama тащит свою копию llama.cpp, и в неё, по словам разработчиков, вернулись баги, которые в оригинале починили годы назад: то сломанный структурированный вывод, то падения на мультимодальных моделях. Автор llama.cpp Георгий Герганов прямо говорил про «плохие изменения в GGML» со стороны Ollama.
Обёртка над llama.cpp - и год без упоминания
Отдельная история про то, как Ollama относится к движку, на котором стоит. Больше года в их README не было ни слова про llama.cpp - ни в описании, ни на сайте. При этом лицензия llama.cpp (MIT) требует прикладывать уведомление о копирайте и к исходникам, и к бинарникам. В сборках Ollama этого уведомления не было.
Запрос на соблюдение лицензии (issue #3185) провисел больше 400 дней без ответа мейнтейнеров. Строчку про «проект llama.cpp, основанный Георгием Гергановым» в README добавили только после того, как сообщество надавило. Плюс к этому графический интерфейс, который выкатили летом 2025-го, сначала собрали в закрытом репозитории и выложили без лицензии. Мелочи, но из них складывается отношение: берут чужой открытый труд и не спешат это признавать.
Дырка с токеном: CVE-2025-51471
Была у Ollama и конкретная уязвимость с утечкой токена. В версии 0.6.7 нашли CVE-2025-51471: если тебя заманить скачать модель с вредоносного реестра, Ollama могла отправить свой токен авторизации на чужой сервер. Дальше этим токеном можно лезть в твои приватные модели, а при правах на запись - и подсовывать вредоносные модели от твоего имени. Оценка серьёзности - 6,9 из 10, дыру закрыли патчем.
Сама по себе одна залатанная CVE - не приговор, они бывают у всех. Но в связке с тем, что при переходе на облачный режим Ollama отправляет твои промпты сторонним провайдерам без внятного предупреждения, вырисовывается общий мотив: важные для приватности вещи происходят по умолчанию и без явного согласия.
Когда Ollama всё-таки норм
Честно про обратную сторону. Если тебе надо за минуту поднять небольшую модель на ноутбуке, поиграться, проверить идею или показать коллеге, что локальный ИИ вообще работает, - Ollama справляется отлично, и городить что-то сложнее нет смысла.
Проблемы всплывают, когда ставки растут: длинные диалоги и документы (тот самый контекст), выжимание максимума скорости из видеокарты, тонкий подбор кванта под свою память, продакшен, где важно точно знать, какая модель и с какими настройками отвечает. Как только это становится важным, удобные умолчания начинают мешать, и пора смотреть на инструменты, которые дают контроль.
Чем заменить
Хорошая новость: живых альтернатив хватает, и переезжать не больно.
- llama.cpp - тот самый движок, поверх которого работает Ollama. Умеет отдавать OpenAI-совместимый API и веб-интерфейс через
llama-server, лицензия MIT, сотни контрибьюторов. Чуть больше ручной настройки, зато полный контроль и максимальная скорость. - LM Studio - если хочется удобный графический интерфейс. Проприетарный, но честно указывает, на чём работает, и жуёт любой GGUF-файл, который ты сам скачал с Hugging Face.
- Jan - полностью открытый чат-клиент под локальные модели, для тех, кому важна прозрачность.
- llamafile - проект Mozilla: модель и движок в одном исполняемом файле, скачал и запустил без установки.
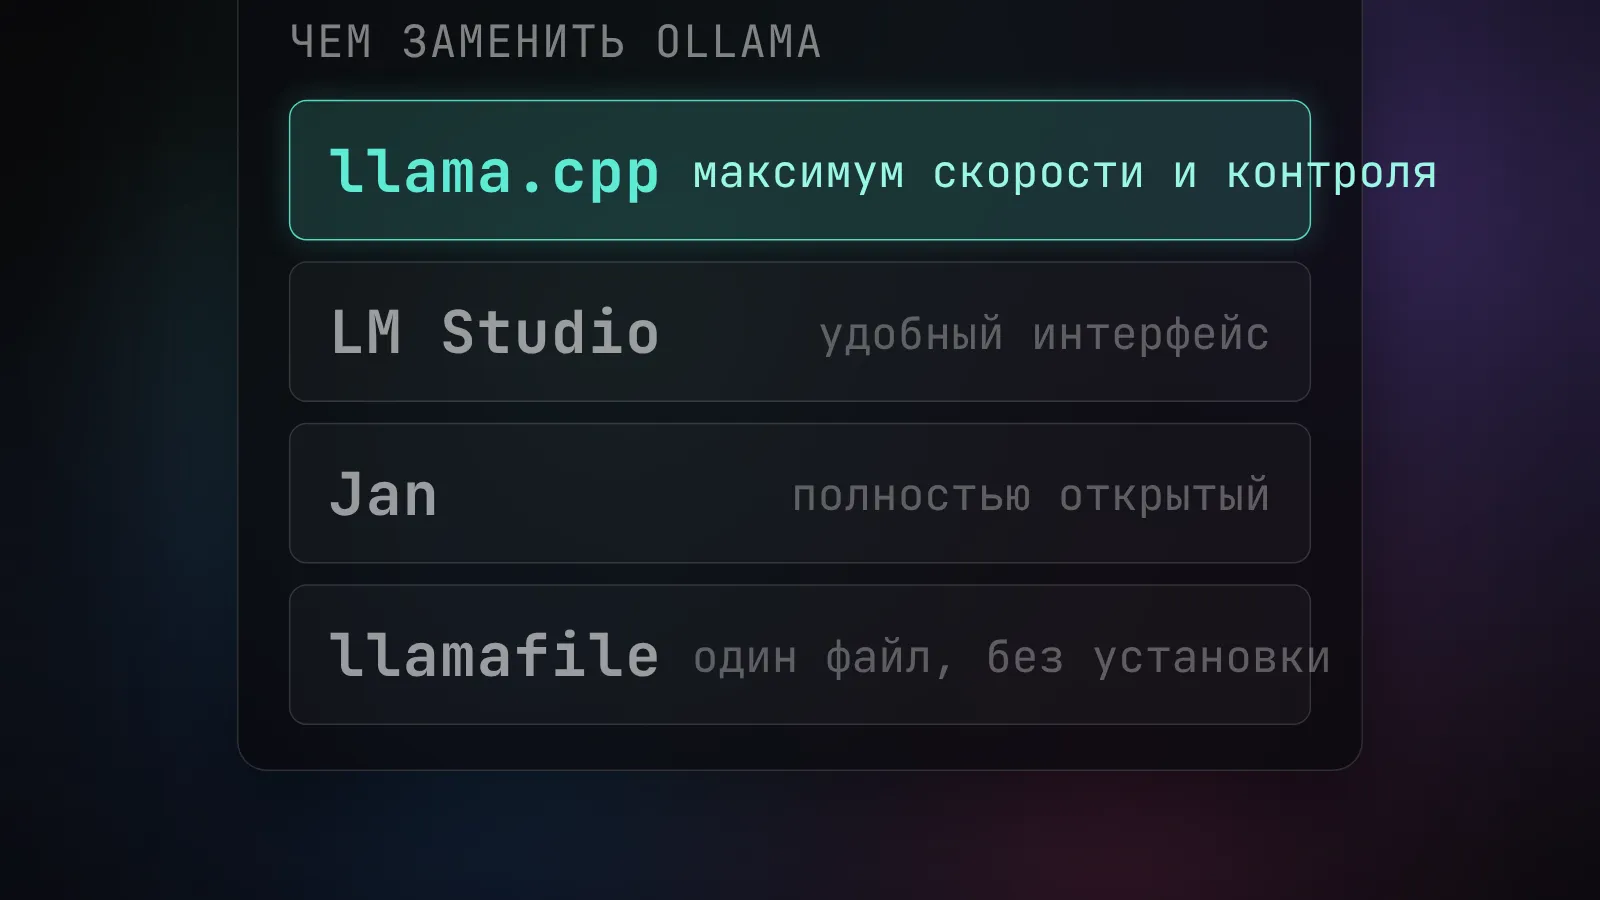
Логика выбора простая. Нужен максимум скорости и контроля - llama.cpp напрямую. Нужен удобный интерфейс без возни в терминале - LM Studio. Важна открытость - Jan. Нужно запустить без установки на чужой машине - llamafile. Во всех случаях модели ты качаешь стандартным GGUF с Hugging Face, а не привязываешься к чужому хранилищу с хешами вместо имён.
Ollama сделала важное дело: показала тысячам людей, что нейросеть работает прямо на твоём компьютере, без облака и подписки. За это ей спасибо. Но «просто работает» и «работает так, как ты думаешь» - это разные вещи. Теперь ты знаешь, где Ollama решает за тебя, и чем её заменить, когда эти решения перестают устраивать.
Источники
- Friends Don't Let Friends Use Ollama (Sleeping Robots) - подробный разбор: скорость 161 против 89 токенов/с, форк движка, лицензия, форматы квантов, Modelfile.
- Обсуждение на r/LocalLLaMA - 751 плюс, 259 комментариев, реакция сообщества.
- Ollama defaults to a context of 2048 (Hacker News) - умолчание 2048 токенов и молчаливая обрезка.
- DeepSeek R1 Distilled Models in Ollama: Not What You Think (Towards AI) - путаница дистилляций и полной модели.
- Ollama doesn't distribute notice licenses (issue #3185) - запрос на соблюдение лицензии llama.cpp, 400+ дней без ответа.
- CVE-2025-51471 (Wiz) - утечка токена, версия 0.6.7, оценка 6,9, патч.